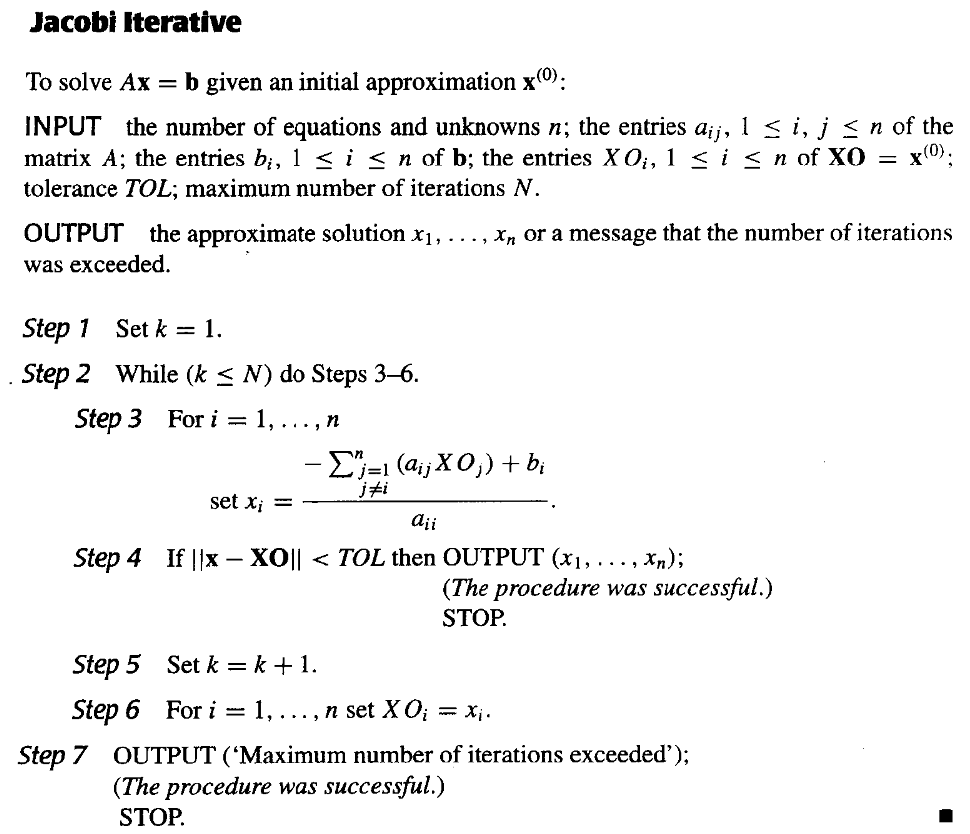
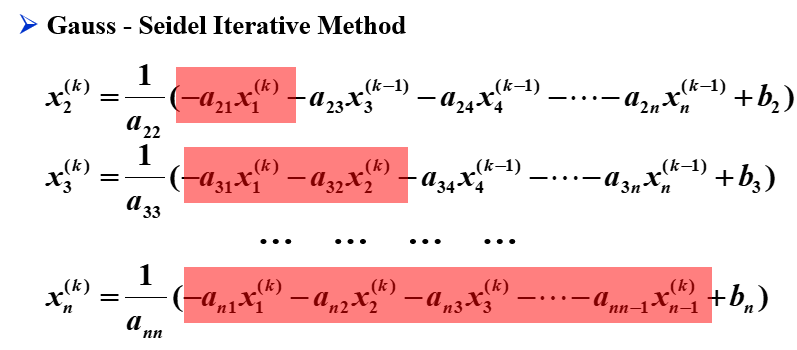
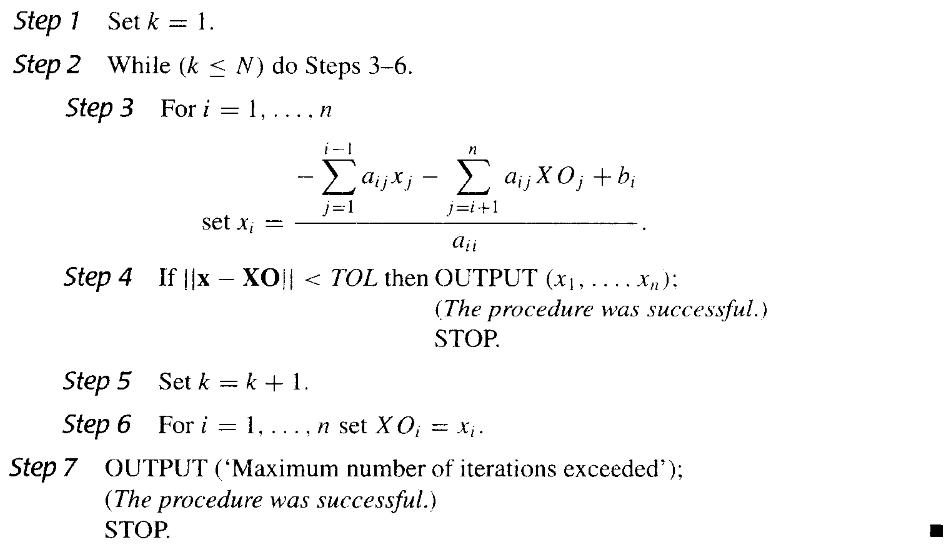
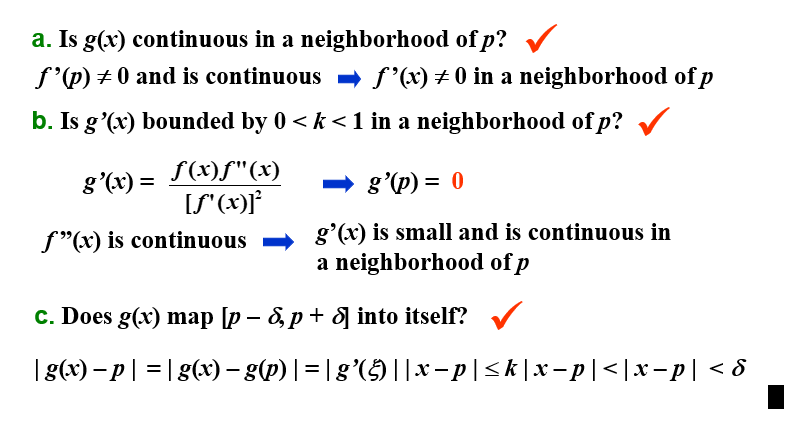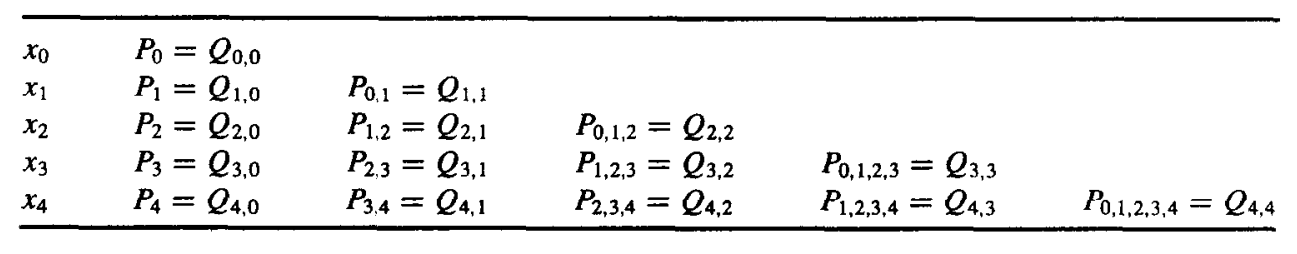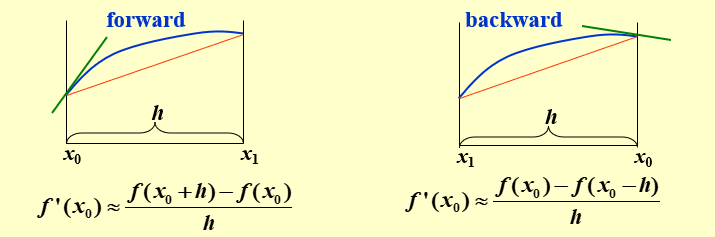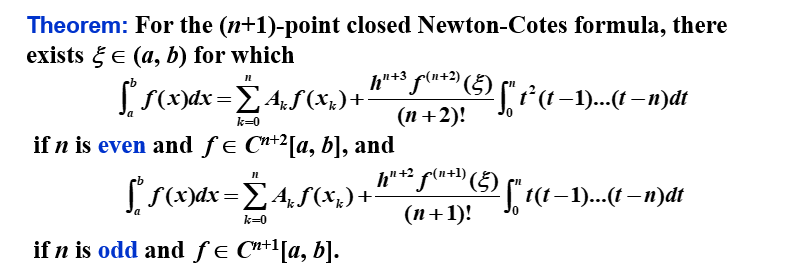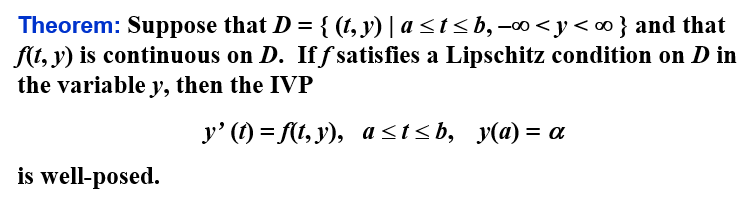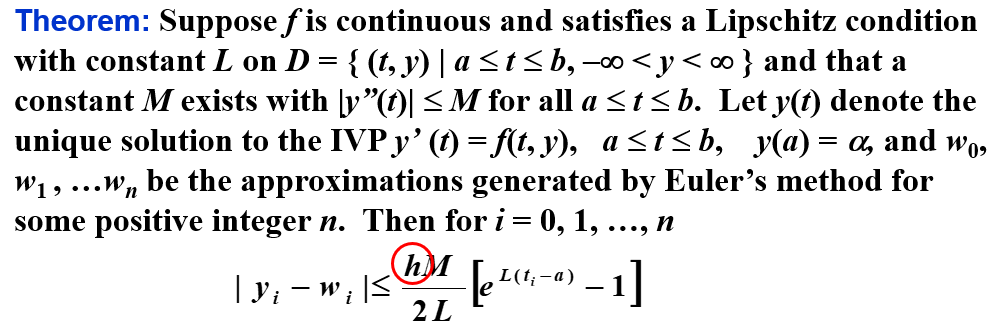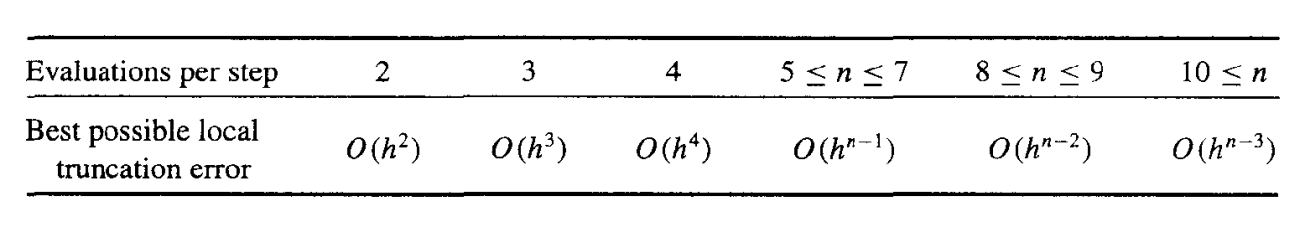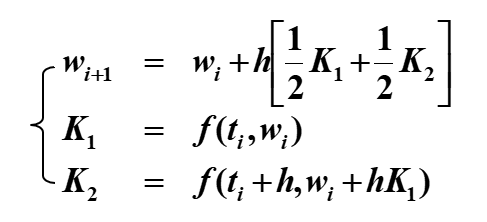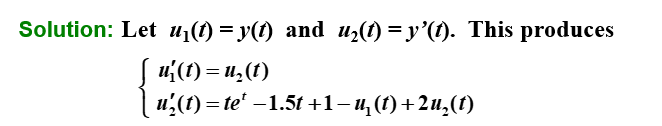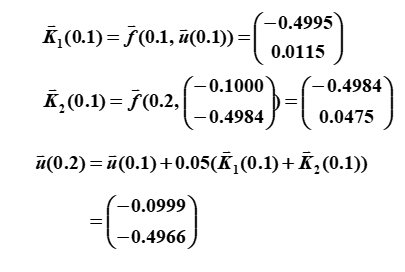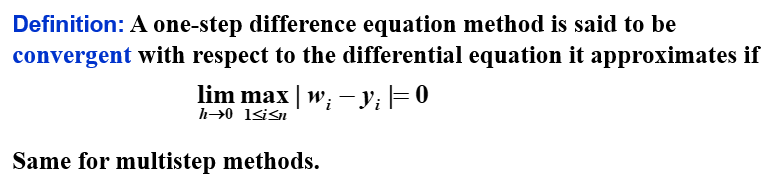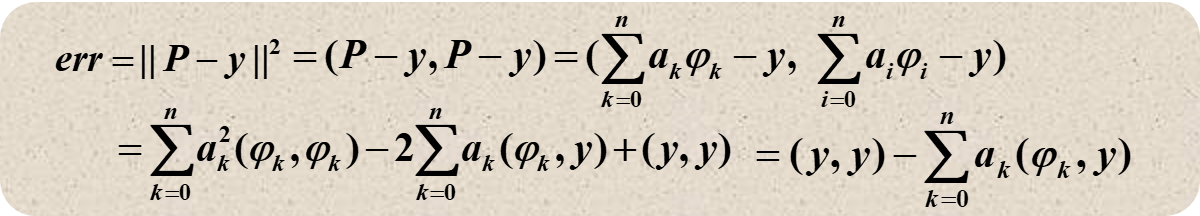数值分析

"课程架构"

"Basic Knowledge"

  • Chapter 1
    • Mean value theorem
    • Taylor expansion
    • Roundoff error

"Solution of Equations"

  • Chapter 2
    • Solution of equations with one variable
  • Chapter 6
    • Direct Matrix Solver
  • Chapter 7
    • Iterative Matrix Solver
  • Chapter 5
    • Initial value problem
      • Euler, Runge-kutta, multi-step

Convergence + Stability

"Interpolation and approximation"

  • Chapter 3: interpolation

    • Lagrange polynomial
    • Piecewise polynomial
  • Chapter 4

    • Numerical differentiation
    • Numerical integration
  • Chapter 8: approximation

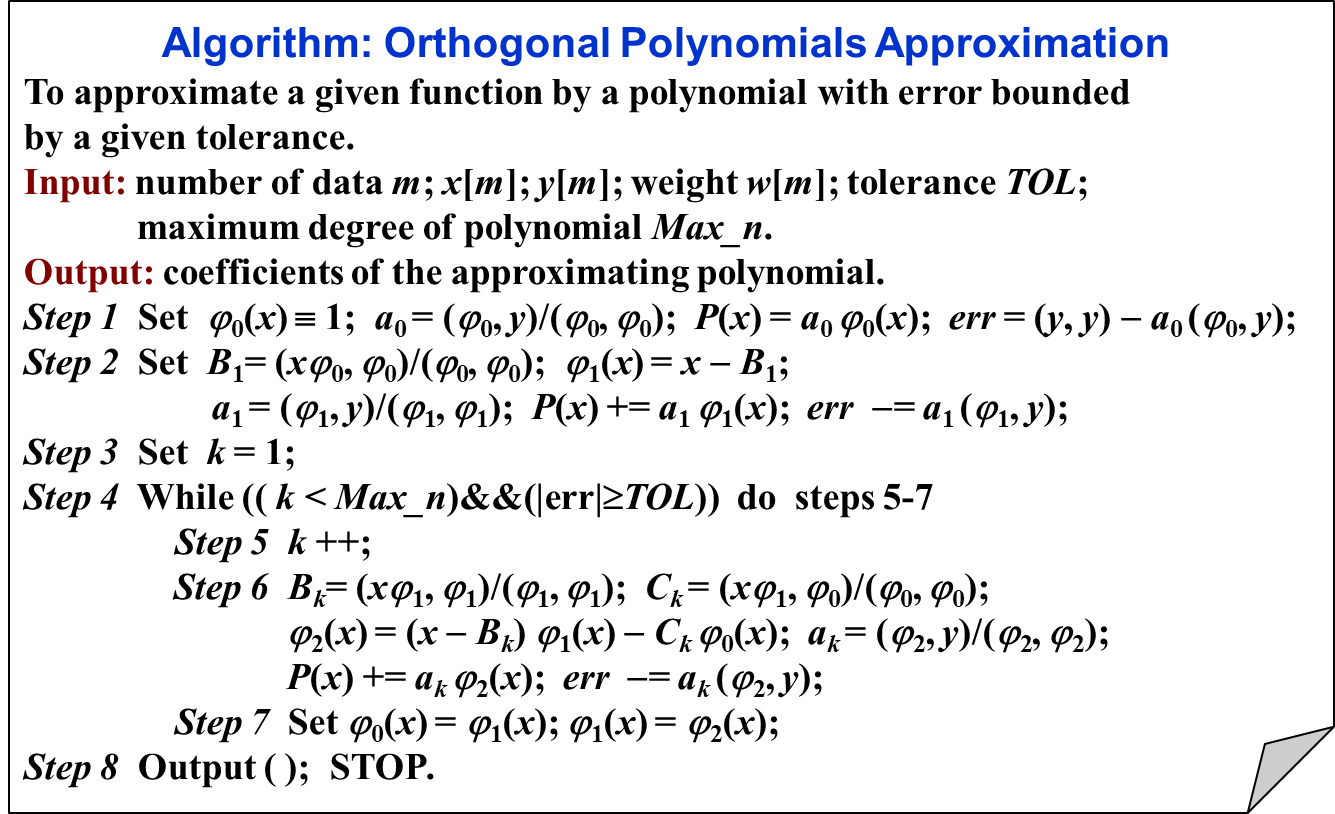
    • Orthogonal polynomials
    • Least squares
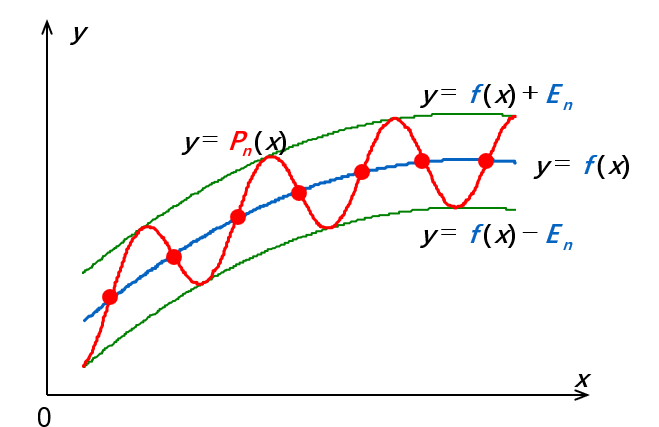
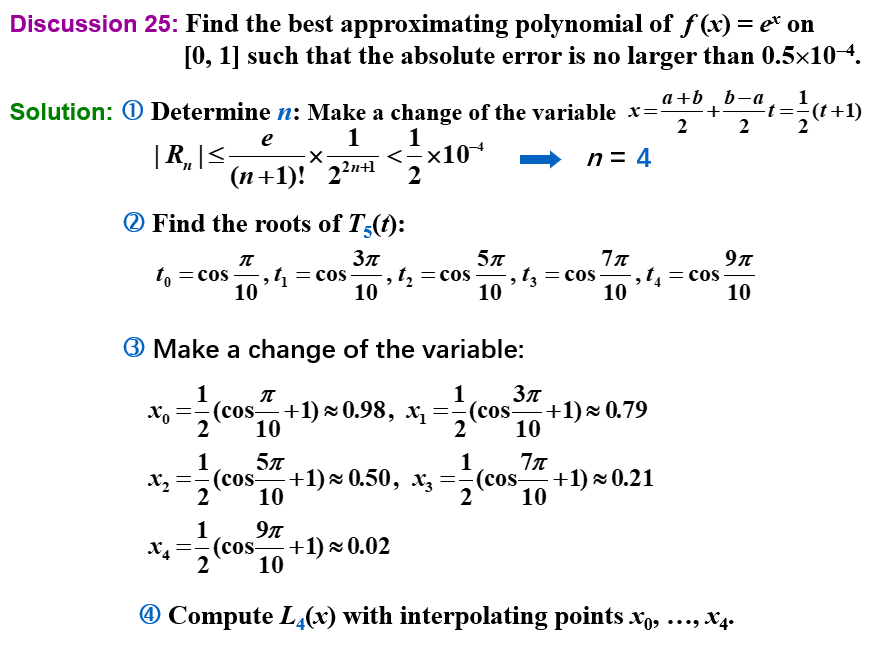
    • Chebyshev polynomial

Error

Chapter 1 数学基础 | Mathematical Preliminaries

"本讲概述"

本讲主要介绍数值计算中的误差类型和误差分析,以及IEEE 754浮点数表示。

1.2 舍入误差和计算机算术 | Roundoff Errors and Computer Arithmetic

1.2.1 截断误差和舍入误差 | Truncation Error and Roundoff Error

1.2.2 截断法和舍入法 | Chopping and Rounding

使用舍入法或截断法产生的误差都叫做舍入误差。

"函数表示"

Given a real number y=0.d1d2d3…dkdk+1…×10ny = 0.d_1d_2d_3\ldots d_kd_{k+1}\ldots \times 10^n(which is called Normalized decimal floating-point form of a real number)

fl(y)={0.d1d2d3…dk×10n/* chopping */chop(y+5×10n−(k+1))/* rounding */fl(y) = \begin{cases} 0.d_1d_2d_3\ldots d_k \times 10^n& \text{/* chopping */} \\ chop(y + 5 \times 10^{n-(k+1)}) & \text{/* rounding */} \end{cases}

1.2.3 绝对误差与相对误差 | Absolute error and relative error

Denote p∗p^* as the approximation of pp.

"近似产生的误差"

chopping:

∣y−fl(y)∣∣y∣=0.dk+1dk+2…×10n−k0.d1d2d3…dk×10n=0.dk+1dk+2…0.d1d2d3…dk×10−k<10.1×10−k=10−k+1\frac{|y - fl(y)|}{|y|} = \frac{0.d_{k+1}d_{k+2}\ldots \times 10^{n-k}}{0.d_1d_2d_3\ldots d_k \times 10^n} = \frac{0.d_{k+1}d_{k+2}\ldots}{0.d_1d_2d_3\ldots d_k} \times 10^{-k} < \frac{1}{0.1} \times 10^{-k} = 10^{-k+1}

Rounding:

∣y−fl(y)∣∣y∣≤0.5×10n−k0.d1d2d3…dk×10n=0.50.1×10−k=0.5×10−k+1\frac{|y - fl(y)|}{|y|} \leq \frac{0.5 \times 10^{n-k}}{0.d_1d_2d_3\ldots d_k \times 10^n} = \frac{0.5}{0.1} \times 10^{-k} = 0.5 \times 10^{-k+1}

"误差产生"

  • 两个近乎相等的数相减二导致有效数字的相消,例如:a=0.123456789,b=0.123456788a=0.123456789, b=0.123456788,两者本来有9位有效数字,但是相减后只剩下1位有效数字。
  • 如果有限位的表示或计算产生了误差,则除以一个小数(或者乘以一个大数)会放大绝对误差。

误差计算举例:

Evaluate f(x)=x3−6.1x2+3.2x+1.5f(x) = x^3 - 6.1x^2 + 3.2x + 1.5 at x=4.71x = 4.71 using 3-digit arithmetic(3位有效数字).

xx x2x^2 x3x^3 6.1x26.1x^2 3.2x3.2x
exact 4.714.71 22.184122.1841 104.487111104.487111 135.32301135.32301 15.07215.072
Chopping 4.714.71 22.122.1 104.104. 6.1∗22.1=134.81≈134.6.1*22.1=134.81\approx134. 15.015.0
Rounding 4.714.71 22.222.2 105.105. 6.1∗22.2=135.42≈135.6.1*22.2=135.42\approx135. 15.115.1

Exact value: f(4.71)=104.487111−135.32301+15.072+1.5=−14.263899f(4.71) = 104.487111 - 135.32301 + 15.072 + 1.5 = -14.263899

Chopping: f(4.71)=104−134+15.0+1.5=−13.5f(4.71) = 104 - 134 + 15.0 + 1.5 = -13.5

Rounding: f(4.71)=105−135+15.1+1.5=−13.4f(4.71) = 105 - 135 + 15.1 + 1.5 = -13.4

可见,有时候舍入误差比截断误差更大。

但现在的误差还是太大了!介绍——秦九韶算法!

乘法较多会导致式子的误差较大,此时可以使用秦九韶算法(其实就是不断提取xx)来减少乘法的次数。

把一个多项式f(x)=anxn+an−1xn−1+…+a1x+a0f(x) = a_nx^n + a_{n-1}x^{n-1} + \ldots + a_1x + a_0写成如下形式:

f(x)=((…(anx+an−1)x+an−2)x+…)x+a1)x+a0f(x) = ((\ldots(a_nx + a_{n-1})x + a_{n-2})x + \ldots)x + a_1)x + a_0

然后从最内层开始计算。

将上例改写成秦九韶算法:

f(x)=((x−6.1)x+3.2)x+1.5f(x) = ((x-6.1)x + 3.2)x + 1.5

Chopping:

((4.71−6.1)4.71+3.2)4.71+1.5=(−1.39∗4.71+3.2)4.71+1.5=(−6.54+3.2)4.71+1.5=−3.34∗4.71+1.5=−15.7+1.5=−14.2\begin{aligned} &((4.71-6.1)4.71 + 3.2)4.71 + 1.5 \\ =& (-1.39*4.71 + 3.2)4.71 + 1.5 \\ =& (-6.54 + 3.2)4.71 + 1.5 \\ =& -3.34*4.71 + 1.5 \\ =& -15.7 + 1.5 \\ =& -14.2 \end{aligned}

Relative error: ∣−14.263899+14.2∣∣−14.263899∣≈0.44%\frac{|-14.263899 + 14.2|}{|-14.263899|} \approx 0.44\%

Rounding:

((4.71−6.1)4.71+3.2)4.71+1.5=(−1.39∗4.71+3.2)4.71+1.5=(−6.55+3.2)4.71+1.5=−3.35∗4.71+1.5=−15.8+1.5=−14.3\begin{align*} &((4.71-6.1)4.71 + 3.2)4.71 + 1.5 \\ =& (-1.39*4.71 + 3.2)4.71 + 1.5 \\ =& (-6.55 + 3.2)4.71 + 1.5 \\ =& -3.35*4.71 + 1.5 \\ =& -15.8 + 1.5 \\ =& -14.3 \end{align*}

Relative error: ∣−14.263899+14.3∣∣−14.263899∣≈0.25%\frac{|-14.263899 + 14.3|}{|-14.263899|} \approx 0.25\%

可见,此时误差明显减小了。

1.3 算法和收敛性 | Algorithms and Convergence

稳定性 | Stability

一个算法,如果初始数据的小变化会导致最终结果的小变化,则称为稳定(stable);否则称为不稳定(unstable)。

一个算法,如果只有在某些初始数据的选择下才是稳定的,则称为条件稳定(conditionally stable)。

误差增长 | The growth of errors

假设E0>0E_0 > 0是初始误差(initial error),EnE_n是第nn步的误差。

线性增长的误差通常是无法避免的,当CC和E0E_0都很小的时候,结果通常是可以接受的。

指数增长的误差应该避免,因为即使E0E_0很小,CnC^n也会变得很大。这会导致不可接受的不准确性。

收敛速度 | Convergence rate

使用OO符号来表示收敛速度。

假设lim⁡h→0F(h)=L\lim_{h\to 0} F(h) = L,lim⁡h→0G(h)=0\lim_{h\to 0} G(h) = 0。如果存在正常数KK使得

∣F(h)−L∣≤K∣G(h)∣|F(h)-L| \leq K|G(h)|

对于足够小的hh成立,则记为F(h)=L+O(G(h))F(h)=L+O(G(h))

我们通常取G(h)=hp,(p>0)G(h)=h^p,(p>0),并对最大的pp值感兴趣。

"求当h→0h\to 0时下列函数的收敛速度"

F(h)=sin⁡hhF(h) = \frac{\sin h}{h}, lim⁡h→0sin⁡hh=1\lim_{h\to 0}\frac{\sin h}{h} = 1

解: F(h)−L=sin⁡hh−1=sin⁡h−hh∼h−h36+o(h3)−hh∼−h26≤K∣h2∣F(h)-L=\frac{\sin h}{h}-1 = \frac{\sin h-h}{h} \sim \frac{h-\frac{h^3}{6}+o(h^3)-h}{h} \sim-\frac{h^2}{6}\leq K|h^2|

所以收敛速度为O(h2)O(h^2)。

1.4 IEEE 754 FLOATING POINT REPRESENTATION

二进制的科学计数法:x=±1.d1d2d3…dk×2nx = \pm 1.d_1d_2d_3\ldots d_k \times 2^n,这里的did_i是二进制的数字,1.d1d2d3…dk1.d_1d_2d_3\ldots d_k为有效位数(Significand)。

在计算机里有两种表示方法,分别是Single(32位)和double(64位)。均为下图的形式。

二进制

x=(−1)S×(1+Fraction)×2Exponent−Biasx = (-1)^S \times (1+Fraction) \times 2^{Exponent-Bias}

  • SS代表符号位(sign bit)。SS为00表示非负数,SS为11表示负数。
  • 有效位数(Significand=1+FractionSignificand = 1 + Fraction) 中11是默认的,我们只存储小数点后面的位数(即Fraction)。
  • FractionFraction 代表尾数部分(也称作mantissa)。
    • Single: 2323 bitsbits
    • Double: 5252 bitsbits
  • ExponentExponent 表示指数部分(也称作characteristic)。
    • Single: 88 bitsbits
    • Double: 1111 bitsbits
    • excess representation(偏移表示法) == actual exponent −- bias,其中:
      • Single: bias=127bias = 127 bitsbits
      • Double: bias=1023bias = 1023 bitsbits
    • 指数为全 00 和全 11 时用作特殊值处理

"Single & Double的值域"

"Single的值域"

  • 最小值:

  • Exponent = 00000001, Fraction = 000...000

  • x=±(1+0.0)×21−127=±1.0×2−126≈±1.2×10−38x = \pm (1+0.0) \times 2^{1-127} = \pm 1.0 \times 2^{-126} \approx \pm 1.2 \times 10^{-38}

  • 最大值:

  • Exponent = 11111110, Fraction = 111...111

  • x=±(1+0.111…111)×2254−127≈±2.0×2127≈±3.4×1038x = \pm (1+0.111\ldots 111) \times 2^{254-127} \approx \pm 2.0 \times 2^{127} \approx \pm 3.4 \times 10^{38}

"Double的值域"

  • 最小值:

  • Exponent = 00000000001, Fraction = 000...000

  • x=±(1+0.0)×21−1023=±1.0×2−1022≈±2.2×10−308x = \pm (1+0.0) \times 2^{1-1023} = \pm 1.0 \times 2^{-1022} \approx \pm 2.2 \times 10^{-308}

  • 最大值:

  • Exponent = 11111111110, Fraction = 111...111

  • x=±(1+0.111…111)×22046−1023≈±2.0×21023≈±1.8×10308x = \pm (1+0.111\ldots 111) \times 2^{2046-1023} \approx \pm 2.0 \times 2^{1023} \approx \pm 1.8 \times 10^{308}

"Single & Double的十进制精度"

"Single的十进制精度"

  • 最小分度: 2−232^{-23}
  • log⁡102−23≈−6.92\log_{10}{2^{-23}}\approx -6.92
  • 所以约为小数点后六位有效数字

"Double的值域"

  • 最小分度: 2−522^{-52}
  • log⁡102−52≈−15.65\log_{10}{2^{-52}}\approx -15.65
  • 所以约为小数点后十六位有效数字

"十进制->IEEE754 浮点数"

"Represent –0.75–0.75"

  1. Convert to binary: 0.75=0.110.75 = 0.11
  2. Normalize: 0.11=1.1×2–10.11 = 1.1 × 2^{–1}
  3. Sign bit: S=1S = 1
  4. Exponent:
    • Single: –1+127=126=01111110–1 + 127 = 126 = 01111110
    • Double: –1+1023=1022=01111111110–1 + 1023 = 1022 = 01111111110
  5. Fraction:
    • Single: 0.1=100⋯000.1 = 100\cdots 00,共23位
    • Double: 0.1=100⋯000000.1 = 100\cdots 00000,共52位
      ∴\therefore IEEE 754 Representation:
    • Single: 1 01111110 100⋯001\ 01111110\ 100\cdots 00
    • Double: 1 01111111110 100⋯000001\ 01111111110\ 100\cdots 00000

"IEEE754 浮点数->十进制"

"What number is represented by the single-precision float 11000000101000…00"

  1. Sign bit: S=1S = 1
  2. Exponent: E=10000001=129E = 10000001 = 129
  3. Actual exponent: E−127=2E - 127 = 2
  4. Fraction: 01000⋯0001000\cdots 00
  5. Significand: 1.01000⋯00=1.251.01000\cdots 00 = 1.25
  6. ∴\therefore Number: –1.25×22=–5.0–1.25 × 2^2 = –5.0

Chapter 2 一元方程的求解 | Solutions of Equations in One Variable

2.0 停机程序 | Stopping procedure

我们可以选择一个精度要求ϵ\epsilon,逐步迭代,直到满足下列条件之一:

  1. ∣xi+1−xi∣<ϵ|x_{i+1} - x_i| < \epsilon
  2. ∣f(xi+1)∣<ϵ|f(x_{i+1})| < \epsilon
  3. ∣xi+1−xi∣∣xi+1∣<ϵ\frac{|x_{i+1} - x_i|}{|x_{i+1}|} < \epsilon

如果∣xi+1−xi∣|x_{i+1} - x_i|收敛于0而序列本身发散 ,1号会失效。

也有可能f(x)f(x)与0很接近,但是xnx_n与xx差别很大,2号也不行了。

3号条件是能运用的最好的停机准则,因为它最接近测试相对误差。

2.1 二分法 | Bisection Method
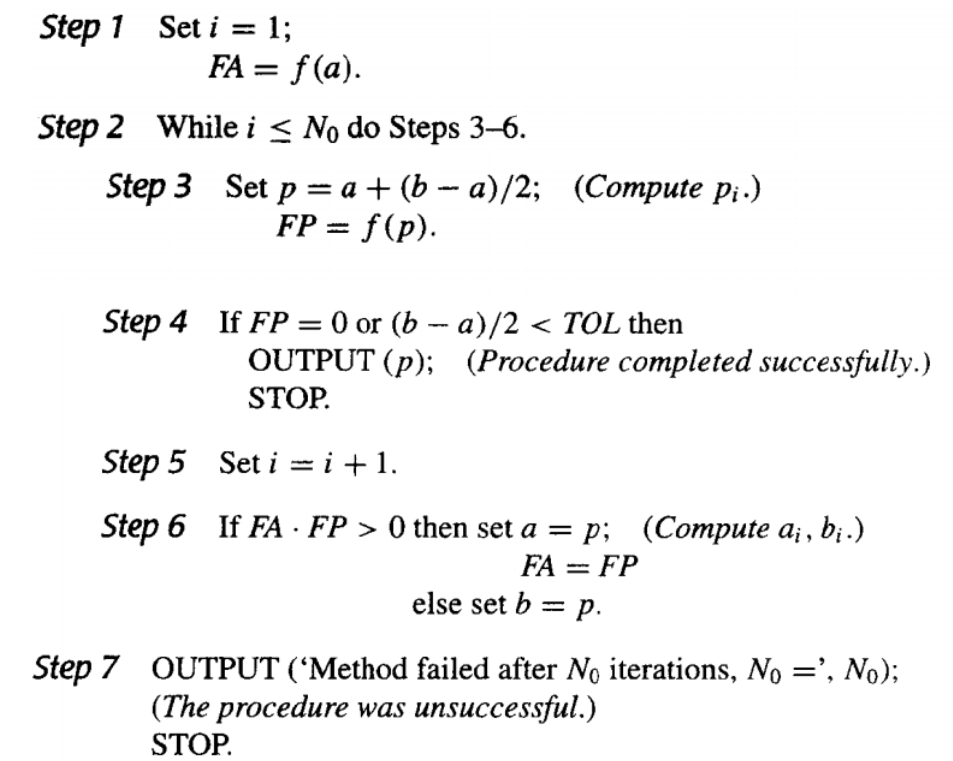
Bisection Method

"为什么要用a+(b-a)/2,而不用(b+a)/2?"

  1. 因为a和b可能是很大的数,相加可能会溢出。
  2. 因为a和b可能是很小的数,相加可能会产生舍入误差。用此方法可以确保a+(b-a)/2落在a和b之间。
    1. 例如,用截断保留2位有效数字,a=0.91,b=0.93,(a+b)/2=1.8/2=0.9,而a+(b-a)/2=0.91+(0.93-0.91)/2=0.92。

2.2 不动点迭代 | Fixed-Point Iteration
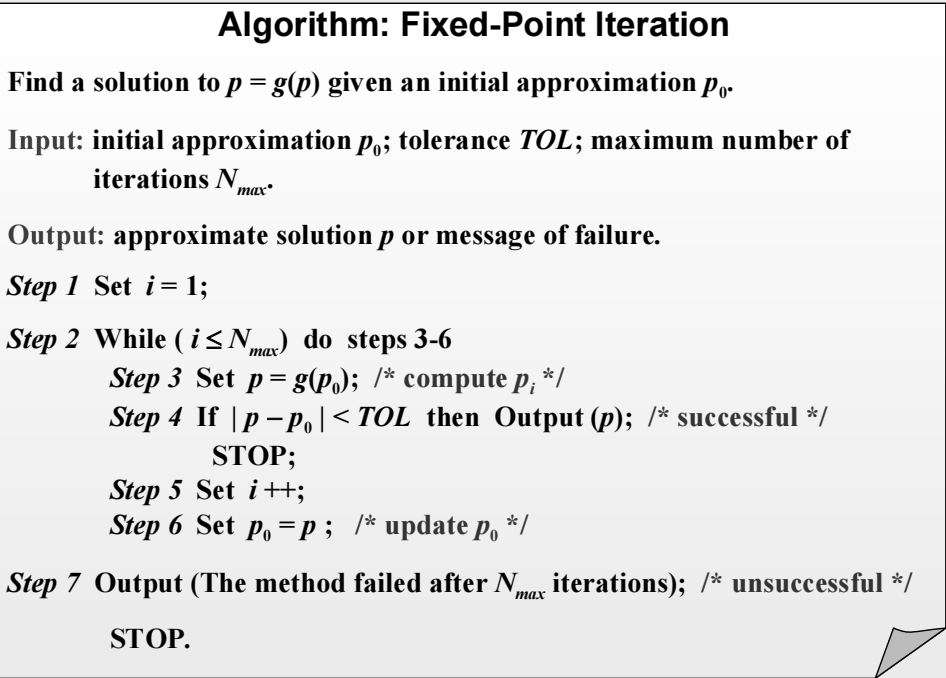
Fixed-Point Iteration

不动点的存在性和唯一性的充分条件:

a. g∈C[a,b]g\in C[a,b]且g(x)∈[a,b],∀x∈[a,b]g(x)\in [a,b], \forall x\in [a,b],则gg在[a,b][a,b]上有不动点。

b. ∣g′(x)∣≤k<1,∀x∈(a,b)|g'(x)|\leq k < 1, \forall x\in (a,b),则该不动点是唯一的。

则对于任意p0∈[a,b]p_0\in [a,b],不动点迭代序列pn+1=g(xn)p_{n+1}=g(x_n)收敛于不动点。

且我们有误差限∣pn−p∣≤kn1−k∣p1−p0∣|p_n-p| \leq \frac{k^n}{1-k}|p_1-p_0|,这将收敛速率和一阶导数的界联系起来。

"误差界分析"

∣pn+1−pn∣=∣g(pn)−g(pn−1)∣=∣g′(ξ)∣∣pn−pn−1∣≤k∣pn−pn−1∣≤k2∣pn−1−pn−2∣≤…≤kn∣p1−p0∣\begin{align*} |p_{n+1}-p_n| &= |g(p_n)-g(p_{n-1})| = |g'(\xi)||p_n-p_{n-1}| \leq k|p_n-p_{n-1}| \\ &\leq k^2|p_{n-1}-p_{n-2}| \leq \ldots \leq k^n|p_1-p_0| \end{align*}

∣pn−p∣=∣pn−pn−1+pn−1−pn−2+…+p1−p0∣≤∣pn−pn−1∣+∣pn−1−pn−2∣+…+∣p1−p0∣≤(kn−1+kn−2+…+1)∣p1−p0∣=kn−1k−1∣p1−p0∣≤kn1−k∣p1−p0∣\begin{align*} |p_{n}-p| &= |p_{n}-p_{n-1}+p_{n-1}-p_{n-2}+\ldots+p_1-p_0| \\ &\leq |p_{n}-p_{n-1}|+|p_{n-1}-p_{n-2}|+\ldots+|p_1-p_0| \\ &\leq (k^{n-1}+k^{n-2}+\ldots+1)|p_1-p_0| \\ &= \frac{k^n-1}{k-1}|p_1-p_0| \leq \frac{k^n}{1-k}|p_1-p_0| \end{align*}

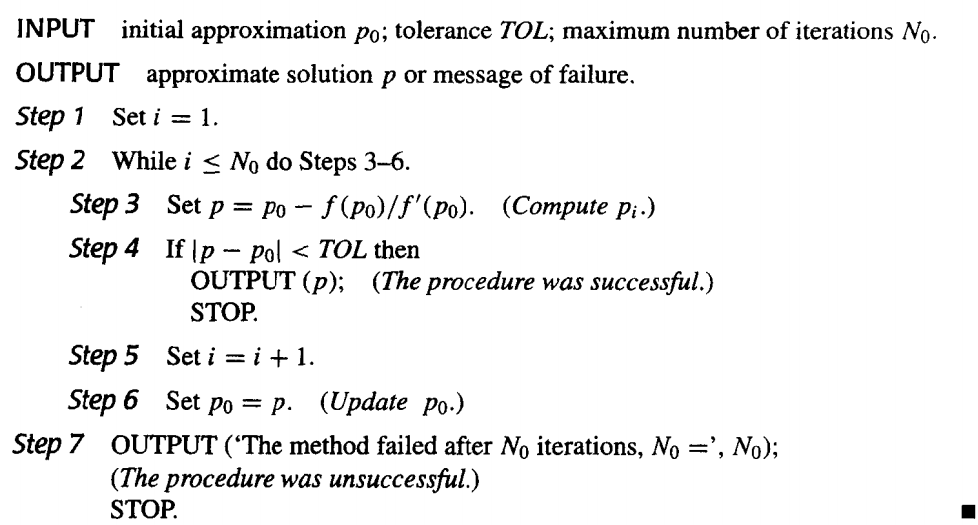
2.3 牛顿迭代法 | Newton's Method

就是用切线逼近零点,然后求切线与x轴的交点,作为下一个点,如此往复。

xn+1=xn−f(xn)f′(xn)x_{n+1} = x_n - \frac{f(x_n)}{f'(x_n)}

Newton

"定理:设f∈C2[a,b]f\in C^2[a,b],如果p∈[a,b]p\in [a,b]满足f(p)=0f(p)=0且f′(p)≠0f'(p)\neq 0,则存在δ>0\delta>0,使得对任何初始值p0∈(p−δ,p+δ)p_0\in (p-\delta, p+\delta),牛顿迭代法产生收敛于pp的序列{pn}n=1∞\{p_n\}_{n=1}^\infty。"

证明:

Alt text

牛顿迭代法的收敛性取决于初始近似值的选择。

2.4 迭代法的误差分析 | Error Analysis for Iterative Methods

假设{pn}n=0∞\{p_n\}_{n=0}^\infty收敛于pp,其中对∀pn≠p\forall p_n \neq p。如果存在正数λ\lambda和α\alpha,使得

lim⁡n→∞∣pn+1−p∣∣pn−p∣α=λ\lim_{n\to\infty}\frac{|p_{n+1}-p|}{|p_n-p|^\alpha} = \lambda

则称{pn}n=0∞\{p_n\}_{n=0}^\infty是α\alpha阶收敛的(converges to p of order α),λ\lambda称为渐进误差常数(asymptotic error constant)。

一般具有高阶收敛性的序列收敛速度更快。

不动点法

不动点法的收敛阶和渐进误差常数:

pn+1−p=g(pn)−g(p)=g′(ξ)(pn−p)⇒∣pn+1−p∣∣pn−p∣=∣g′(ξ)∣⇒lim⁡n→∞∣pn+1−p∣∣pn−p∣=lim⁡n→∞∣g′(ξ)∣=∣g′(p)∣\begin{aligned} p_{n+1}-p = g(p_n)-g(p) = g'(\xi)(p_n-p) &\Rightarrow \frac{|p_{n+1}-p|}{|p_n-p|} = |g'(\xi)|\\ &\Rightarrow \lim_{n\to\infty}\frac{|p_{n+1}-p|}{|p_n-p|} = \lim_{n\to\infty}|g'(\xi)| = |g'(p)| \end{aligned}

因此,如果g′(p)≠0g'(p)\neq 0,则不动点迭代法是线性收敛的,且渐进误差常数为∣g′(p)∣|g'(p)|。

牛顿迭代法

牛顿迭代法的收敛阶和渐进误差常数:

由泰勒展开:

0=f(p)=f(pn)+f′(pn)(p−pn)+f′′(ξ)2(p−pn)2⇒p=pn−f(pn)f′(pn)−f′′(ξ)2f′(pn)(p−pn)2⇒lim⁡n→∞∣pn+1−p∣∣pn−p∣2=lim⁡n→∞∣f′′(ξ)∣2∣f′(pn)∣=∣f′′(p)∣2∣f′(p)∣\begin{aligned} 0 &= f(p) = f(p_n) + f'(p_n)(p-p_n) + \frac{f''(\xi)}{2}(p-p_n)^2\\ &\Rightarrow p = p_n-\frac{f(p_n)}{f'(p_n)} - \frac{f''(\xi)}{2f'(p_n)}(p-p_n)^2\\ &\Rightarrow \lim_{n\to\infty}\frac{|p_{n+1}-p|}{|p_n-p|^2} = \lim_{n\to\infty}\frac{|f''(\xi)|}{2|f'(p_n)|} = \frac{|f''(p)|}{2|f'(p)|} \end{aligned}

因此,牛顿迭代法是二次收敛的,且渐进误差常数为∣f′′(p)∣2∣f′(p)∣\frac{|f''(p)|}{2|f'(p)|}。

不动点法的多重根情况

如果pp是g(x)g(x)的不动点,存在正整数mm,使得g′(p)=g′′(p)=…=g(m−1)(p)=0g'(p)=g''(p)=\ldots=g^{(m-1)}(p)=0,且g(m)(p)≠0g^{(m)}(p)\neq 0,则称pn=g(pn−1)p_n = g(p_{n-1})以阶mm收敛于pp,渐进误差常数为∣g(m)(p)∣m!\frac{|g^{(m)}(p)|}{m!}。

pn+1=g(pn)=g(p)+g′(p)(pn−p)+g′′(ξ)2(pn−p)2+…+g(m)(ξ)m!(pn−p)m⇒lim⁡n→∞∣pn+1−p∣∣pn−p∣m=lim⁡n→∞∣g(m)(ξ)∣m!=∣g(m)(p)∣m!\begin{aligned} p_{n+1} &= g(p_n) = g(p) + g'(p)(p_n-p) + \frac{g''(\xi)}{2}(p_n-p)^2 + \ldots + \frac{g^{(m)}(\xi)}{m!}(p_n-p)^m\\ &\Rightarrow \lim_{n\to\infty}\frac{|p_{n+1}-p|}{|p_n-p|^m} = \lim_{n\to\infty}\frac{|g^{(m)}(\xi)|}{m!} = \frac{|g^{(m)}(p)|}{m!} \end{aligned}

牛顿法的多重根情况

如果pp是ff的mm重零点,则有f(x)=(x−p)mq(x)f(x)=(x-p)^mq(x),记g(x)=x−f(x)f′(x)g(x)=x-\frac{f(x)}{f'(x)},牛顿法即为 pn=g(pn−1)p_n=g(p_{n-1})

g′(x)=1−f′(x)2−f(x)f′′(x)(f′(x))2=f(x)f′′(x)(f′(x))2=(x−p)mq(x)(m(m−1)(x−p)m−2q(x)+2m(x−p)m−1q′(x)+q′′(x)(x−p)m)(m(x−p)m−1q(x)+q′(x)(x−p)m)2=(x−p)2m−2q(x)(m(m−1)q(x)+2m(x−p)q′(x)+q′′(x)(x−p)2)(x−p)2m−2(mq(x)+q′(x)(x−p))2=q(x)(m(m−1)q(x)+2m(x−p)q′(x)+q′′(x)(x−p)2)(mq(x)+q′(x)(x−p))2\begin{align*} g'(x) &= 1-\frac{f'(x)^2-f(x)f''(x)}{(f'(x))^2} \\ &= \frac{f(x)f''(x)}{(f'(x))^2} \\ &= \frac{(x-p)^mq(x)(m(m-1)(x-p)^{m-2}q(x)+2m(x-p)^{m-1}q'(x)+q''(x)(x-p)^m)}{(m(x-p)^{m-1}q(x)+q'(x)(x-p)^m)^2} \\ &= \frac{(x-p)^{2m-2}q(x)(m(m-1)q(x)+2m(x-p)q'(x)+q''(x)(x-p)^2)}{(x-p)^{2m-2}(mq(x)+q'(x)(x-p))^2} \\ &= \frac{q(x)(m(m-1)q(x)+2m(x-p)q'(x)+q''(x)(x-p)^2)}{(mq(x)+q'(x)(x-p))^2} \end{align*}

所以

g′(p)=q(p)m(m−1)q(p)(mq(p))2=1−1m<1g'(p)=\frac{q(p)m(m-1)q(p)}{(mq(p))^2}=1-\frac{1}{m}<1

由不动点法的迭代情况可知,此时为线性收敛,不为二次收敛。

牛顿法多重根下的优化

定义

μ(x)=f(x)f′(x)\mu(x)=\frac{f(x)}{f'(x)}

如果pp是ff 的mm重零点,f(x)=(x−p)mq(x)f(x)=(x-p)^mq(x),则

μ(x)=(x−p)mq(x)m(x−p)m−1q(x)+q′(x)(x−p)m=(x−p)q(x)mq(x)+q′(x)(x−p)\mu(x)=\frac{(x-p)^mq(x)}{m(x-p)^{m-1}q(x)+q'(x)(x-p)^m}=\frac{(x-p)q(x)}{mq(x)+q'(x)(x-p)}

又q(p)≠0q(p)\neq 0,且

q(p)mq(p)+q′(p)(p−p)=1m≠0\frac{q(p)}{mq(p)+q'(p)(p-p)}=\frac{1}{m}\neq 0

所以pp是μ(x)\mu(x)的单根,那么我们对μ\mu应用牛顿迭代法,就有

pn+1=g(pn)=pn−μ(pn)μ′(pn)=pn−f(pn)f′(pn)f′(pn)f′(pn)−f(pn)f′′(pn)(f′(pn))2=pn−f(pn)f′(pn)f′(pn)2−f(pn)f′′(pn)\begin{align*} p_{n+1}=g(p_n) &= p_n-\frac{\mu(p_n)}{\mu'(p_n)} \\ &= p_n-\frac{\frac{f(p_n)}{f'(p_n)}}{\frac{f'(p_n)f'(p_n)-f(p_n)f''(p_n)}{(f'(p_n))^2}} \\ &= p_n-\frac{f(p_n)f'(p_n)}{f'(p_n)^2-f(p_n)f''(p_n)} \\ \end{align*}

这就是让有多重根的牛顿法二次收敛的方法。

  1. 要求二阶导
  2. 分母由两个接近于0的数相减,会引起严重的舍入误差。

2.5 加速收敛 | Accelerating Convergence

二次收敛是很少可以得到的,我们在日常中总会碰到线性收敛。为了考虑如何加速线性收敛序列的收敛速度,下面介绍——AITKENΔ2\Delta^2方法。

AITKENΔ2\Delta^2方法

"Δ\Delta"

对于给定的序列,向前差分(forward difference)定义为Δpn=pn+1−pn\Delta p_n = p_{n+1}-p_n,对于更高的幂,我们有Δkpn=Δ(Δk−1pn)\Delta^k p_n = \Delta(\Delta^{k-1}p_n),比如Δ2pn=Δ(Δpn)=Δ(pn+1−pn)=(pn+2−pn+1)−(pn+1−pn)\Delta^2 p_n = \Delta(\Delta p_n)= \Delta(p_{n+1}-p_n) = (p_{n+2}-p_{n+1}) -(p_{n+1}-p_n)

假设{pn}n=0∞\{p_n\}_{n=0}^\infty是线性收敛的,其极限为pp。

为了便于构造比{pn}n=0∞\{p_n\}_{n=0}^\infty收敛更快的序列{p^n}n=0∞\{\hat{p}_n\}_{n=0}^\infty,我们假设pn−p,pn+1−p,pn+2−pp_n-p, p_{n+1}-p, p_{n+2}-p的符号一致,又假设nn足够大,有

pn+1−ppn−p≈pn+2−ppn+1−p\frac{p_{n+1}-p}{p_n-p} \approx \frac{p_{n+2}-p}{p_{n+1}-p}

从而

pn+12−2pn+1p+p2≈pn+2pn−(pn+pn+2)p+p2p_{n+1}^2-2p_{n+1}p+p^2 \approx p_{n+2}p_n-(p_n+p_{n+2})p+p^2

解出pp,得到

p≈pn+2pn−pn+12pn+2−2pn+1+pn≈pn−(pn+1−pn)2pn+2−2pn+1+pnp \approx \frac{p_{n+2}p_{n}-p_{n+1}^2}{p_{n+2}-2p_{n+1}+p_n} \approx p_n - \frac{(p_{n+1}-p_n)^2}{p_{n+2}-2p_{n+1}+p_n}

于是,我们可以构造序列{p^n}n=0∞\{\hat{p}_n\}_{n=0}^\infty,其中

p^n=pn−(pn+1−pn)2pn+2−2pn+1+pn=pn−(Δpn)2Δ2pn\hat{p}_n = p_n - \frac{(p_{n+1}-p_n)^2}{p_{n+2}-2p_{n+1}+p_n}=p_n -\frac{(\Delta p_n)^2}{\Delta^2 p_n}

这样定义序列的方法就是AITKENΔ2\Delta^2法

"为什么说更快?"

可以证明

lim⁡n→∞pn^−ppn−p=0\lim_{n\rightarrow \infty} \frac{\hat{p_n}-p}{p_n-p} = 0

"怎么迭代?"

其实还是用序列本身的迭代法,不过在计算值的时候采取了AITKENΔ2\Delta^2法。

构造按如下顺序:

p0,p1=g(p0),p2=g(p1)p0^={Δ2}(p0)p3=g(p2)p1^={Δ2}(p1)⋮p_0, p_1 = g(p_0), p_2 = g(p_1) \\ \hat{p_0} = \{\Delta^2\}(p_0)\\ p_3 = g(p_2) \\ \hat{p_1} = \{\Delta^2\}(p_1)\\ \vdots

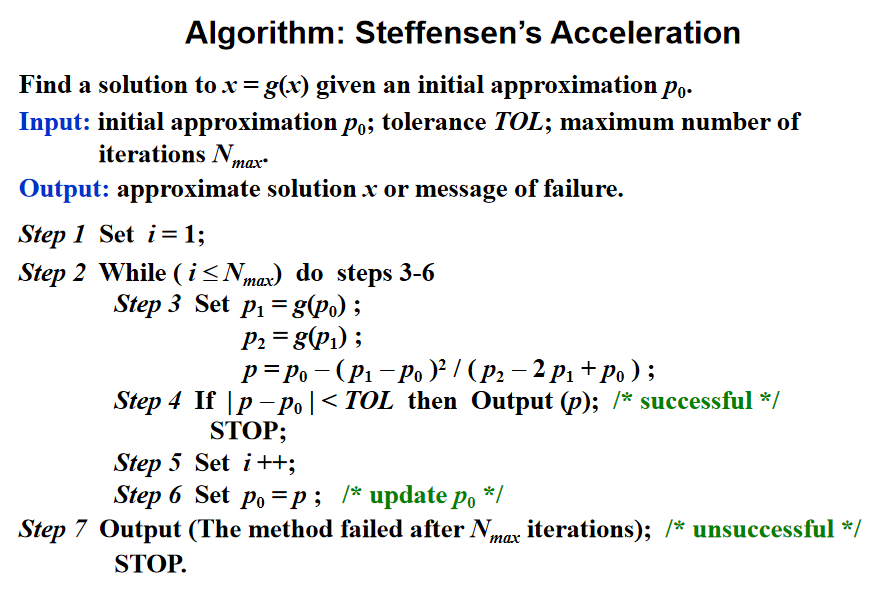
Steffensen 方法

这个方法假设p0^\hat{p_0}比p2p_2更好地逼近pp,从而把上述过程第三行的不动点迭代应用到p0^\hat{p_0}上

p0(0),p1(0)=g(p0(0)),p2(0)=g(p1(0))p0(1)={Δ2}(p0(0))p1(1)=g(p0(0))⋮p_0^{(0)}, p_1^{(0)} = g(p_0^{(0)}), p_2^{(0)} = g(p_1^{(0)}) \\ p_0^{(1)} = \{\Delta^2\}(p_0^{(0)})\\ p_1^{(1)} = g(p_0^{(0)}) \\ \vdots

算法如下:

Steffensen

注意Δ2pn\Delta^2 p_n可能为0,如果发生,则终止并选取p2(n−1)p_2^{(n-1)}为近似解。

我们一般要求g′(p)≠0g'(p)\neq 0,则在邻域内Steffensen法是二次收敛的

Chapter 3 插值和多项式逼近 | Interpolation and Polynomial Approximation

3.1 插值和 Lagrange 多项式 | Interpolation and Lagrange Polynomials

构造 Lagrange 多项式

拉格朗日插值就是构造一个次数至多为 nn 次的多项式使它通过 n+1n+1 个给定的点,这个多项式就是拉格朗日多项式。

" n=1n = 1 "

构造P(x)=a0+a1xP(x)=a_0+a_1x,使得P(x0)=y0P(x_0)=y_0,P(x1)=y1P(x_1)=y_1。

则P(x)=y0+y1−y0x1−x0(x−x0)=x−x1x0−x1y0+x−x0x1−x0y1P(x)=y_0+\frac{y_1-y_0}{x_1-x_0}(x-x_0)=\frac{x-x_1}{x_0-x_1}y_0+\frac{x-x_0}{x_1-x_0}y_1。

其中x−x1x0−x1\frac{x-x_1}{x_0-x_1}和x−x0x1−x0\frac{x-x_0}{x_1-x_0}分别记作L1,0(x)L_{1,0}(x)和L1,1(x)L_{1,1}(x)(第一个下标即为nn的值,第二个下标为样本点的序号),这称为拉格朗日基函数(Lagrange Basis)。

可以知道,拉格朗日基函数总是满足Kronecker Delta函数δij\delta_{ij}。

δij={1,i=j0,i≠j\delta_{ij} = \begin{cases} 1, & i = j \\ 0, & i \neq j \end{cases}

推广到nn次插值,构造P(x)=a0+a1x+⋯+anxnP(x)=a_0+a_1x+\cdots+a_nx^n,使得P(xi)=yiP(x_i)=y_i,i=0,1,⋯ ,ni=0,1,\cdots,n。就是要找到 Ln,i(x)L_{n,i}(x) 使得 Ln,i(xj)=δijL_{n,i}(x_j) = \delta_{ij}

分析可知,这里的Ln,i(x)L_{n,i}(x)有 nn 个根,分别为x0,x1,⋯ ,xi−1,xi+1,⋯ ,xnx_0,x_1,\cdots,x_{i-1},x_{i+1},\cdots,x_n。所以可以构造出

Ln,i(x)=C(x−x0)(x−x1)⋯(x−xi−1)(x−xi+1)⋯(x−xn)L_{n,i}(x)=C(x-x_0)(x-x_1)\cdots(x-x_{i-1})(x-x_{i+1})\cdots(x-x_n)

又因为Ln,i(xi)=1L_{n,i}(x_i)=1,所以

Ln,i(x)=(x−x0)(x−x1)⋯(x−xi−1)(x−xi+1)⋯(x−xn)(xi−x0)(xi−x1)⋯(xi−xi−1)(xi−xi+1)⋯(xi−xn)L_{n,i}(x)=\frac{(x-x_0)(x-x_1)\cdots(x-x_{i-1})(x-x_{i+1})\cdots(x-x_n)}{(x_i-x_0)(x_i-x_1)\cdots(x_i-x_{i-1})(x_i-x_{i+1})\cdots(x_i-x_n)}

即

Ln,i(x)=∏j=0,j≠inx−xjxi−xjL_{n,i}(x)=\prod\limits_{j=0,j\neq i}^n\frac{x-x_j}{x_i-x_j}

于是我们根据拉格朗日基函数构造出了 nn 次拉格朗日插值多项式

Pn(x)=∑i=0nLn,i(x)yiP_n(x)=\sum\limits_{i=0}^nL_{n,i}(x)y_i

Lagrange 多项式的唯一性

对 nn 个不同的点 , nn 次拉格朗日插值多项式是唯一的

证明:

如果不唯一,假设存在另一个多项式Qn(x)Q_n(x),使得Qn(xi)=yiQ_n(x_i)=y_i,i=0,1,⋯ ,ni=0,1,\cdots,n,且Qn(x)≠Pn(x)Q_n(x)\neq P_n(x)。

则Rn(x)=Pn(x)−Qn(x)R_n(x)=P_n(x)-Q_n(x)是一个次数不超过nn的多项式,且Rn(xi)=0R_n(x_i)=0,i=0,1,⋯ ,ni=0,1,\cdots,n。

由于Rn(x)R_n(x)的次数不超过nn,nn次多项式不可能有 n+1n+1 个解,所以Rn(x)=0R_n(x)=0,即Pn(x)=Qn(x)P_n(x)=Q_n(x),与假设矛盾。

如果 对 nn 个点 运用 超过nn 次的拉格朗日插值多项式,那么得到的多项式就不唯一了。

例如 P(x)=Ln(x)+p(x)∏i=0n(x−xi)P(x)=L_n\left(x\right)+p(x)\prod\limits_{i=0}^n\left(x-x_i\right)

拉格朗日逼近的余项

假定a≤x0<x1<⋯<xn≤ba\leq x_0<x_1<\cdots<x_n\leq b,f∈C[a,b]f\in C[a,b],Pn(x)P_n(x)是f(x)f(x)在x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n上的拉格朗日插值多项式,则对任意x∈[a,b]x\in[a,b],存在ξ(x)∈(a,b)\xi(x)\in(a,b),使得

f(x)−Pn(x)=f(n+1)(ξ(x))(n+1)!∏i=0n(x−xi)f(x)-P_n(x)=\frac{f^{(n+1)}(\xi(x))}{(n+1)!}\prod\limits_{i=0}^n(x-x_i)

"证明"

记Rn(x)=f(x)−Pn(x)R_n(x)=f(x)-P_n(x),则Rn(x)R_n(x)是一个次数不超过nn的多项式,且Rn(xi)=0R_n(x_i)=0,i=0,1,⋯ ,ni=0,1,\cdots,n。所以Rn(x)R_n(x)可记作C(x)∏i=0n(x−xi)C(x)\prod\limits_{i=0}^n(x-x_i)

固定一个点xx (x≠xix\neq x_i) 时,记g(t)=Rn(t)−C(x)∏i=0n(t−xi)g(t)=R_n(t)-C(x)\prod\limits_{i=0}^n(t-x_i),则g(x)=0g(x)=0,g(xi)=0g(x_i)=0,i=0,1,⋯ ,ni=0,1,\cdots,n,所以g(t)g(t)存在n+2n+2个不同的零点

根据推广的Rolle定理,存在ξ(x)∈(a,b)\xi(x)\in(a,b),使得g(n+1)(ξ(x))=0g^{(n+1)}(\xi(x))=0,即

0=g(n+1)(ξ(x))=(Rn(ξ(x))−C(x)∏i=0n(ξ(x)−xi))(n+1)=(f(ξ(x))−Pn(ξ(x))−C(x)∏i=0n(t−xi))(n+1)=f(n+1)(ξ(x))−C(x)(n+1)!//因为Pn(x)是n次多项式,所以Pn(n+1)(x)=0\begin{aligned} 0=g^{(n+1)}(\xi(x))&=(R_n(\xi(x))-C(x)\prod\limits_{i=0}^n(\xi(x)-x_i))^{(n+1)}\\&=(f(\xi(x))-P_n(\xi(x))-C(x)\prod\limits_{i=0}^n(t-x_i))^{(n+1)}\\ &=f^{(n+1)}(\xi(x))-C(x)(n+1)! \quad //因为P_n(x)是n次多项式,所以P_n^{(n+1)}(x)=0\\ \end{aligned}

所以C(x)=f(n+1)(ξ(x))(n+1)!C(x)=\frac{f^{(n+1)}(\xi(x))}{(n+1)!},所以Rn(x)=f(n+1)(ξ(x))(n+1)!∏i=0n(x−xi)R_n(x)=\frac{f^{(n+1)}(\xi(x))}{(n+1)!}\prod\limits_{i=0}^n(x-x_i)

因为这里的f(n+1)(ξ(x))f^{(n+1)}(\xi(x))是不知道的,所以我们经常用f(n+1)(x)f^{(n+1)}(x)的上界来估计余项。

分析余项可知,对于小于等于 nn 次的多项式 ff ,经过nn次拉格朗日插值得到的余项为0,得到的多项式就是 ff 本身

这里限制了ff为多项式

例子 1

假设为 x∈[0,1]x\in [0,1] 的函数 f(x)=exf(x)=e^x 做一个表格。设表中每一项精确的位数是 d≥8d\geq 8,相邻 xx 值之差即步长为 hh。为使线性插值(即一次Lagrange插值)的误差不超过 10−610^{-6},hh应该是多少?

解:

假设 [0,1][0, 1] 被分成 nn 个等距的子区间 [x0,x1],[x1,x2],⋯ ,[xn−1,xn][x_0, x_1], [x_1, x_2], \cdots, [x_{n-1} , x_n],xx 在区间 [xk,xk+1][x_k, x_{k+1}] 中。则误差估计为

∣f(x)−P1(x)∣=∣f′′(ξ(x))2!(x−xk)(x−xk+1)∣≤∣eξ2(x−kh)(x−(k+1)h)∣≤e2⋅h24≤10−6\begin{aligned} |f(x)-P_1(x)| &= |\frac{f''(\xi(x))}{2!}(x-x_k)(x-x_{k+1})| \\ &\leq |\frac{e^\xi}{2}(x-kh)(x-(k+1)h)| \\ &\leq \frac{e}{2}\cdot \frac{h^2}{4} \\ &\leq 10^{-6} \end{aligned}

所以 h≤1.72×10⁻³h\leq 1.72\times 10^{-3}。我们不妨取 h=10−3h=10^{-3},则 n=1000n=1000。

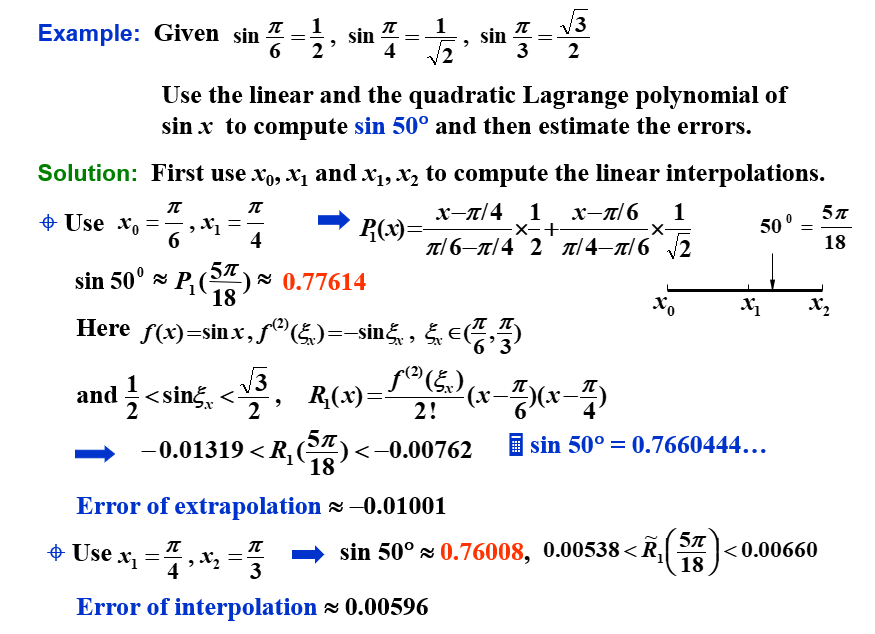
例子 2

Alt text

给三个点,我们有两种方法来线性插值。往往,内插(Intrapolation) 会比 外插(Extrapolation) 更加准确。
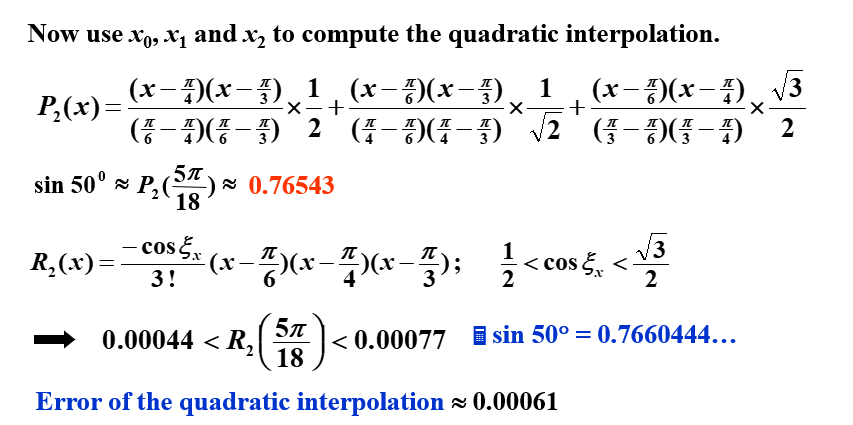
Alt text

高次的拉格朗日插值一般会比低次的插值更加准确,但是这不一定总成立。

Neville 迭代插值法

记号说明: 设 ff 在 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 上有定义,m1,m2,⋯ ,mkm_1,m_2,\cdots,m_k 是 kk 个不同的整数,0≤mi≤n0\leq m_i\leq n,i=1,2,⋯ ,ki=1,2,\cdots,k。记在这 kk 个点上与 f(x)f(x) 相同的拉格朗日多项式为 Pm1,m2,⋯ ,mk(x)P_{m_1,m_2,\cdots,m_k}(x)。

定理: 设 ff 在 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 上有定义,让 xix_i 和 xjx_j 是这个集合中的两个不同的数。则

P(x)=(x−xj)P0,1,...,j−1,j+1,...,k(x)−(x−xi)P0,1,...,i−1,i+1,...,k(x)(xi−xj)P(x)=\frac{(x-x_j)P_{0,1,...,j-1,j+1,...,k}(x)-(x-x_i)P_{0,1,...,i-1,i+1,...,k}(x)}{(x_i-x_j)}

描述了对 ff 在 x0,x1,⋯ ,xkx_0,x_1,\cdots,x_k 这 k+1k+1个点 上的 kk 次插值多项式。

"五个点"

Alt text

证明:

对于任意 0≤r≤k0\leq r\leq k,r≠ir\neq i 和 r≠jr\neq j,分子上的两个插值多项式在 xrx_r 处都等于 f(xr)f(x_r),所以 P(xr)=f(xr)P(x_r)=f(x_r)。

分子上的第一个多项式在 xix_i 处等于 f(xi)f(x_i),而第二个多项式在 xix_i 处为0,所以 P(xi)=f(xi)P(x_i)=f(x_i)。同理 P(xj)=f(xj)P(x_j)=f(x_j)。

所以 P(x)P(x) 在 x0,x1,⋯ ,xkx_0,x_1,\cdots,x_k 上与 f(x)f(x) 相同,因为 P(x)P(x) 是 kk 次多项式,所以 P(x)=P0,1,⋯ ,k(x)P(x)=P_{0,1,\cdots,k}(x)。

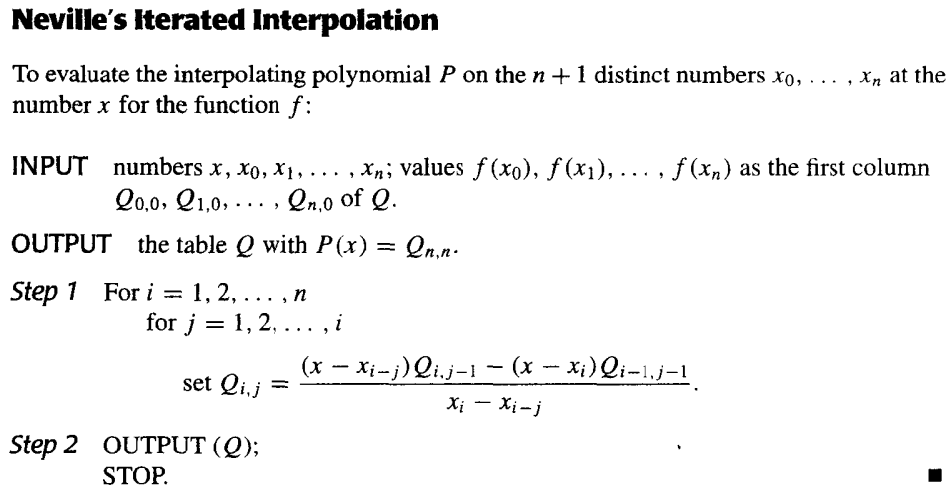
伪代码

Alt text

3.2 Divided Differences | 差商

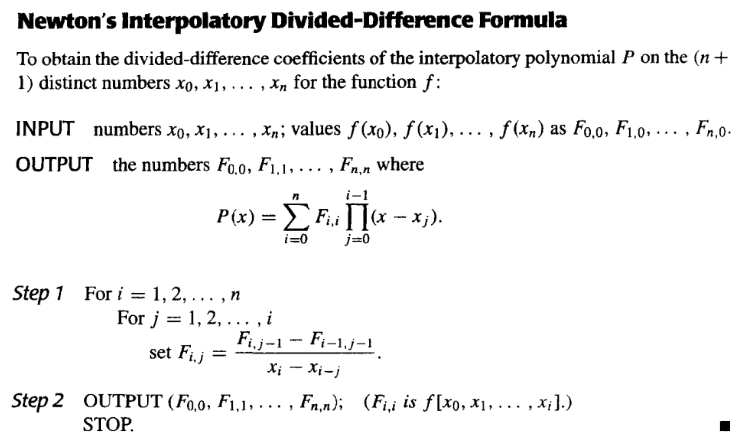
Newton's Interpolatory Divided-Difference formula | 差商型 Newton 插值多项式

设 Pn(x)P_n(x) 是函数 ff 在点 x0,x1,⋯ ,xnx_0, x_1,\cdots,x_n 上的拉格朗日多项式,ff 关于 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 的差商被用于将 Pn(x)P_n(x) 表示为:

Pn(x)=f[x0]+f[x0,x1](x−x0)+⋯+f[x0,x1,⋯ ,xn](x−x0)(x−x1)⋯(x−xn−1)P_n(x)=f[x_0]+f[x_0,x_1](x-x_0)+\cdots+f[x_0,x_1,\cdots,x_n](x-x_0)(x-x_1)\cdots(x-x_{n-1})

其中 f[x0,x1,⋯ ,xn]f[x_0,x_1,\cdots,x_n] 是 ff 关于 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 的差商,通过代值可以得到

f[x0]=f(x0),f[x0,x1]=f(x1)−f(x2)x1−x0,f[x0,x1,x2]=f[x1,x2]−f[x0,x1]x2−x0,⋯f[x_0]=f(x_0), f[x_0,x_1]=\frac{f(x_1)-f(x_2)}{x_1-x_0}, f[x_0,x_1,x_2]=\frac{f[x_1,x_2]-f[x_0,x_1]}{x_2-x_0}, \cdots

f[x0,x1,⋯ ,xn]=f[x1,x2,⋯ ,xn]−f[x0,x1,⋯ ,xn−1]xn−x0f[x_0,x_1,\cdots,x_n]=\frac{f[x_1,x_2,\cdots,x_n]-f[x_0,x_1,\cdots,x_{n-1}]}{x_n-x_0}

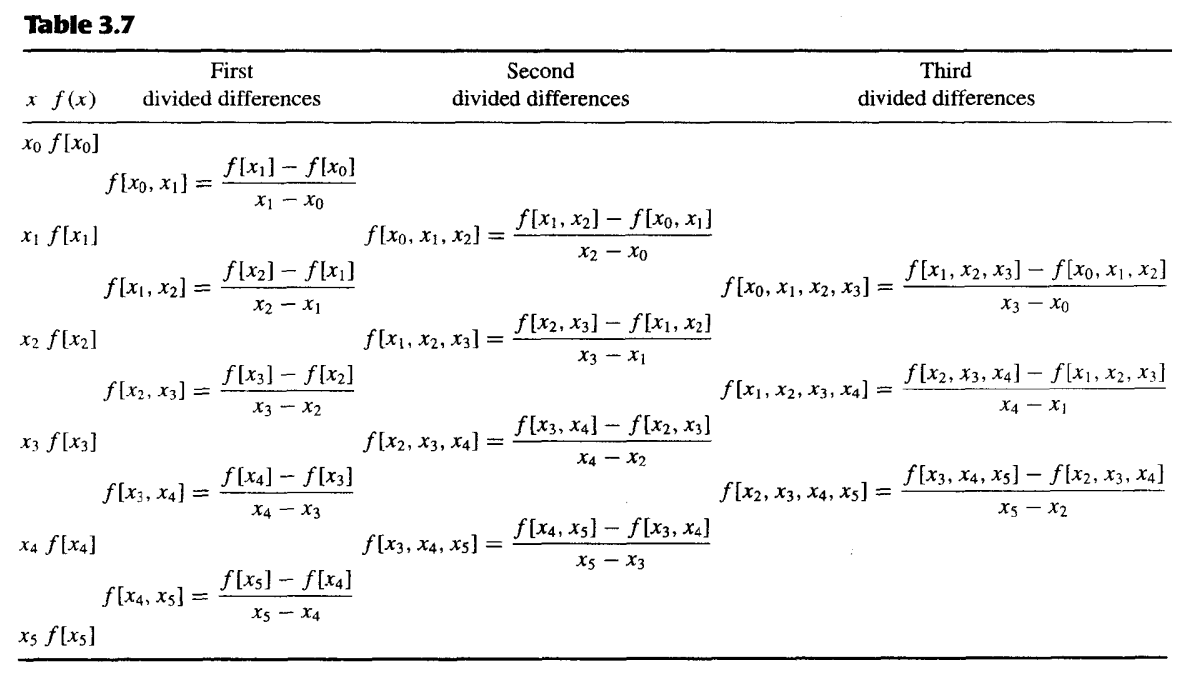
我们记 f[x0],f[x0,x1],⋯ ,f[x0,x1,⋯ ,xn]f[x_0], f[x_0,x_1],\cdots,f[x_0,x_1,\cdots,x_n] 为 ff 关于 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 的 00 阶差商,11 阶差商,⋯\cdots,nn 阶差商。

"六个点的三阶差商计算的例子"

Alt text

同时,我们称

Pn(x)=f[x0]+f[x0,x1](x−x0)+⋯+f[x0,x1,⋯ ,xn](x−x0)(x−x1)⋯(x−xn−1)P_n(x)=f[x_0]+f[x_0,x_1](x-x_0)+\cdots+f[x_0,x_1,\cdots,x_n](x-x_0)(x-x_1)\cdots(x-x_{n-1})

为差商型 Newton 插值多项式(Newton's Interpolatory Divided-Difference formula)。

伪代码
Alt text

差商和导数的关系
一阶差分

将中值定理应用到 ff 在 [x0,x1][x_0,x_1] 上,得到

f[x0,x1]=f(x1)−f(x0)x1−x0=f′(ξ)f[x_0,x_1]=\frac{f(x_1)-f(x_0)}{x_1-x_0}=f'(\xi)

nn 阶差分

设 f∈Cn[a,b]f\in C^n[a,b] 且 x0,x1,⋯ ,xn∈[a,b]x_0,x_1,\cdots,x_n\in[a,b],则存在 ξ∈(a,b)\xi\in(a,b),使得

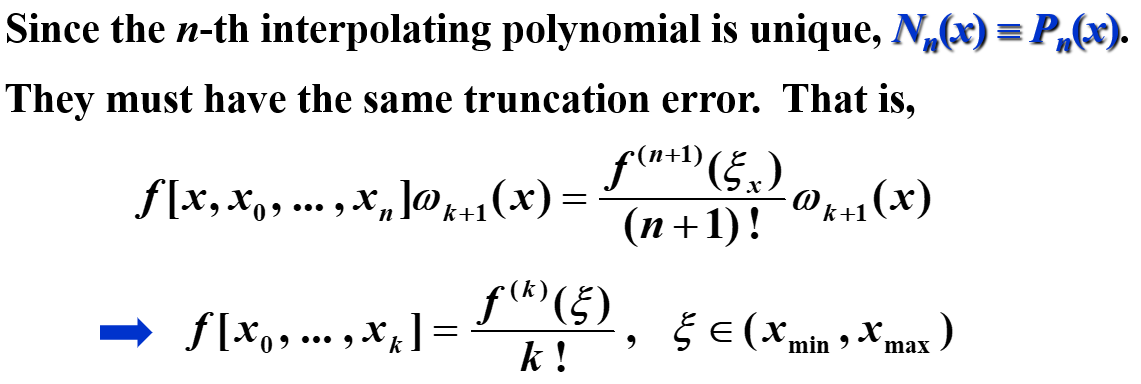
f[x0,x1,⋯ ,xn]=f(n)(ξ)n!f[x_0,x_1,\cdots,x_n]=\frac{f^{(n)}(\xi)}{n!}

证明:

设 g(t)=f(t)−Pn(t)g(t)=f(t)-P_n(t),则 g(xi)=0g(x_i)=0,i=0,1,⋯ ,ni=0,1,\cdots,n。所以 g(t)g(t) 在 [x0,xn][x_0,x_n] 上有 n+1n+1 个零点,根据推广的 Rolle 定理,存在 ξ∈(a,b)\xi\in(a,b),使得 g(n)(ξ)=0g^{(n)}(\xi)=0,即

f(n)(ξ)−Pn(n)(ξ)=0f^{(n)}(\xi)-P_n^{(n)}(\xi)=0

所以 Pn(n)(ξ)=f(n)(ξ)P_n^{(n)}(\xi)=f^{(n)}(\xi),因为

Pn(n)(ξ)=n!f[x0,x1,⋯ ,xn]P_n^{(n)}(\xi)=n!f[x_0,x_1,\cdots,x_n]

所以

f[x0,x1,⋯ ,xn]=f(n)(ξ)n!f[x_0,x_1,\cdots,x_n]=\frac{f^{(n)}(\xi)}{n!}

"PPT上采用的证明方法"

Alt text

差分记号引入

如果每个点都连续等步长排列,记步长为hh,令xi=x0+ihx_i=x_0+ih,则

引入**向前差分(forward difference)**记号:

Δf(xi)=f(xi+1)−f(xi)Δ2f(xi)=Δf(xi+1)−Δf(xi)Δ3f(xi)=Δ2f(xi+1)−Δ2f(xi)⋯\begin{aligned} \Delta f(x_i)&=f(x_{i+1})-f(x_i)\\ \Delta^2 f(x_i)&=\Delta f(x_{i+1})-\Delta f(x_i)\\ \Delta^3 f(x_i)&=\Delta^2 f(x_{i+1})-\Delta^2 f(x_i)\\ \cdots \end{aligned}

引入**向后差分(backward difference)**记号:

∇f(xi)=f(xi)−f(xi−1)∇2f(xi)=∇f(xi)−∇f(xi−1)∇3f(xi)=∇2f(xi)−∇2f(xi−1)⋯\begin{aligned} \nabla f(x_i)&=f(x_i)-f(x_{i-1})\\ \nabla^2 f(x_i)&=\nabla f(x_i)-\nabla f(x_{i-1})\\ \nabla^3 f(x_i)&=\nabla^2 f(x_i)-\nabla^2 f(x_{i-1})\\ \cdots \end{aligned}

引入**中心差分(central difference)**记号:

δkfi=δk−1fi+12−δk−1fi−12\delta^k f_i = \delta^{k-1}f_{i+\frac{1}{2}}-\delta^{k-1}f_{i-\frac{1}{2}}

其中

fi±12=f(xi±h2)f_{i\pm\frac{1}{2}}=f(x_i\pm\frac{h}{2})

等距下的向前差商公式

在等距情况下,向前差商的公式可表示为:

Pn(xs)=Pn(x0+sh)=f[x0]+f[x0,x1]sh+⋯+f[x0,x1,⋯ ,xn]s(s−1)⋯(s−n+1)hn=∑k=0n(sk)k!hkf[x0,x1,⋯ ,xk]\begin{aligned} P_n(x_s)=P_n(x_0+sh)&=f[x_0]+f[x_0,x_1]sh+\cdots+f[x_0,x_1,\cdots,x_n]s(s-1)\cdots(s-n+1)h^n\\ &=\sum\limits_{k=0}^n\begin{pmatrix}s\\k\end{pmatrix}k!h^kf[x_0,x_1,\cdots,x_k] \end{aligned}

这里的 (sk)\begin{pmatrix}s\\k\end{pmatrix} 是组合数,即 s(s−1)⋯(s−k+1)k!\frac{s(s-1)\cdots(s-k+1)}{k!}

等距下的向前差分公式

由向前差分的记号可知道

f[x0,x1]=f(x1)−f(x0)x1−x0=1hΔf(x0)f[x0,x1,x2]=12h[Δf(x1)−Δf(x0)h]=12h2Δ2f(x0),\begin{aligned} f[x_{0},x_{1}]& =\frac{f(x_{1})-f(x_{0})}{x_{1}-x_{0}}=\frac{1}{h}\Delta f(x_{0}) \\ f[x_{0},x_{1},x_{2}]& =\frac{1}{2h}\left[\frac{\Delta f(x_{1})-\Delta f(x_{0})}{h}\right]=\frac{1}{2h^{2}}\Delta^{2}f(x_{0}), \end{aligned}

由此可推广得出

f[x0,x1,…,xk]=1k!hkΔkf(x0).f[x_{0},x_{1},\ldots,x_{k}]=\frac{1}{k!h^{k}}\Delta^{k}f(x_{0}).

所以

Pn(xs)=∑k=0n(sk)Δkf(x0)P_n(x_s)=\sum\limits_{k=0}^n\begin{pmatrix}s\\k\end{pmatrix}\Delta^{k}f(x_{0})

此即为向前差分的公式

等距下的向后差商公式

重排插值节点再计算,此时:

Pn(x)=f[xn]+f[xn,xn−1](x−xn)+f[xn,xn−1,xn−2](x−xn)(x−xn−1)+⋯+f[xn,…,x0](x−xn)(x−xn−1)⋯(x−x1).\begin{aligned}P_n(x)=&f[x_n]+f[x_n,x_{n-1}](x-x_n)+f[x_n,x_{n-1},x_{n-2}](x-x_n)(x-x_{n-1})\\&+\cdots+f[x_n,\ldots,x_0](x-x_n)(x-x_{n-1})\cdots(x-x_1).\end{aligned}

在等距情况下,记 xs=xn+sh=xi+(s+n−i)hx_s=x_n+sh=x_i+(s+n-i)h,有

Pn(xs)=Pn(xn+sh)=f[xn]+shf[xn,xn−1]+s(s+1)h2f[xn,xn−1,xn−2]+⋯+s(s+1)⋯(s+n−1)hnf[xn,…,x0]=∑k=0n(−1)k(−sk)k!hkf[xn,xn−1,⋯ ,xn−k]\begin{aligned} P_{n}(x_s) =&P_{n}(x_{n}+sh) \\ =&f[x_{n}]+shf[x_{n},x_{n-1}]+s(s+1)h^{2}f[x_{n},x_{n-1},x_{n-2}]+\cdots \\ &+s(s+1)\cdots(s+n-1)h^nf[x_n,\ldots,x_0]\\ =&\sum\limits_{k=0}^n(-1)^k\begin{pmatrix}-s\\k\end{pmatrix}k!h^kf[x_n,x_{n-1},\cdots,x_{n-k}] \end{aligned}

这里的 (−sk)\begin{pmatrix}-s\\k\end{pmatrix} 是组合数,即 −s(−s−1)⋯(−s−k+1)k!=(−1)k⋅s(s+1)⋯(s+k−1)k!\frac{-s(-s-1)\cdots(-s-k+1)}{k!}=(-1)^k \cdot \frac{s(s+1)\cdots(s+k-1)}{k!}

等距下的向后差分公式

由向后差分的记号可知道

f[xn,xn−1]=1h∇f(xn),f[xn,xn−1,xn−2]=12h2∇2f(xn),\begin{aligned} f[x_n,x_{n-1}]&=\frac1h\nabla f(x_n),\\ f[x_n,x_{n-1},x_{n-2}]&=\frac1{2h^2}\nabla^2f(x_n),\\\end{aligned}

由此可推广得出

f[xn,xn−1,…,xn−k]=1k!hk∇kf(xn).\begin{aligned} f[x_n,x_{n-1},\ldots,x_{n-k}]&=\frac1{k!h^k}\nabla^kf(x_n).\end{aligned}

所以

Pn(xs)=∑k=0n(−1)k(−sk)∇kf(xn)P_n(x_s)=\sum\limits_{k=0}^n(-1)^k\begin{pmatrix}-s\\k\end{pmatrix}\nabla^kf(x_n)

3.3 Hermite Interpolation | Hermite 插值

Hermite 插值的目标是找到一个插值多项式

Osculating polynomials | 密切多项式

在 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 上逼近 f∈Cm[a,b]f\in C^m[a,b] 的密切多项式(osculating polynomial) 是具有以下性质的多项式 Pn(x)P_n(x):

  1. Pn(x)P_n(x) 在 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 上与 f(x)f(x) 相同
  2. 对每个 xix_i,Pn(x)P_n(x) 和 f(x)f(x) 在 xix_i 处的前 mim_i 阶导数相同
  3. 因此,我们可以得到 ∑i=0n(mi+1)=∑i=0nmi+(n+1)\sum\limits_{i=0}^n(m_i+1)=\sum\limits_{i=0}^nm_i+(n+1) 个条件,于是 Pn(x)P_n(x) 是一个次数至多为 ∑i=0nmi+n\sum\limits_{i=0}^nm_i+n 的多项式

我们给出密切多项式的定义:

定义: 设 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 是 [a,b][a,b] 上的 n+1n+1 个不同的点,m0,m1,⋯ ,mnm_0,m_1,\cdots,m_n 是 n+1n+1 个非负整数,假设f∈Cm[a,b]f\in C^m[a,b],其中 m=max⁡0≤i≤nmim=\max\limits_{0\leq i\leq n}m_i。逼近 ff 的密切多项式 Pn(x)P_n(x) 是使得下式成立的最小次数的多项式:

dkdxkPn(xi)=dkdxkf(xi),k=0,1,⋯ ,mi,i=0,1,⋯ ,n\frac{d^k}{dx^k}P_n(x_i)=\frac{d^k}{dx^k}f(x_i),\quad k=0,1,\cdots,m_i,\quad i=0,1,\cdots,n

  1. 当 n=0n=0 时,逼近 ff 的密切多项式是 ff 在 x0x_0 处的 m0m_0 阶 Taylor 多项式。
  2. 当 mi=0m_i=0 时,密切多项式就是对 ff 在 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n 上插值的 nn 次拉格朗日插值多项式。

Hermite 插值多项式

对密切多项式 mi=1m_i=1 的情况,我们定义其为 Hermite 多项式。也就是说,多项式 P(n)P(n) 和它的一阶导数 P′(n)P'(n) 在 xix_i 处与 ff 和 f′f' 相同。

特殊例子

假设 x0≠x1≠x2x_0\neq x_1 \neq x_2,给定 f(x0),f(x1),f(x2),f′(x1)f(x_0),f(x_1),f(x_2),f'(x_1),找到多项式使得P(xi)=f(xi)P(x_i)=f(x_i),P′(x1)=f′(x1)P'(x_1)=f'(x_1)。

首先,其次数为3次,我们猜想其形式为

P(x)=∑i=02f(xi)hi(x)+f′(x1)h^1(x)P(x)=\sum\limits_{i=0}^2f(x_i)h_i(x)+f'(x_1)\hat{h}_1(x)

其中hi(xj)=δi(xj),hi′(x1)=0,h^1(xi)=0,h^1′(x1)=1h_i(x_j)=\delta_i(x_j),h'_i(x_1)=0,\hat{h}_1(x_i)=0,\hat{h}'_1(x_1)=1。

根据这个猜想,我们试图构造出 hi(x)h_i(x) 和 h^1(x)\hat{h}_1(x) 。

首先,我们可以用拉格朗日同样的方法构造出三次多项式hi(x)h_i(x),使得hi(xj)=δi(xj)h_i(x_j)=\delta_i(x_j),hi′(x1)=0h'_i(x_1)=0,i=0,1,2i=0,1,2。

对于h0(x)h_0(x),有根x1,x2x_1,x_2,且因为 h0′(x1)=0h'_0(x_1)=0 所以 x1x_1 是 h0(x)h_0(x) 的二重根,所以其形式为

h0(x)=C0(x−x1)2(x−x2)h_0(x)=C_0(x-x_1)^2(x-x_2)

又因为h0′(x0)=1h'_0(x_0)=1,所以

h0(x)=(x−x1)2(x−x2)(x0−x1)2(x0−x2)h_0(x)=\frac{(x-x_1)^2(x-x_2)}{(x_0-x_1)^2(x_0-x_2)}

类似地,我们可以得到

h2(x)=(x−x0)(x−x1)2(x2−x0)(x2−x1)2h_2(x)=\frac{(x-x_0)(x-x_1)^2}{(x_2-x_0)(x_2-x_1)^2}

对于h1(x)h_1(x),有根x0,x2x_0,x_2,都是单根。所以其形式为

h1(x)=(Ax+B)(x−x0)(x−x2)h_1(x)=(Ax+B)(x-x_0)(x-x_2)

通过计算 h1(x1)=1h_1(x_1)=1,h1′(x1)=0h'_1(x_1)=0,可以得到 AA 和 BB 的值。此处略。

然后,我们构造h^1(x)\hat{h}_1(x),使得h^1(xi)=0\hat{h}_1(x_i)=0,h^1′(x1)=1\hat{h}'_1(x_1)=1。对于h^1(x)\hat{h}_1(x),有根x0,x1,x2x_0,x_1,x_2,所以

h^1(x)=C(x−x0)(x−x1)(x−x2)\hat{h}_1(x)=C(x-x_0)(x-x_1)(x-x_2)

又因为h^1′(x1)=1\hat{h}'_1(x_1)=1,所以可以通过计算得到 CC 的值。此处略。

一般情况

如果已知 f(x0),f(x1),⋯ ,f(xn)f(x_0),f(x_1),\cdots,f(x_n) 和 f′(x0),f′(x1),⋯ ,f′(xn)f'(x_0),f'(x_1),\cdots,f'(x_n),则可以构造出 Hermite 插值多项式

H2n+1(x)=∑i=0nf(xi)hi(x)+∑i=0nf′(xi)h^i(x)H_{2n+1}(x)=\sum\limits_{i=0}^nf(x_i)h_i(x)+\sum\limits_{i=0}^nf'(x_i)\hat{h}_i(x)

其中(2n+1)(2n+1)阶多项式hi(xj)=δi(xj),hi′(xj)=0,h^i(xj)=0,h^i′(xj)=δi(xj)h_i(x_j)=\delta_i(x_j),h'_i(x_j)=0,\hat{h}_i(x_j)=0,\hat{h}'_i(x_j)=\delta_i(x_j)。

对于hi(x)h_i(x),有根x0,x1,⋯ ,xi−1,xi+1,⋯ ,xnx_0,x_1,\cdots,x_{i-1},x_{i+1},\cdots,x_n,且因为 hi′(xj)=0(j≠i)h'_i(x_j)=0(j\neq i) 所以 xjx_j 是 hi(x)h_i(x) 的 22 重根,所以其形式为

hi(x)=(A′x+B′)(x−x0)2(x−x1)2⋯(x−xi−1)2(x−xi+1)2⋯(x−xn)2=(Ax+B)Ln,i2(x)\begin{aligned} h_i(x)&=(A'x+B')(x-x_0)^2(x-x_1)^2\cdots(x-x_{i-1})^2(x-x_{i+1})^2\cdots(x-x_n)^2\\ &=(Ax+B)L_{n,i}^2(x) \end{aligned}

这里的常系数改变是因为引入 Ln,i(x)L_{n,i}(x) 的话,它相较前面的有额外系数

Ln,i(x)=∏j=0,j≠inx−xjxi−xjL_{n,i}(x)=\prod\limits_{j=0,j\neq i}^n\frac{x-x_j}{x_i-x_j}

因为hi(xi)=1h_i(x_i)=1,hi′(xi)=0h'_i(x_i)=0,所以

hi(x)=(1−2(x−xi)Ln,i′(xi))(Ln,i(x))2h_i(x)=\left(1-2(x-x_i)L'_{n,i}(x_i)\right)\left(L_{n,i}(x)\right)^2

对于h^i(x)\hat{h}_i(x),有根x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n,且因为 h^i′(xj)=0(j≠i)\hat{h}'_i(x_j)=0(j\neq i),h^i′(xi)=1\hat{h}'_i(x_i)=1 所以 xix_i 是 h^i(x)\hat{h}_i(x) 的 11 重根,其余的都是 22 重根,所以其形式为

h^i(x)=Ci(x−xi)(Ln,i(x))2\hat{h}_i(x)=C_i(x-x_i)\left(L_{n,i}(x)\right)^2

因为h^i′(xi)=1\hat{h}'_i(x_i)=1,所以

h^i(x)=(x−xi)(Ln,i(x))2\hat{h}_i(x)=\left(x-x_i\right)\left(L_{n,i}(x)\right)^2

余项

如果 a=x0<x1<⋯<xn=ba=x_0<x_1<\cdots<x_n=b,f∈C2n[a,b]f\in C^{2n}[a,b],余项为

f(x)−Pn(x)=f(2n+2)(ξ(x))(2n+2)!∏i=0n(x−xi)2f(x)-P_n(x)=\frac{f^{(2n+2)}(\xi(x))}{(2n+2)!}\prod\limits_{i=0}^n(x-x_i)^2

3.4 Cubic Spline Interpolation | 三次样条插值

Piecewise-polynomial approximation | 分段多项式逼近

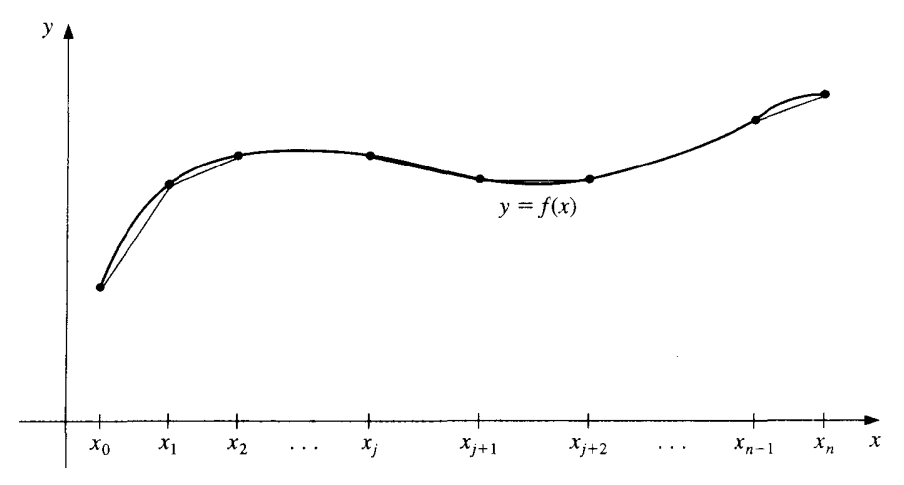
最简单的分段多项式逼近是分段线性逼近,即在每个子区间上用一个一次多项式逼近函数 ff。但是,分段线性逼近的函数不光滑,所以我们希望用更高次的多项式来逼近 ff。

Alt text

一个可替代的方法是使用 Hermite 插值多项式。例如,如果 ff 和 f′f' 的值在每一个点 xix_i 处都已知,那么我们可以在每个子区间上使用一个三次多项式来逼近 ff。这样的逼近是光滑的,但是为了将该多项式应用于一般插值,需要知道所有的 f′f' 的值,这是不现实的。

由此,我们引入了三次样条插值。

Cubic spline interpolation | 三次样条插值

三次样条的构造不假设插值函数的导数值与原函数的导数值相等,即使在插值点处也如此。

给定在 [a,b][a,b] 上的 n+1n+1 个点 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n,a=x0<x1<⋯<xn=ba=x_0<x_1<\cdots<x_n=b,以及 ff。三次样条插值是一个函数 S(x)S(x),满足以下条件:

  1. S(x)S(x) 在每个子区间 [xi,xi+1][x_i,x_{i+1}] 上是一个三次多项式,i=0,1,⋯ ,n−1i=0,1,\cdots,n-1
  2. S(xi)=f(xi)S(x_i)=f(x_i),i=0,1,⋯ ,ni=0,1,\cdots,n
  3. Si+1(xi+1)=Si(xi+1)S_{i+1}(x_{i+1})=S_i(x_{i+1}),i=0,1,⋯ ,n−2i=0,1,\cdots,n-2
  4. Si+1′(xi+1)=Si′(xi+1)S'_{i+1}(x_{i+1})=S'_i(x_{i+1}),i=0,1,⋯ ,n−2i=0,1,\cdots,n-2
  5. Si+1′′(xi+1)=Si′′(xi+1)S''_{i+1}(x_{i+1})=S''_i(x_{i+1}),i=0,1,⋯ ,n−2i=0,1,\cdots,n-2
  6. 下列的边界条件之一成立:
    1. S′′(x0)=S′′(xn)=0S''(x_0)=S''(x_n)=0,称为自由或自然边界(free or natural boundary)
    2. S′(x0)=f′(x0)S'(x_0)=f'(x_0),S′(xn)=f′(xn)S'(x_n)=f'(x_n),称为固支边界(clamped boundary)
    3. 其他边界条件(上面两个条件其实已经足以满足目的了)

我们介绍一种构造三次样条插值的方法:

Method of Bending Moments

记 hj=xj−xj−1h_j=x_j-x_{j-1},在 x∈[xj−1,xj]x\in[x_{j-1},x_j] 上,S(x)=Sj(x)S(x)=S_j(x),S′(x)=Sj′(x)S'(x)=S'_j(x),S′′(x)=Sj′′(x)S''(x)=S''_j(x)。

因为 S(x)S(x) 是一个三次多项式,所以 Sj′′(x)S''_j(x) 是一个一次多项式,由端点值决定,假设 Sj′′(xj−1)=Mj−1S''_j(x_{j-1})=M_{j-1},Sj′′(xj)=MjS''_j(x_j)=M_j。那么对于 x∈[xj−1,xj]x\in[x_{j-1},x_j],有

Sj′′(x)=Mj−1xj−xhj+Mjx−xj−1hjS''_j(x)=M_{j-1}\frac{x_j-x}{h_j}+M_j\frac{x-x_{j-1}}{h_j}

积分得到

Sj′(x)=−Mj−1(xj−x)22hj+Mj(x−xj−1)22hj+AjS'_j(x)=-M_{j-1}\frac{(x_j-x)^2}{2h_j}+M_j\frac{(x-x_{j-1})^2}{2h_j}+A_j

再积分得到

Sj(x)=Mj−1(xj−x)36hj+Mj(x−xj−1)36hj+Ajx+BjS_j(x)=M_{j-1}\frac{(x_j-x)^3}{6h_j}+M_j\frac{(x-x_{j-1})^3}{6h_j}+A_jx+B_j

AjA_j 和 BjB_j 是常数,可以通过 Sj(xj−1)=yj−1S_j(x_{j-1})=y_{j-1} 和 Sj(xj)=yjS_j(x_j)=y_{j} 得到。

{Sj(xj−1)=yj−1Sj(xj)=yj⇒{Mj−1hj26+Ajxj−1+Bj=yj−1Mjhj26+Ajxj+Bj=yj⇒{Aj=yj−yj−1hj−Mj−Mj−16hjBj=yj−1xj−yjxj−1hj−Mj−1xj−Mjxj−16hj\begin{aligned} \begin{cases} S_j(x_{j-1})=y_{j-1}\\ S_j(x_j)=y_{j} \end{cases} &\Rightarrow \begin{cases} M_{j-1}\frac{h_j^2}{6}+A_jx_{j-1}+B_j=y_{j-1}\\ M_j\frac{h_j^2}{6}+A_jx_j+B_j=y_{j} \end{cases}\\ &\Rightarrow \begin{cases} A_j=\frac{y_j-y_{j-1}}{h_j}-\frac{M_j-M_{j-1}}{6}h_j\\ B_j=\frac{y_{j-1}x_j-y_jx_{j-1}}{h_j}-\frac{M_{j-1}x_j-M_jx_{j-1}}{6}h_j \end{cases}\\ \end{aligned}

所以

Ajx+Bj=yj−yj−1hjx+yj−1xj−yjxj−1hj−Mj−Mj−16hjx−Mj−1xj−Mjxj−16hj=(yj−1−Mj−16hj2)xj−xhj+(yj−Mj6hj2)x−xj−1hj\begin{aligned} A_jx+B_j&=\frac{y_j-y_{j-1}}{h_j}x+\frac{y_{j-1}x_j-y_jx_{j-1}}{h_j}-\frac{M_j-M_{j-1}}{6}h_jx-\frac{M_{j-1}x_j-M_jx_{j-1}}{6}h_j\\ &=(y_{j-1}-\frac{M_{j-1}}{6}h_j^2)\frac{x_j-x}{h_j}+(y_j-\frac{M_j}{6}h_j^2)\frac{x-x_{j-1}}{h_j} \end{aligned}

所以,我们的目的就是求出 MjM_j,j=0,1,⋯ ,nj=0,1,\cdots,n。

因为 S′S' 是连续的,所以

在 [xj−1,xj][x_{j-1},x_j] 上,Sj′(x)=−Mj−1(xj−x)22hj+Mj(x−xj−1)22hj+f[xj−1,xj]−Mj−Mj−16hjS'_j(x)=-M_{j-1}\frac{(x_j-x)^2}{2h_j}+M_j\frac{(x-x_{j-1})^2}{2h_j}+f[x_{j-1},x_j]-\frac{M_j-M_{j-1}}{6}h_j

在 [xj,xj+1][x_j,x_{j+1}] 上,Sj+1′(x)=−Mj(xj+1−x)22hj+1+Mj+1(x−xj)22hj+1+f[xj,xj+1]−Mj+1−Mj6hj+1S'_{j+1}(x)=-M_{j}\frac{(x_{j+1}-x)^2}{2h_{j+1}}+M_{j+1}\frac{(x-x_{j})^2}{2h_{j+1}}+f[x_j,x_{j+1}]-\frac{M_{j+1}-M_{j}}{6}h_{j+1}

有 Sj+1′(xj)=Sj′(xj)S'_{j+1}(x_j)=S'_j(x_j),所以我们可以得到 Mj−1,Mj,Mj+1M_{j-1}, M_j, M_{j+1} 之间的关系:

记 λj=hj+1hj+hj+1\lambda_j=\frac{h_{j+1}}{h_j+h_{j+1}},μj=hjhj+hj+1\mu_j=\frac{h_{j}}{h_j+h_{j+1}},gj=6hj+hj+1(f[xj,xj+1]−f[xj−1,xj])g_j=\frac{6}{h_j+h_{j+1}}(f[x_j,x_{j+1}]-f[x_{j-1},x_j]),则

μjMj−1+2Mj+λjMj+1=gj\mu_jM_{j-1}+2M_j+\lambda_jM_{j+1}=g_j

其中 j=1,2,⋯ ,n−1j=1,2,\cdots,n-1。

[μ12λ1μ22λ2⋱⋱⋱μn−12λn−1][M0M1⋮Mn]=[g1g2⋮gn−1]\begin{bmatrix} \mu_1 & 2 & \lambda_1 & & & \\ & \mu_2 & 2 & \lambda_2 & & \\ & & \ddots & \ddots & \ddots & \\ & & & \mu_{n-1} & 2 & \lambda_{n-1} \\ \end{bmatrix} \begin{bmatrix} M_0\\ M_1\\ \vdots\\ M_n\\ \end{bmatrix}= \begin{bmatrix} g_1\\ g_2\\ \vdots\\ g_{n-1}\\ \end{bmatrix}

我们有 n+1n+1 个未知数,n−1n-1个方程 → 由边界条件增加两个方程

Clamped boundary | 固支边界

此时我们知道 S′(x0)=f′(x0)S'(x_0)=f'(x_0),S′(xn)=f′(xn)S'(x_n)=f'(x_n),所以

在 [x0,x1][x_0,x_1] 上,S1′(x)=−M0(x1−x)22h1+M1(x−x0)22h1+f[x0,x1]−M1−M06h1S'_1(x)=-M_0\frac{(x_1-x)^2}{2h_1}+M_1\frac{(x-x_0)^2}{2h_1}+f[x_0,x_1]-\frac{M_1-M_0}{6}h_1

在 [xn−1,xn][x_{n-1},x_n] 上,Sn′(x)=−Mn−1(xn−x)22hn+Mn(x−xn−1)22hn+f[xn−1,xn]−Mn−Mn−16hnS'_n(x)=-M_{n-1}\frac{(x_n-x)^2}{2h_n}+M_n\frac{(x-x_{n-1})^2}{2h_n}+f[x_{n-1},x_n]-\frac{M_n-M_{n-1}}{6}h_n

所以我们额外有两个方程:

{f′(x0)=−M0h12+f[x0,x1]−M1−M06h1f′(xn)=Mnhn2+f[xn−1,xn]−Mn−Mn−16hn⇒{2M0+M1=6h1(f[x0,x1]−f′(x0))≜g0Mn−1+2Mn=6hn(f′(xn)−f[xn−1,xn])≜gn\begin{cases} f'(x_0)=-M_0\frac{h_1}{2}+f[x_0,x_1]-\frac{M_1-M_0}{6}h_1\\ f'(x_n)=M_{n }\frac{h_n}{2}+f[x_{n-1},x_n]-\frac{M_n-M_{n-1}}{6}h_n \end{cases} \Rightarrow \begin{cases} 2M_0+M_1=\frac{6}{h_1}(f[x_0,x_1]-f'(x_0))\triangleq g_0\\ M_{n-1}+2M_n=\frac{6}{h_n}(f'(x_n)-f[x_{n-1},x_n]) \triangleq g_n \end{cases}

所以我们可以得到

[21μ12λ1⋱⋱⋱μn−12λn−112][M0M1⋮Mn]=[g0g1⋮gn]\begin{bmatrix} 2 & 1 & & & &\\ \mu_1 & 2 & \lambda_1 & & &\\ & \ddots & \ddots & \ddots & &\\ & & \mu_{n-1} & 2 & \lambda_{n-1} &\\ & & & 1 & 2 \end{bmatrix} \begin{bmatrix} M_0\\ M_1\\ \vdots\\ M_n\\ \end{bmatrix}= \begin{bmatrix} g_0\\ g_1\\ \vdots\\ g_n \end{bmatrix}

Natural boundary | 自由边界

根据之前的假设,有 M0=S′′(x0)=y0′′M_0=S''(x_0)=y''_0,Mn=S′′(xn)=yn′′M_n=S''(x_n)=y''_n,则

λ0=0,g0=2y0′′,μn=0,gn=2yn′′\lambda_0 = 0, g_0 = 2y''_0, \mu_n = 0, g_n = 2y''_n

当 S′′(x0)=S′′(xn)=0S''(x_0)=S''(x_n)=0,我们称之为自由边界(free boundary),此时 g0=gn=0g_0=g_n=0。

[200μ12λ1⋱⋱⋱μn−12λn−1002](n+1)×(n+1)[M0M1⋮Mn−1Mn](n+1)×1=[g0g1⋮gn−1gn](n+1)×1\begin{bmatrix} 2 & 0 & 0 & & &\\ \mu_1 & 2 & \lambda_1 & \\ & \ddots & \ddots & \ddots & \\ & & \mu_{n-1} & 2 & \lambda_{n-1} \\ & & 0& 0 & 2 \end{bmatrix}_{(n+1)\times (n+1)} \begin{bmatrix} M_0\\ M_1\\ \vdots\\ M_{n-1}\\ M_n\\ \end{bmatrix}_{(n+1)\times 1}= \begin{bmatrix} g_0\\ g_1\\ \vdots\\ g_{n-1}\\ g_n \end{bmatrix}_{(n+1)\times 1}

自由边界的情况下,有 S′′(x0)=S′′(xn)=0S''(x_0)=S''(x_n)=0。

书上的方法

我们介绍另一种构造三次样条插值的方法:

给定在 [a,b][a,b] 上的 n+1n+1 个点 x0,x1,⋯ ,xnx_0,x_1,\cdots,x_n,a=x0<x1<⋯<xn=ba=x_0<x_1<\cdots<x_n=b,设三次多项式 Sj(x)S_j(x) 为

Sj(x)=aj+bj(x−xj)+cj(x−xj)2+dj(x−xj)3,j=0,1,⋯ ,n−1S_j(x)=a_j+b_j(x-x_{j})+c_j(x-x_{j})^2+d_j(x-x_{j})^3,\quad j=0,1,\cdots,n-1

且满足

  1. S(x)S(x) 在每个子区间 [xi,xi+1][x_i,x_{i+1}] 上是一个三次多项式,i=0,1,⋯ ,n−1i=0,1,\cdots,n-1
  2. S(xi)=f(xi)S(x_i)=f(x_i),i=0,1,⋯ ,ni=0,1,\cdots,n
  3. Si+1(xi+1)=Si(xi+1)S_{i+1}(x_{i+1})=S_i(x_{i+1}),i=0,1,⋯ ,n−2i=0,1,\cdots,n-2
  4. Si+1′(xi+1)=Si′(xi+1)S'_{i+1}(x_{i+1})=S'_i(x_{i+1}),i=0,1,⋯ ,n−2i=0,1,\cdots,n-2
  5. Si+1′′(xi+1)=Si′′(xi+1)S''_{i+1}(x_{i+1})=S''_i(x_{i+1}),i=0,1,⋯ ,n−2i=0,1,\cdots,n-2
  6. 下列的边界条件之一成立:
    1. S′′(x0)=S′′(xn)=0S''(x_0)=S''(x_n)=0,称为自由或自然边界(free or natural boundary)
    2. S′(x0)=f′(x0)S'(x_0)=f'(x_0),S′(xn)=f′(xn)S'(x_n)=f'(x_n),称为固支边界(clamped boundary)
    3. 其他边界条件(上面两个条件其实已经足以满足目的了)

记 hj=xj−xj−1h_j=x_j-x_{j-1},由条件3,可得

aj+1=Sj+1(xj+1)=Sj(xj+1)=aj+bjhj+cjhj2+djhj3,j=0,1,⋯ ,n−1a_{j+1}=S_{j+1}(x_{j+1})=S_j(x_{j+1})=a_j+b_jh_j+c_jh_j^2+d_jh_j^3,\quad j=0,1,\cdots,n-1

又由条件4,因为 S′(x)=bj+2cj(x−xj)+3dj(x−xj)2S'(x)=b_j+2c_j(x-x_j)+3d_j(x-x_j)^2,所以

bj+1=Sj+1′(xj+1)=Sj′(xj+1)=bj+2cjhj+3djhj2,j=0,1,⋯ ,n−1b_{j+1}=S'_{j+1}(x_{j+1})=S'_j(x_{j+1})=b_j+2c_jh_j+3d_jh_j^2,\quad j=0,1,\cdots,n-1

又由条件5,因为 S′′(x)=2cj+6dj(x−xj)S''(x)=2c_j+6d_j(x-x_j),所以

cj+1=Sj+1′′(xj+1)2=cj+3djhj,j=0,1,⋯ ,n−1c_{j+1}=\frac{S''_{j+1}(x_{j+1})}{2}=c_j+3d_jh_j,\quad j=0,1,\cdots,n-1

所以

{aj+1=aj+bjhj+cjhj2+djhj3bj+1=bj+2cjhj+3djhj2cj+1=cj+3djhj,j=0,1,⋯ ,n−1\begin{cases} a_{j+1}=a_j+b_jh_j+c_jh_j^2+d_jh_j^3\\ b_{j+1}=b_j+2c_jh_j+3d_jh_j^2\\ c_{j+1}=c_j+3d_jh_j \end{cases},\quad j=0,1,\cdots,n-1

把最后一个式子代入前两个式子,消去 djd_j,得到

{aj+1=aj+bjhj+hj23(2cj+cj+1)bj+1=bj+hj(cj+cj+1),j=0,1,⋯ ,n−1\begin{cases} a_{j+1}=a_j+b_jh_j+\frac{h_j^2}{3}(2c_j+c_{j+1})\\ b_{j+1}=b_j+h_j(c_j+c_{j+1})\\ \end{cases},\quad j=0,1,\cdots,n-1

为了减少未知数,我们有

aj+1=aj+bjhj+hj23(2cj+cj+1)⇒{bj=1hj(aj+1−aj)−hj3(2cj+cj+1)bj−1=1hj−1(aj−aj−1)−hj−13(2cj−1+cj)bj+1=bj+hj(cj+cj+1)⇒bj=bj−1+hj−1(cj−1+cj)\begin{aligned} a_{j+1}=a_j+b_jh_j+\frac{h_j^2}{3}(2c_j+c_{j+1})&\Rightarrow \begin{cases} b_j=\frac{1}{h_j}(a_{j+1}-a_j)-\frac{h_j}{3}(2c_j+c_{j+1})\\ b_{j-1}=\frac{1}{h_{j-1}}(a_{j}-a_{j-1})-\frac{h_{j-1}}{3}(2c_{j-1}+c_{j}) \end{cases}\\ b_{j+1}=b_j+h_j(c_j+c_{j+1})&\Rightarrow b_j=b_{j-1}+h_{j-1}(c_{j-1}+c_j) \end{aligned}

所以

{bj=1hj(aj+1−aj)−hj3(2cj+cj+1)bj−1=1hj−1(aj−aj−1)−hj−13(2cj−1+cj)bj=bj−1+hj−1(cj−1+cj)⇒1hj(aj+1−aj)−hj3(2cj+cj+1)=1hj−1(aj−aj−1)−hj−13(2cj−1+cj)+hj−1(cj−1+cj)⇒hj−1cj−1+2(hj−1+hj)cj+hjcj+1=3hj(aj+1−aj)−3hj−1(aj−aj−1)(j=1,2,⋯ ,n−1)\begin{aligned} &\begin{cases} b_j&=\frac{1}{h_j}(a_{j+1}-a_j)-\frac{h_j}{3}(2c_j+c_{j+1})\\ b_{j-1}&=\frac{1}{h_{j-1}}(a_{j}-a_{j-1})-\frac{h_{j-1}}{3}(2c_{j-1}+c_{j})\\ b_j&=b_{j-1}+h_{j-1}(c_{j-1}+c_j) \end{cases}\\ &\Rightarrow \frac{1}{h_j}(a_{j+1}-a_j)-\frac{h_j}{3}(2c_j+c_{j+1}) =\frac{1}{h_{j-1}}(a_{j}-a_{j-1})-\frac{h_{j-1}}{3}(2c_{j-1}+c_{j})+h_{j-1}(c_{j-1}+c_j)\\ &\Rightarrow h_{j-1}c_{j-1}+2(h_{j-1}+h_j)c_j+h_jc_{j+1} =\frac{3}{h_j}(a_{j+1}-a_j)-\frac{3}{h_{j-1}}(a_{j}-a_{j-1}) \quad (j=1,2,\cdots,n-1)\\ \end{aligned}

因为 aja_j, hjh_j 已知,所以上式未知量仅为 cjc_j,而且求出 cjc_j 后,bjb_j 也就求出了。(bj=1hj(aj+1−aj)−hj3(2cj+cj+1)b_j=\frac{1}{h_j}(a_{j+1}-a_j)-\frac{h_j}{3}(2c_j+c_{j+1}))

所以我们有 n−1n-1 个方程,n+1n+1 个未知数,所以我们需要额外的两个方程。

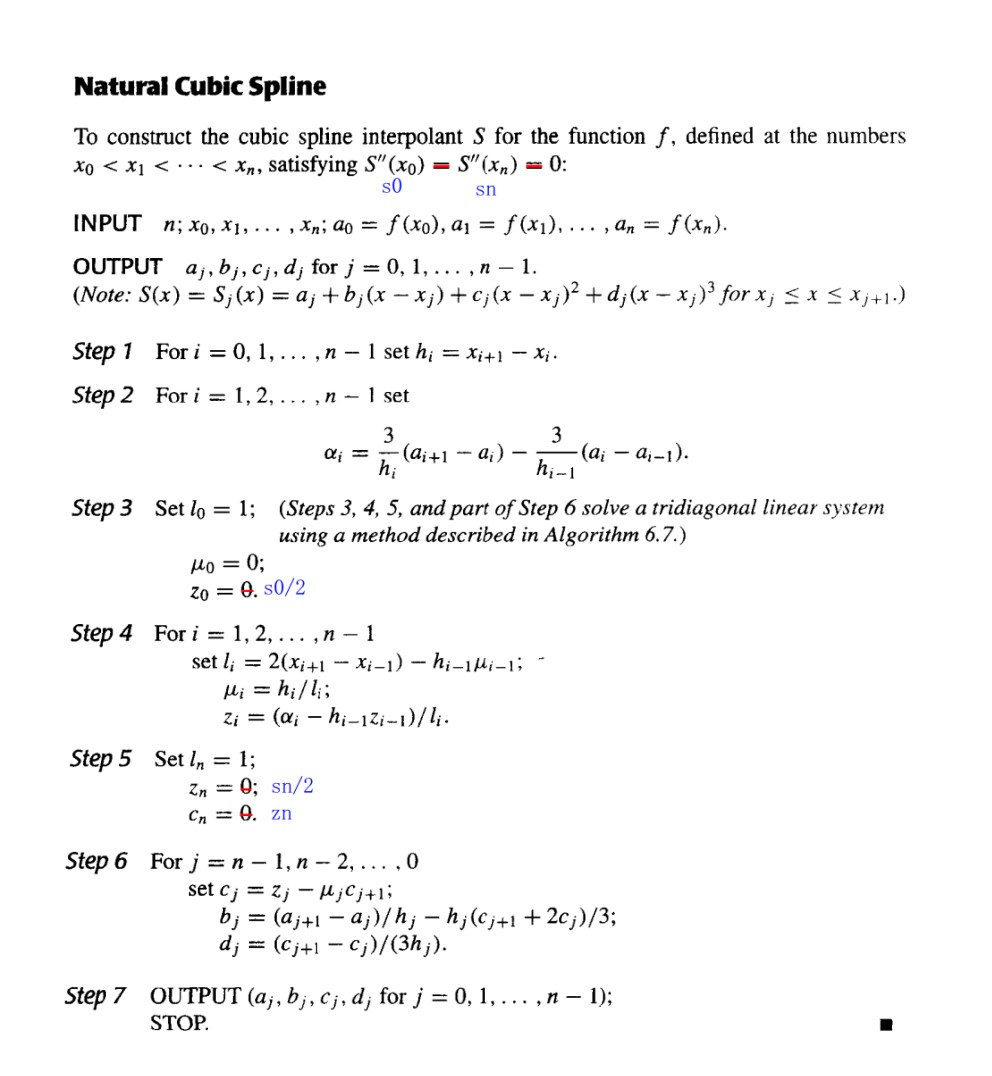
Natural boundary | 自由边界

书上给的是 S′′(a)=S′′(b)=0S''(a)=S''(b)=0,实际上,我们在做题中扩展到了 S′′(a)=s0S''(a)=s_0,S′′(b)=snS''(b)=s_n,此时

c0=S′′(a)2=s02,cn=S′′(b)2=sn2c_0=\frac{S''(a)}{2}=\frac{s_0}{2},\quad c_n=\frac{S''(b)}{2}=\frac{s_n}{2}

所以,我们可以将上面的方程组写成 Ax=b\mathbf{Ax}=\mathbf{b} 的形式,其中 A\mathbf{A} 为 (n+1)×(n+1)(n+1)\times(n+1) 的矩阵

A=[100⋯000h02(h0+h1)h1⋯0000h12(h1+h2)⋯000⋮⋮⋮⋱⋮⋮⋮000⋯hn−22(hn−2+hn−1)hn−1000⋯001]\mathbf{A}=\begin{bmatrix} 1&0&0&\cdots&0&0&0\\ h_0&2(h_0+h_1)&h_1&\cdots&0&0&0\\ 0&h_1&2(h_1+h_2)&\cdots&0&0&0\\ \vdots&\vdots&\vdots&\ddots&\vdots&\vdots&\vdots\\ 0&0&0&\cdots&h_{n-2}&2(h_{n-2}+h_{n-1})&h_{n-1}\\ 0&0&0&\cdots&0&0&1 \end{bmatrix}

b\mathbf{b} 和 x\mathbf{x} 为 (n+1)×1(n+1)\times1 的向量

b=[s023h1(a2−a1)−3h0(a1−a0)3h2(a3−a2)−3h1(a2−a1)⋮3hn−1(an−an−1)−3hn−2(an−1−an−2)sn2],x=[c0c1c2⋮cn−1cn]\mathbf{b}=\begin{bmatrix} \frac{s_0}{2}\\ \frac{3}{h_1}(a_{2}-a_1)-\frac{3}{h_0}(a_{1}-a_0)\\ \frac{3}{h_2}(a_{3}-a_2)-\frac{3}{h_1}(a_{2}-a_1)\\ \vdots\\ \frac{3}{h_{n-1}}(a_{n}-a_{n-1})-\frac{3}{h_{n-2}}(a_{n-1}-a_{n-2})\\ \frac{s_n}{2} \end{bmatrix} ,\quad \mathbf{x}=\begin{bmatrix} c_0\\ c_1\\ c_2\\ \vdots\\ c_{n-1}\\ c_n \end{bmatrix}

因为矩阵 A\mathbf{A} 是严格对角占优的,所以该方程组有唯一解。

伪代码

Alt text

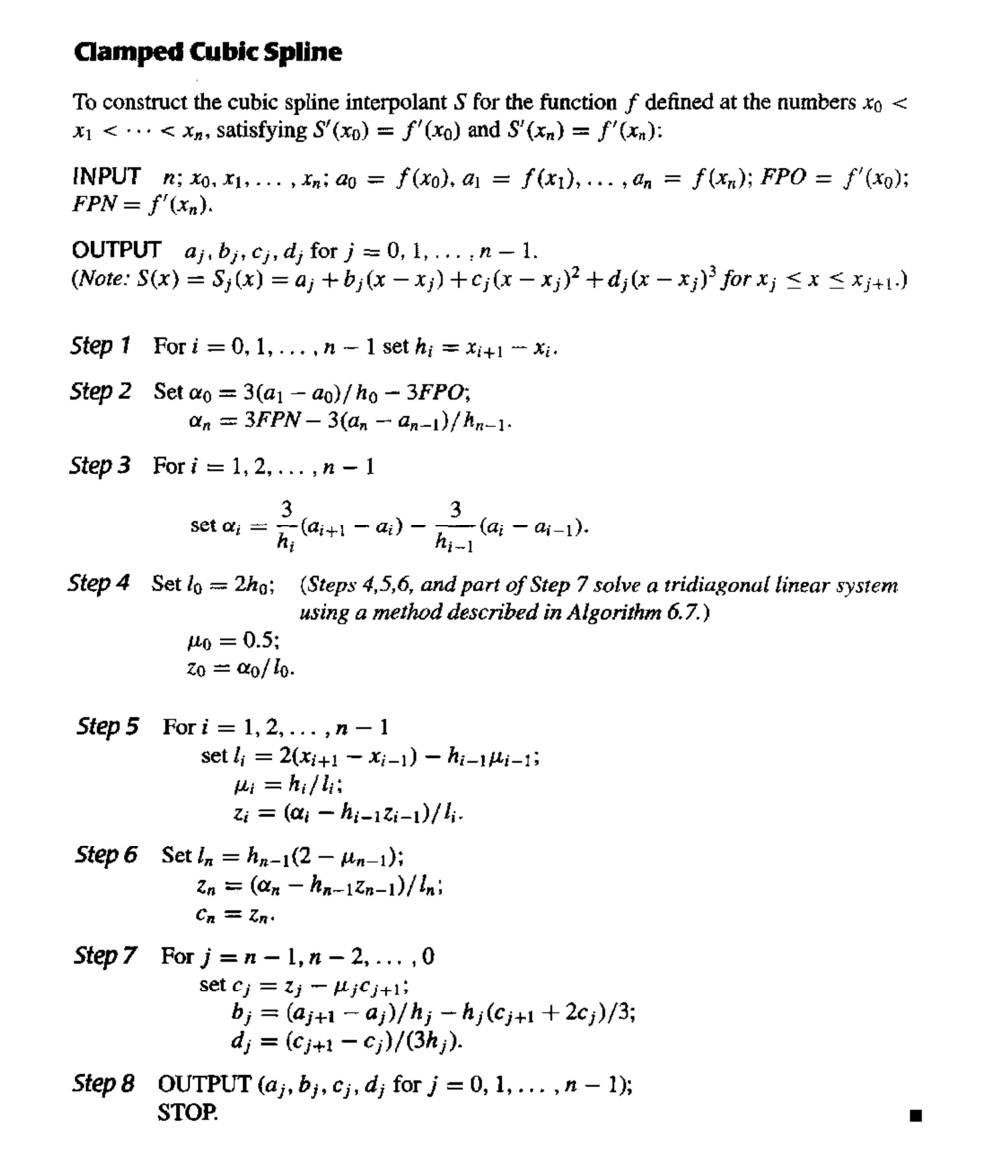
固支边界

固支边界要求 S′(a)=f′(a)S'(a)=f'(a),S′(b)=f′(b)S'(b)=f'(b)。

因为 f′(a)=S′(a)=S′(x0)=b0f'(a)=S'(a)=S'(x_0)=b_0,f′(b)=S′(b)=S′(xn)=bnf'(b)=S'(b)=S'(x_n)=b_n,所以

{f′(a)=b0=1h0(a1−a0)−h03(2c0+c1)f′(b)=bn=bn−1+hn−1(cn−1+cn)=1hn−1(an−an−1)+hn−13(cn−1+2cn)⇒{2h0c0+h0c1=3h0(a1−a0)−3f′(a)hn−1cn−1+2hn−1cn=3f′(b)−3hn−1(an−an−1)\begin{aligned} &\begin{cases} f'(a)&=b_0=\frac{1}{h_0}(a_1-a_0)-\frac{h_0}{3}(2c_0+c_1)\\ f'(b)&=b_n=b_{n-1}+h_{n-1}(c_{n-1}+c_n)=\frac{1}{h_{n-1}}(a_{n}-a_{n-1})+\frac{h_{n-1}}{3}(c_{n-1}+2c_n) \end{cases}\\ \Rightarrow& \begin{cases} 2h_0c_0+h_0c_1&=\frac{3}{h_0}(a_1-a_0)-3f'(a)\\ h_{n-1}c_{n-1}+2h_{n-1}c_n&=3f'(b)-\frac{3}{h_{n-1}}(a_n-a_{n-1}) \end{cases} \end{aligned}

所以,我们可以将上面的方程组写成 Ax=b\mathbf{Ax}=\mathbf{b} 的形式,其中 A\mathbf{A} 为 (n+1)×(n+1)(n+1)\times(n+1) 的矩阵

A=[2h0h00⋯000h02(h0+h1)h1⋯0000h12(h1+h2)⋯000⋮⋮⋮⋱⋮⋮⋮000⋯hn−22(hn−2+hn−1)hn−1000⋯0hn−12hn−1]\mathbf{A}=\begin{bmatrix} 2h_0&h_0&0&\cdots&0&0&0\\ h_0&2(h_0+h_1)&h_1&\cdots&0&0&0\\ 0&h_1&2(h_1+h_2)&\cdots&0&0&0\\ \vdots&\vdots&\vdots&\ddots&\vdots&\vdots&\vdots\\ 0&0&0&\cdots&h_{n-2}&2(h_{n-2}+h_{n-1})&h_{n-1}\\ 0&0&0&\cdots&0&h_{n-1}&2h_{n-1} \end{bmatrix}

b\mathbf{b} 和 x\mathbf{x} 为 (n+1)×1(n+1)\times1 的向量

b=[3h0(a1−a0)−3f′(a)3h1(a2−a1)−3h0(a1−a0)3h2(a3−a2)−3h1(a2−a1)⋮3hn−1(an−an−1)−3hn−2(an−1−an−2)3f′(b)−3hn−1(an−an−1)],x=[c0c1c2⋮cn−1cn]\mathbf{b}=\begin{bmatrix} \frac{3}{h_0}(a_1-a_0)-3f'(a)\\ \frac{3}{h_1}(a_{2}-a_1)-\frac{3}{h_0}(a_{1}-a_0)\\ \frac{3}{h_2}(a_{3}-a_2)-\frac{3}{h_1}(a_{2}-a_1)\\ \vdots\\ \frac{3}{h_{n-1}}(a_{n}-a_{n-1})-\frac{3}{h_{n-2}}(a_{n-1}-a_{n-2})\\ 3f'(b)-\frac{3}{h_{n-1}}(a_n-a_{n-1}) \end{bmatrix} ,\quad \mathbf{x}=\begin{bmatrix} c_0\\ c_1\\ c_2\\ \vdots\\ c_{n-1}\\ c_n \end{bmatrix}

因为矩阵 A\mathbf{A} 是严格对角占优的,所以该方程组有唯一解。

伪代码

Alt text

Properties of cubic splines | 三次样条的性质

Chapter 4 数值微分与积分 | Numerical Differentiation and Integration

4.1 数值微分 | Numerical Differentiation

两点法

最简单的方法:用两个点,取h>0h>0

Forward : f′(x)=f(x+h)−f(x)h+O(h)f'(x) = \frac{f(x+h) - f(x)}{h} + O(h)

Backward : f′(x)=f(x)−f(x−h)h+O(h)f'(x) = \frac{f(x) - f(x-h)}{h} + O(h)

Alt text

构造由 x0x_0 和 x0+hx_0+h 确定的一次 Lagrange 插值多项式:

f(x)=f(x0)(x−x0−h)x0−x0−h+f(x0+h)(x−x0)x0+h−x0+(x−x0)(x−x0−h)2!f′′(ξx)f′(x)=f(x0+h)−f(x0)h+2(x−x0)−h2f′′(ξx)+(x−x0)(x−x0−h)2!ddxf′′(ξx)f′(x0)=f(x0+h)−f(x0)h−h2f′′(ξx)\begin{aligned} f(x) &=\frac{f(x_0)(x-x_0-h)}{x_0-x_0-h}+\frac{f(x_0+h)(x-x_0)}{x_0+h-x_0} + \frac{(x-x_0)(x-x_0-h)}{2!}f''(\xi_x) \\ f'(x) &= \frac{f(x_0+h)-f(x_0)}{h} + \frac{2(x-x_0)-h}{2}f''(\xi_x) + \frac{(x-x_0)(x-x_0-h)}{2!}\frac{\mathrm{d}}{\mathrm{d}x}f''(\xi_x) \\ f'(x_0) &= \frac{f(x_0+h)-f(x_0)}{h} - \frac{h}{2}f''(\xi_x) \end{aligned}

一般方法

用 n+1n+1 个点,构造 nn 次 Lagrange 插值多项式:

f(x)=∑k=0nf(xk)Lk(x)+(x−x0)⋯(x−xn)(n+1)!f(n+1)(ξx)f′(xj)=∑k=0nf(xk)Lk′(xj)+f(n+1)(ξj)(n+1)!∏k=0,k≠jn(xj−xk)\begin{aligned}f(x)&=\sum\limits_{k=0}^nf(x_k)L_k(x)+\frac{(x-x_0)\cdots(x-x_n)}{(n+1)!}f^{(n+1)}(\xi_x)\\ f^{\prime}(x_j)&=\sum\limits_{k=0}^nf(x_k)L_k^{\prime}(x_j)+\frac{f^{(n+1)}(\xi_j)}{(n+1)!}\prod_{k = 0,k\neq j}^n(x_j-x_k) \end{aligned}

总体而言,更多的评估点会产生更高的准确性。另一方面,功能评估的数量增加,舍入误差也会增加。因此,数值微分是不稳定的!

三点公式

因为

L0(x)=(x−x1)(x−x2)(x0−x1)(x0−x2)L_0(x) = \frac{(x-x_1)(x-x_2)}{(x_0-x_1)(x_0-x_2)}

所以

L0′(x)=2x−x1−x2(x0−x1)(x0−x2)L'_0(x) = \frac{2x-x_1-x_2}{(x_0-x_1)(x_0-x_2)}

同理有

L1′(x)=2x−x0−x2(x1−x0)(x1−x2)L'_1(x) = \frac{2x-x_0-x_2}{(x_1-x_0)(x_1-x_2)}

L2′(x)=2x−x0−x1(x2−x0)(x2−x1)L'_2(x) = \frac{2x-x_0-x_1}{(x_2-x_0)(x_2-x_1)}

所以

f′(xj)=f(x0)2xj−x1−x2(x0−x1)(x0−x2)+f(x1)2xj−x0−x2(x1−x0)(x1−x2)+f(x2)2xj−x0−x1(x2−x0)(x2−x1)+f(3)(ξj)3!∏k=0,k≠j2(xj−xk)\begin{aligned} f'(x_j) =& f(x_0)\frac{2x_j-x_1-x_2}{(x_0-x_1)(x_0-x_2)} + f(x_1)\frac{2x_j-x_0-x_2}{(x_1-x_0)(x_1-x_2)} \\&+ f(x_2)\frac{2x_j-x_0-x_1}{(x_2-x_0)(x_2-x_1)}+\frac{f^{(3)}(\xi_j)}{3!}\prod_{k=0,k\neq j}^2(x_j-x_k) \end{aligned}

如果 x0,x1,x2x_0,x_1,x_2 等距,即 x1=x0+h,x2=x0+2hx_1=x_0+h,x_2=x_0+2h,则

f′(xj)=f(x0)2xj−2x0−3h2h2+f(x1)2xj−2x0−2h−h2+f(x2)2xj−2x0−h2h2+f(3)(ξj)3!∏k=0,k≠j2(xj−xk)\begin{aligned} f'(x_j) =& f(x_0)\frac{2x_j-2x_0-3h}{2h^2} + f(x_1)\frac{2x_j-2x_0-2h}{-h^2} \\&+ f(x_2)\frac{2x_j-2x_0-h}{2h^2}+\frac{f^{(3)}(\xi_j)}{3!}\prod_{k=0,k\neq j}^2(x_j-x_k) \end{aligned}

所以

f′(x0)=1h(−32f(x0)+2f(x0+h)−12f(x0+2h))+h23f(3)(ξ0)f′(x1)=1h(−12f(x0)+12f(x0+2h))−h26f(3)(ξ1)f′(x2)=1h(12f(x0)−2f(x0+h)+32f(x0+2h))+h23f(3)(ξ2)\begin{aligned} f'(x_0) &= \frac{1}{h}(-\frac{3}{2}f(x_0)+2f(x_0+h)-\frac{1}{2}f(x_0+2h))+\frac{h^2}{3}f^{(3)}(\xi_0)\\ f'(x_1) &= \frac{1}{h}(-\frac{1}{2}f(x_0)+\frac{1}{2}f(x_0+2h))-\frac{h^2}{6}f^{(3)}(\xi_1)\\ f'(x_2) &= \frac{1}{h}(\frac{1}{2}f(x_0)-2f(x_0+h)+\frac{3}{2}f(x_0+2h))+\frac{h^2}{3}f^{(3)}(\xi_2) \end{aligned}

显然,中间的点误差最小,所以,我们可以用这种方法来估计导数值,即

f′(x0)=12h[f(x0+h)−f(x0−h)]−h26f(3)(ξ1)f^{\prime}(x_0)=\frac1{2h}[f(x_0+h)-f(x_0-h)]-\frac{h^2}6f^{(3)}(\xi_1)

Alt text

二阶导数

将函数 ff 在 x0x_0 处展开为三阶 Taylor 多项式,并求在 x0+hx_0+h 和 x0−hx_0-h 处的值:

f(x0+h)=f(x0)+f′(x0)h+12f′′(x0)h2+16f′′′(x0)h3+124f(4)(ξ1)h4f(x0−h)=f(x0)−f′(x0)h+12f′′(x0)h2−16f′′′(x0)h3+124f(4)(ξ−1)h4\begin{gathered} f(x_0+h)=f(x_0)+f^{\prime}(x_0)h+\frac12f^{\prime\prime}(x_0)h^2+\frac16f^{\prime\prime\prime}(x_0)h^3+\frac1{24}f^{(4)}(\xi_1)h^4 \\ f(x_0-h)=f(x_0)-f^{\prime}(x_0)h+\frac12f^{\prime\prime}(x_0)h^2-\frac16f^{\prime\prime\prime}(x_0)h^3+\frac1{24}f^{(4)}(\xi_{-1})h^4 \end{gathered}

将上面两式相加,得

f′′(x0)=f(x0+h)−2f(x0)+f(x0−h)h2−h224[f(4)(ξ1)+f(4)(ξ−1)]f^{\prime\prime}(x_0)=\frac{f(x_0+h)-2f(x_0)+f(x_0-h)}{h^2}-\frac{h^2}{24}[f^{(4)}(\xi_1)+f^{(4)}(\xi_{-1})]

由于 f(4)f^{(4)} 是连续函数,所以存在 ξ\xi 使得

f(4)(ξ)=12[f(4)(ξ1)+f(4)(ξ−1)]f^{(4)}(\xi)=\frac12[f^{(4)}(\xi_1)+f^{(4)}(\xi_{-1})]

所以

f′′(x0)=f(x0+h)−2f(x0)+f(x0−h)h2−h212f(4)(ξ)f^{\prime\prime}(x_0)=\frac{f(x_0+h)-2f(x_0)+f(x_0-h)}{h^2}-\frac{h^2}{12}f^{(4)}(\xi)

4.3 数值积分基础 | Elements of Numerical Integration

对于没有显式原函数或原函数难以计算的函数,我们通过 数值求积(Numerical Quadrature) 来近似计算积分值:使用和 ∑i=0naif(xi)\sum\limits_{i=0}^n a_if(x_i) 来近似计算积分值 ∫abf(x)dx\int_a^b f(x)\mathrm{d}x。

为了确定系数 aia_i ,我们给出一种求积方法:

以第三章中给出的插值多项式为基础,得到 Lagrange 插值多项式:

Pn(x)=∑i=0nf(xi)Li(x)P_n(x)=\sum\limits_{i=0}^nf(x_i)L_i(x)

所以

∫abf(x)dx≈∫abPn(x)dx=∑i=0nf(xi)∫abLi(x)dx=∑i=0nf(xi)ai\int_a^b f(x)\mathrm{d}x\approx\int_a^b P_n(x)\mathrm{d}x=\sum\limits_{i=0}^nf(x_i)\int_a^b L_i(x)\mathrm{d}x=\sum\limits_{i=0}^n f(x_i)a_i

误差项为

∫abf(x)dx−∑i=0nf(xi)ai=∫ab(f(x)−Pn(x))dx=∫abf(n+1)(ξ)(n+1)!∏i=0n(x−xi)dx\int_a^b f(x)\mathrm{d}x-\sum\limits_{i=0}^n f(x_i)a_i=\int_a^b (f(x)-P_n(x))\mathrm{d}x=\int_a^b \frac{f^{(n+1)}(\xi)}{(n+1)!}\prod_{i=0}^n(x-x_i)\mathrm{d}x

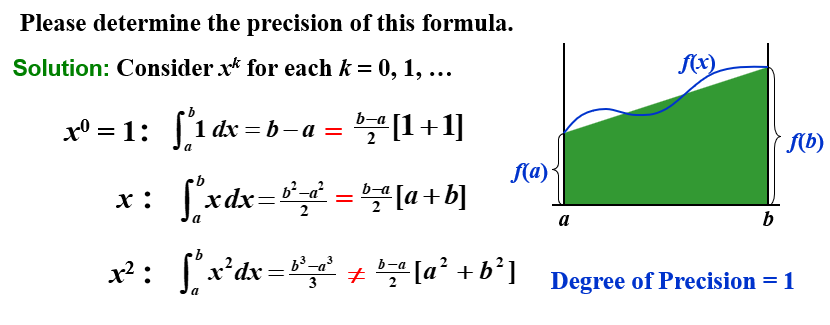
精确度 | Precision

求积公式的精确度 (precision/degree of accuracy) 是使得求积公式对 xkx^k 精确成立的最大正整数 kk。

通用法则 - Newton-Cotes 求积公式

在等距节点上(h=b−anh = \frac{b-a}{n}),考察系数 aia_i 的值,我们可以得到一些通用的求积法则:

ai=∫x0xnLi(x)dx=∫x0xn∏j=0,j≠inx−xjxi−xjdx\begin{aligned} a_i=\int_{x_0}^{x_n}L_i(x)\mathrm{d}x&=\int_{x_0}^{x_n}\prod_{j=0,j\neq i}^n\frac{x-x_j}{x_i-x_j}\mathrm{d}x\\ \end{aligned}

令 x=a+thx = a+th,则

ai=∫x0xn∏j=0,j≠inx−xjxi−xjdx=∫0n∏j=0,j≠in(t−j)h(i−j)h⋅hdt=h⋅(−1)n−ii!(n−i)!⋅∫0n∏j=0,j≠in(t−j)dt\begin{aligned} a_i&=\int_{x_0}^{x_n}\prod_{j=0,j\neq i}^n\frac{x-x_j}{x_i-x_j}\mathrm{d}x\\ &=\int_0^n\prod_{j=0,j\neq i}^n\frac{(t-j)h}{(i-j)h}\cdot h\mathrm{d}t\\ &=h\cdot \frac{(-1)^{n-i}}{i!(n-i)!}\cdot \int_0^n\prod_{j=0,j\neq i}^n(t-j)\mathrm{d}t\\ \end{aligned}

梯形法则 | Trapezoidal Rule

当 n=1n=1 时:

ai=h⋅(−1)1−ii!(1−i)!⋅∫01∏j=0,j≠i1(t−j)dta0=h⋅(−1)1−00!(1−0)!⋅∫01(t−1)dt=12ha1=h⋅(−1)1−11!(1−1)!⋅∫01(t−0)dt=12h\begin{aligned} a_i&=h\cdot \frac{(-1)^{1-i}}{i!(1-i)!}\cdot \int_0^1\prod_{j=0,j\neq i}^1(t-j)\mathrm{d}t\\ a_0&=h\cdot \frac{(-1)^{1-0}}{0!(1-0)!}\cdot \int_0^1(t-1)\mathrm{d}t=\frac{1}{2}h\\ a_1&=h\cdot \frac{(-1)^{1-1}}{1!(1-1)!}\cdot \int_0^1(t-0)\mathrm{d}t=\frac{1}{2}h\\ \end{aligned}

此时,n=1n=1 的求积公式为

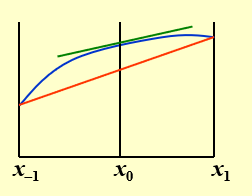
∫abf(x)dx=h2[f(a)+f(b)]−h312f′′(ξ)\int_a^b f(x)\mathrm{d}x = \frac{h}{2}[f(a)+f(b)]-\frac{h^3}{12}f''(\xi)

此即为 梯形法则(Trapezoidal Rule)。

精确度

梯形法则的精确度为 k=1k=1。

Alt text

Simpson 法则 | Simpson's Rule

当 n=2n=2 时:

ai=h⋅(−1)2−ii!(2−i)!⋅∫02∏j=0,j≠i2(t−j)dta0=h⋅(−1)2−00!(2−0)!⋅∫02(t−1)(t−2)dt=13ha1=h⋅(−1)2−11!(2−1)!⋅∫02(t−0)(t−2)dt=43ha2=h⋅(−1)2−22!(2−2)!⋅∫02(t−0)(t−1)dt=13h\begin{aligned} a_i&=h\cdot \frac{(-1)^{2-i}}{i!(2-i)!}\cdot \int_0^2\prod_{j=0,j\neq i}^2(t-j)\mathrm{d}t\\ a_0&=h\cdot \frac{(-1)^{2-0}}{0!(2-0)!}\cdot \int_0^2(t-1)(t-2)\mathrm{d}t=\frac{1}{3}h\\ a_1&=h\cdot \frac{(-1)^{2-1}}{1!(2-1)!}\cdot \int_0^2(t-0)(t-2)\mathrm{d}t=\frac{4}{3}h\\ a_2&=h\cdot \frac{(-1)^{2-2}}{2!(2-2)!}\cdot \int_0^2(t-0)(t-1)\mathrm{d}t=\frac{1}{3}h\\ \end{aligned}

此时,n=2n=2 的求积公式为

∫abf(x)dx=h3[f(a)+4f(a+b2)+f(b)]−h590f(4)(ξ)\int_a^b f(x)\mathrm{d}x = \frac{h}{3}[f(a)+4f(\frac{a+b}{2})+f(b)]-\frac{h^5}{90}f^{(4)}(\xi)

此即为 Simpson 法则(Simpson's Rule)。

其精确度为 k=3k=3。

Simpson 3/8 法则 | Simpson's 3/8 Rule

当 n=3n=3 时,求积公式为

∫abf(x)dx=3h8[f(a)+3f(2a+b3)+3f(a+2b3)+f(b)]−3h580f(4)(ξ)\begin{aligned} \int_a^b f(x)\mathrm{d}x &= \frac{3h}{8}[f(a)+3f(\frac{2a+b}{3})+3f(\frac{a+2b}{3})+f(b)]\\ &-\frac{3h^5}{80}f^{(4)}(\xi)\\ \end{aligned}

其精确度为 k=3k=3。

Cotes 求积公式 | Cotes Rule

当 n=4n=4 时,求积公式为

∫abf(x)dx=2h45[7f(a)+32f(3a+b4)+12f(a+b2)+32f(a+3b4)+7f(b)]−8h7945f(6)(ξ)\begin{aligned} \int_a^b f(x)\mathrm{d}x &= \frac{2h}{45}[7f(a)+32f(\frac{3a+b}{4})+12f(\frac{a+b}{2})+32f(\frac{a+3b}{4})+7f(b)]\\ &-\frac{8h^7}{945}f^{(6)}(\xi)\\ \end{aligned}

通用法则的一般结论

Alt text

注意:当 nn 是偶数时,精度的次数为 n+1n+1,即使插值多项式的次数至多为 nn。在 nn 是奇数的情况,精度的次数仅为 nn。

4.4 复合数值积分 | Composite Numerical Integration

Newton-Cotes 以等距节点的插值多项式为基础。由于高次多项式的振荡性,这个过程在大的区间上是不精确的。为了解决这个问题,我们采用低阶 Newton-Cotes 的分段(piecewise)方法。

复合梯形法则 | Composite Trapezoidal Rule

将区间 [a,b][a,b] 分成 nn 个子区间,每个子区间长度为 h=b−anh = \frac{b-a}{n},则

∫xk−1xkf(x)dx≈xk−xk−12[f(xk−1)+f(xk)], k=1,...,n\int_{x_{k-1}}^{x_k}f(x)dx\approx\frac{x_k-x_{k-1}}2[f(x_{k-1})+f(x_k)],\mathrm{~}k=1,...,n

∫abf(x)dx=∑i=0n−1∫xixi+1f(x)dx=h2[f(a)+2∑j=1n−1f(xj)+f(b)]=Tn\int_a^b f(x)\mathrm{d}x = \sum\limits_{i=0}^{n-1}\int_{x_i}^{x_{i+1}}f(x)\mathrm{d}x=\frac{h}{2}[f(a)+2\sum\limits_{j=1}^{n-1}f(x_j)+f(b)]=\color{blue}{T_n}

其中,xi=a+ihx_i = a+ih,ξ∈[a,b]\xi\in[a,b]。

误差项为

∫abf(x)dx−Tn=h212(b−a)f′′(ξ)\int_a^b f(x)\mathrm{d}x-T_n=\frac{h^2}{12}(b-a)f''(\xi)

复合 Simpson 法则 | Composite Simpson's Rule

nn 必须是偶数。

将区间 [a,b][a,b] 分成 nn 个子区间,每个子区间长度为 h=b−anh = \frac{b-a}{n},则

∫xkxk+1f(x)dx≈h6[f(xk)+4f(xk+12)+f(xk+1)]\int_{x_k}^{x_{k+1}}f(x)dx\approx\frac h6[f(x_k)+4f(x_{k+\frac12})+f(x_{k+1})]

∫abf(x)dx≈h6[f(a)+4∑k=0n−1f(xk+12)+2∑k=0n−2f(xk+1)+f(b)]=Sn\int_a^bf(x)dx\approx\frac h6[f(a)+4\sum\limits_{k=0}^{n-1}f(x_{k+\frac12})+2\sum\limits_{k=0}^{n-2}f(x_{k+1})+f(b)]=\color{blue}{S_n}

其中,xi=a+ihx_i = a+ih,ξ∈[a,b]\xi\in[a,b]。

误差项为

∫abf(x)dx−Sn=−b−a180(h2)4f(4)(ξ)\int_a^b f(x)\mathrm{d}x-S_n=-\frac{b-a}{180}(\frac{h}2)^4f^{(4)}(\xi)

为简化表达,我们取 n′=2nn'=2n,则 h′=b−an′=h2h' = \frac{b-a}{n'} = \frac{h}{2},x2k=xkx_{2k} = x_k,x2k+1=xk+h2x_{2k+1} = x_k+\frac{h}{2},则

∫abf(x)dx≈h′3[f(a)+4∑odd  kf(xk)+2∑even  kf(xk)+f(b)]=Sn′\int_a^bf(x)dx\approx\frac{h'}3[f(a)+4\sum\limits_{odd\;k}f(x_{k})+2\sum\limits_{even\;k}f(x_{k})+f(b)]=\color{blue}{S_{n'}}

例题

Alt text

舍入误差的稳定性

所有的复合积分方法共有的一个重要性质是 舍入误差的稳定性。
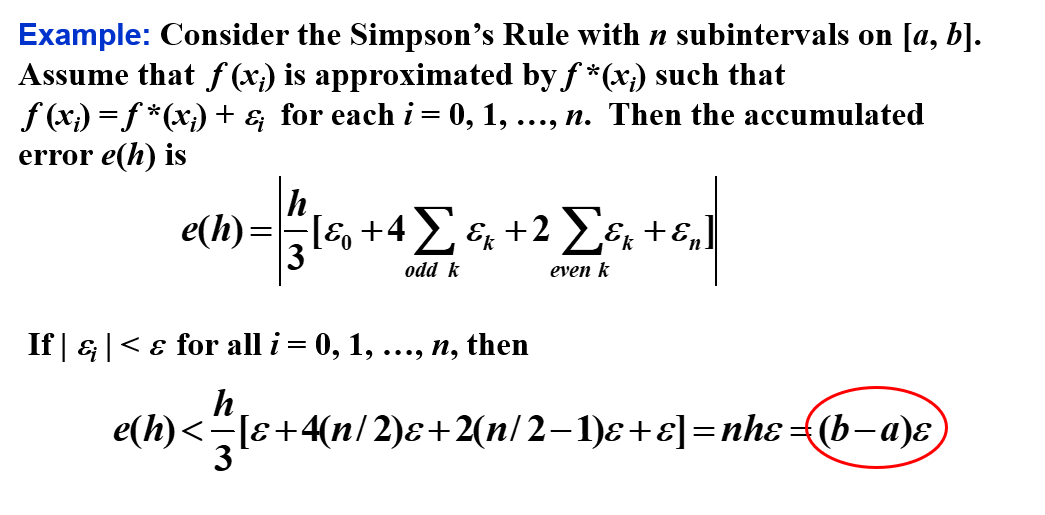
Alt text

可见,误差界与 hh 和 nn 无关。这说明即使将一个区间分成更多子区间,也不会增加舍入误差。

4.5 Romberg 积分 | Romberg Integration

考察残差项,对于梯形法则,有

R2n[f]=−(h2)2112(b−a)f′′(ξ)≈14Rn[f]R_{2n}[f]=-(\frac{h}{2})^2\frac{1}{12}(b-a)f''(\xi)\approx\frac{1}{4}R_n[f]

所以

I−T2nI−Tn≈14\frac{I-T_{2n}}{I-T_n}\approx\frac{1}{4}

即

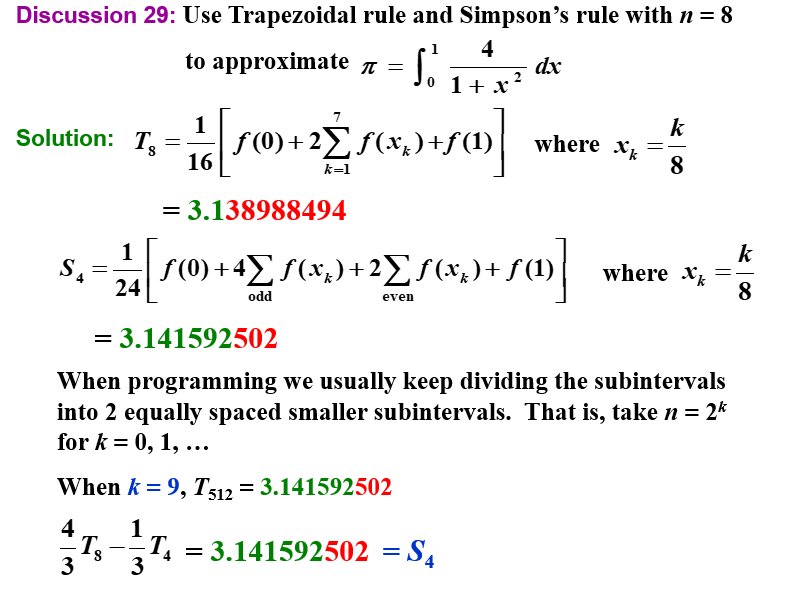
I≈4T2n−Tn4−1=43T2n−13Tn=SnI\approx\frac{4T_{2n}-T_n}{4-1}=\frac43T_{2n}-\frac13T_n=\color{blue}{S_n}

同理,总体上,我们有

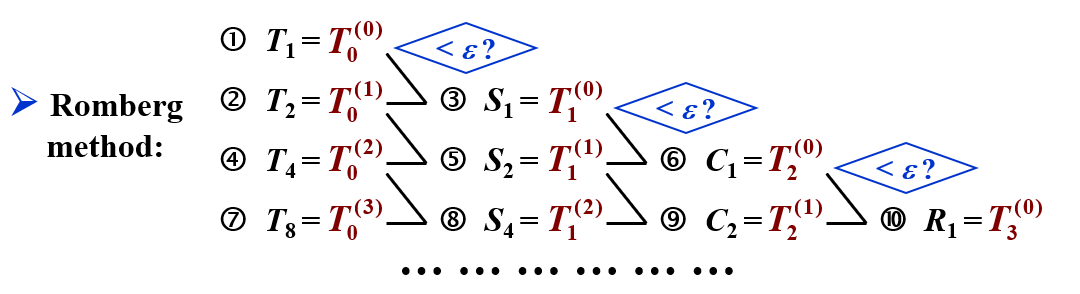
4T2n−Tn4−1=Sn,42S2n−Sn42−1=Cn,43C2n−Cn43−1=Rn,...\frac{4T_{2n}-T_n}{4-1}= S_n, \frac{4^2S_{2n}-S_n}{4^2-1}=C_n, \frac{4^3C_{2n}-C_n}{4^3-1}=R_n, ...

这里的 RnR_n 就是 Romberg 积分。

所以算法为:

Alt text

其中,每一步计算误差有没有到,如果没到,继续向后算。

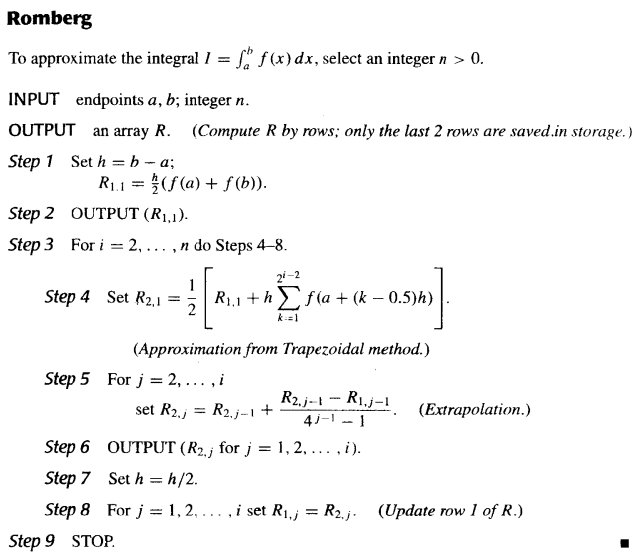
伪代码

Alt text

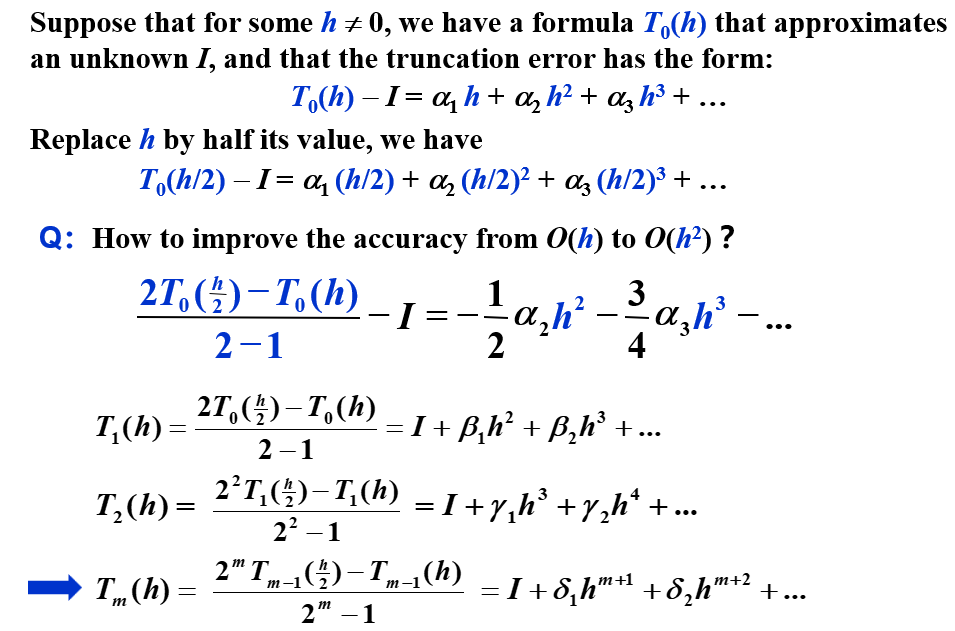
4.2 Richardson 外推法 | Richardson's Extrapolation

Target:使用低阶公式产生高精度的结果。

Alt text

4.6 自适应求积方法 | Adaptive Quadrature Methods

Target: 预测函数变化的大小,使步长适应变化的需求。

其实就是先整体估摸着求积,然后看看精度如何(此处判断精度的方式是与上一次得到的值作比较,以比值为判断条件——如果本次和上次的值差不多,说明趋于收敛);如果不够,就再细分一下,再求积。

举个例子:
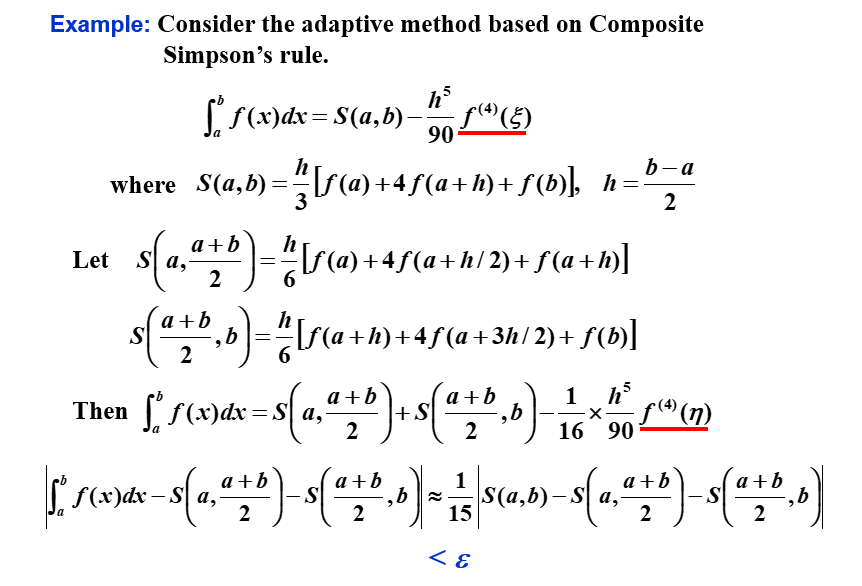
Alt text

这里可以看到,S(a,a+b2)+S(a+b2,b)S(a,\frac{a+b}{2})+S(\frac{a+b}{2},b) 逼近 ∫abf(x)dx\int_a^b f(x)\mathrm{d}x 的效果比 S(a,a+b2)+S(a+b2,b)S(a,\frac{a+b}{2})+S(\frac{a+b}{2},b) 逼近S(a,b)S(a,b) 好15倍。

4.7 Gauss 求积 | Gauss Quadrature

Target: 通过选择 n+1n+1 个合适的节点,使得求积公式的精度达到 2n+12n+1。

"例子"

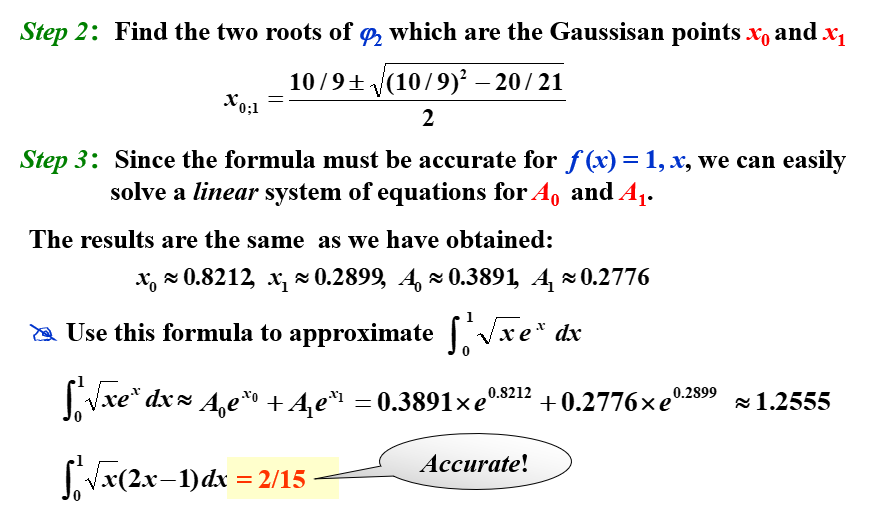
用 Gauss 求积公式,在 n=1n=1 的情况下估计 ∫−11xf(x)dx\int_{-1}^1 \sqrt{x}f(x)\mathrm{d}x,则精度为3,需满足 f(x)=1,x,x2,x3f(x)=1,x,x^2,x^3。

设 ∫−11xf(x)dx≈A0f(x0)+A1f(x1)\int_{-1}^1 \sqrt{x}f(x)\mathrm{d}x \approx A_0f(x_0)+A_1f(x_1),则

{∫−11xdx=A0+A1∫−11xxdx=A0x0+A1x1∫−11xx2dx=A0x02+A1x12∫−11xx3dx=A0x03+A1x13\begin{cases} \int_{-1}^1 \sqrt{x}\mathrm{d}x = A_0+A_1 \\ \int_{-1}^1 \sqrt{x}x\mathrm{d}x = A_0x_0+A_1x_1 \\ \int_{-1}^1 \sqrt{x}x^2\mathrm{d}x = A_0x_0^2+A_1x_1^2 \\ \int_{-1}^1 \sqrt{x}x^3\mathrm{d}x = A_0x_0^3+A_1x_1^3 \\ \end{cases}

由此可求得四个未知数,从而得到求积公式

但是,求解非线性方程组是很困难的,所以我们采用另一种方法。

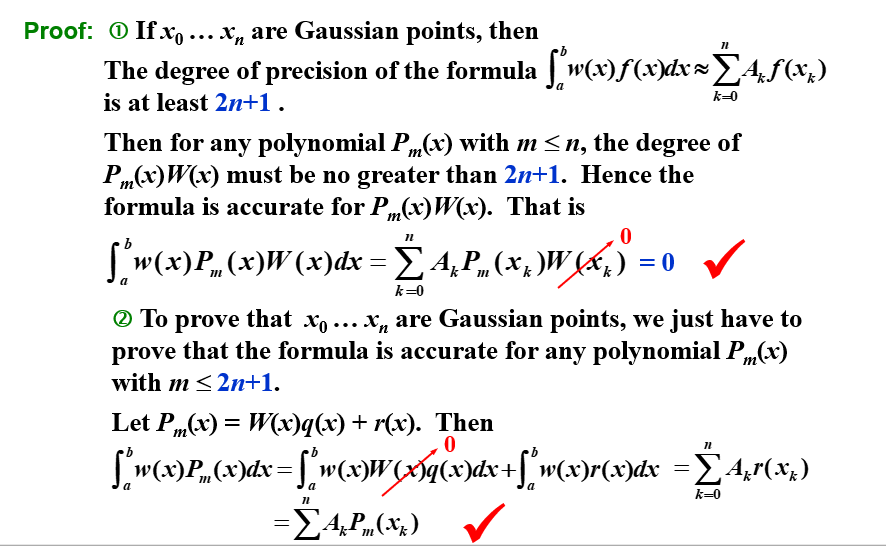
我们可以证明: x0...xnx_0...x_n are Gaussian points iff\color{blue}\text{iff} W(x)=∏k=0n(x−xk)W(x)=\prod\limits_{k=0}^n\left(x-x_k\right) is orthogonal to all the polynomials of degree no greater than n.n.

Alt text

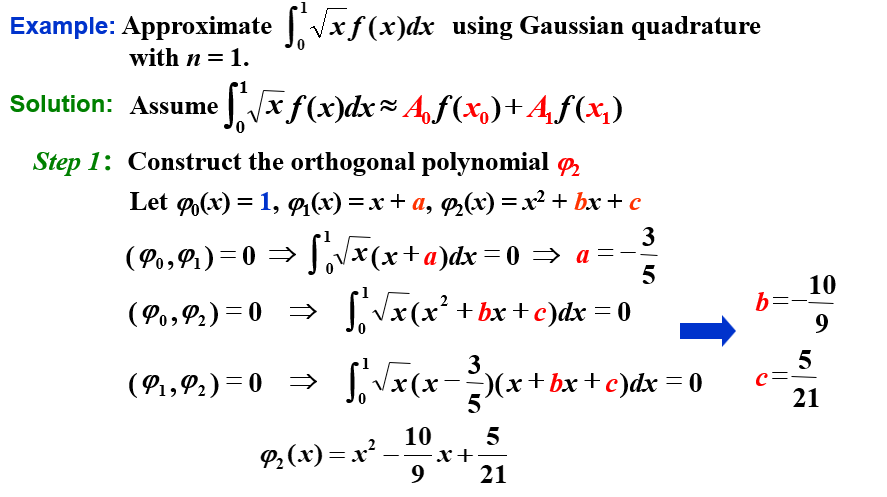
所以我们就是要找到一个正交多项式,它的零点就是我们要找的节点。

回到上面那个例子,我们就是要找到一个二阶多项式,其与小于二次的多项式的内积为0。
Alt text

Alt text

Gauss-Legendre 求积公式

Legendre 多项式:Pn(x)=12nn!dndxn[(x2−1)n]P_n(x)=\frac{1}{2^nn!}\frac{\mathrm{d}^n}{\mathrm{d}x^n}[(x^2-1)^n]。

其内积关系为:(Pk,Pl)={0,k≠l22k+1,k=l(P_k,P_l)=\begin{cases}0, & k\neq l \\ \frac{2}{2k+1}, & k=l\end{cases}。

根据 P0(x)=1,P1(x)=xP_0(x)=1,P_1(x)=x,我们有递推关系:

Pn+1(x)=2n+1n+1xPn(x)−nn+1Pn−1(x)P_{n+1}(x)=\frac{2n+1}{n+1}xP_n(x)-\frac{n}{n+1}P_{n-1}(x)

这些就是Legendre多项式的集合,也就是我们要找的正交多项式。

Gauss-Chebyshev 求积公式
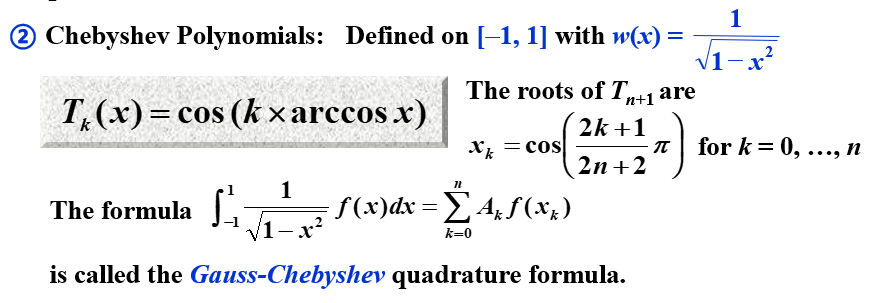
Alt text

Chapter 5 常微分方程的初值问题 | Initial-Value Problems for Ordinary Differential Equations

用数值方法来求解常微分方程的初值问题,就是找到 w0,w1,⋯ ,wNw_0,w_1,\cdots,w_N,使得 wi≈y(ti)w_i\approx y(t_i)。

5.1 初值问题的基本理论 | The Elementary Theory of Initial-Value Problems

Lipschitz 条件 | Lipschitz Condition
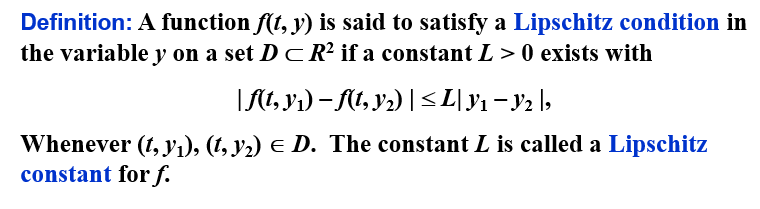
Alt text

实际上,就是关于 yy 的偏导数(如果可导)的上界

在 Lipschitz 条件下,初值问题的解是唯一的:
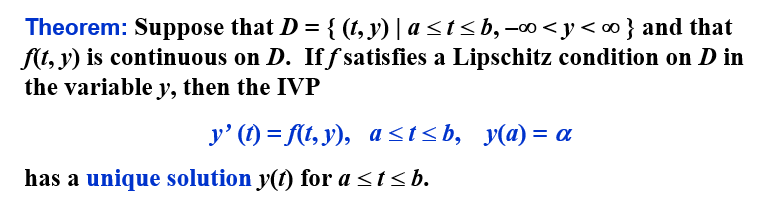
Alt text

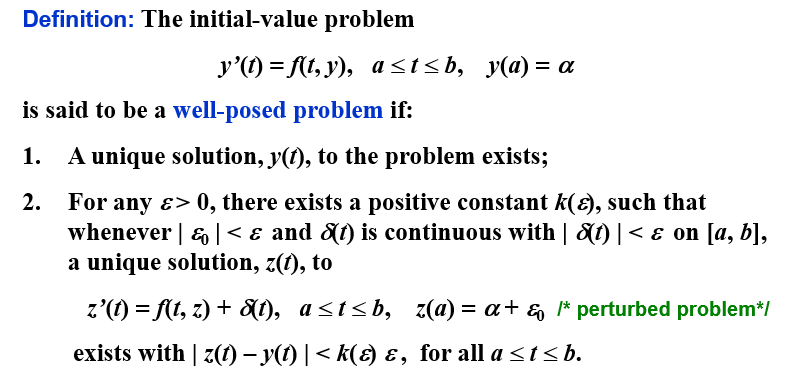
良态问题 | Well-Posed Problems

Alt text

z(t)z(t) 那行的式子是原式的摄动问题(perturbed problem),即在原式的基础上加上一个扰动项(假定微分方程可能有误差δ\delta,或者初值有误差ϵ\epsilon)

在 Lipschitz 条件下,初值问题是良态的:

Alt text

5.2 Euler 法 | Euler's Method

Euler 法的目的是获得如下形式的近似解:

{dydt=f(t,y)t∈[a,b]y(a)=α\begin{cases}\frac{dy}{dt}=f\left(t,y\right)\quad t\in[a,b]\\y(a)=\alpha&\end{cases}

得到的是一系列点的近似值。

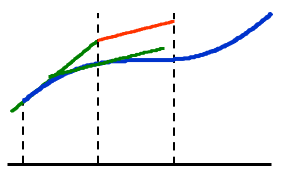
Euler 法的思想是,用 f(t,y)f(t,y) 在 (ti,yi)(t_i,y_i) 处的线性近似值来代替 f(t,y)f(t,y),即:

wi+1=wi+hf(ti,wi)w_{i+1}=w_i+hf(t_i,w_i)

我们称其为差分方程(difference equation)

Alt text

就是用一个点的导数值作为这个区间上的导数值

误差界

Alt text

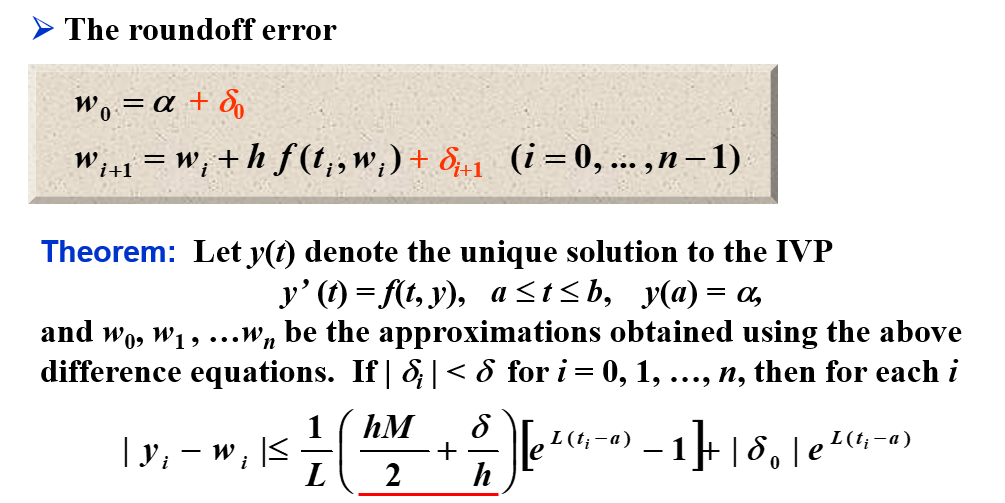
如果考虑每次计算中的舍入误差,则有

Alt text

此时,往往有 h>2δ/Mh>\sqrt{2\delta /M}(δ\delta 通常很小),所以随着 hh 的减小,误差会越来越小。(打勾函数的右沿)

其他 Euler 法

隐式欧拉法 | Implicit Euler Method

隐式欧拉法(implicit Euler method),又称后退欧拉法,是按照隐式公式进行数值求解的方法。隐式公式不能直接求解,一般需要用欧拉显式公式得到初值,然后用欧拉隐式公式进行迭代求解。因此,隐式公式比显式公式计算复杂,但稳定性好。
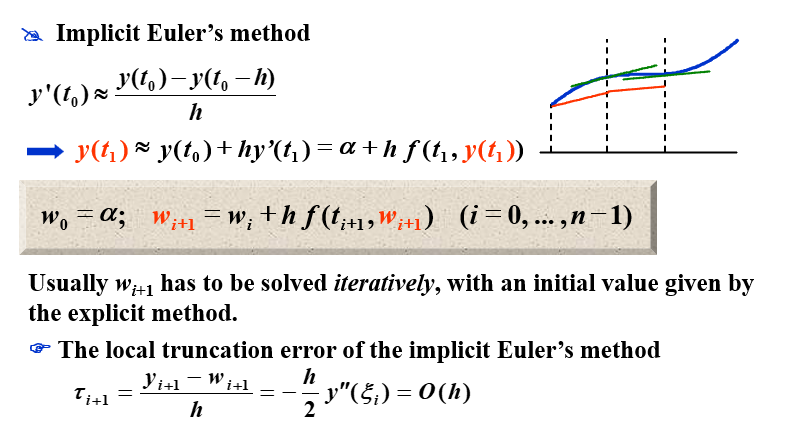
Alt text

梯形法 | Trapezoidal Method

梯形法(trapezoidal method)是一种求解常微分方程初值问题的数值方法。它是欧拉法和隐式欧拉法的结合,是一种二阶方法。梯形法的基本思想是用 f(ti,yi)f(t_i,y_i) 和 f(ti+1,yi+1)f(t_{i+1},y_{i+1}) 的平均值来代替 f(t,y)f(t,y),即:

wi+1=wi+h2(f(ti,wi)+f(ti+1,wi+1))w_{i+1}=w_i+\frac{h}{2}(f(t_i,w_i)+f(t_{i+1},w_{i+1}))

Note: The local truncation error is indeed O(h2)O(h^2). However an implicit equation has to be solved iteratively.

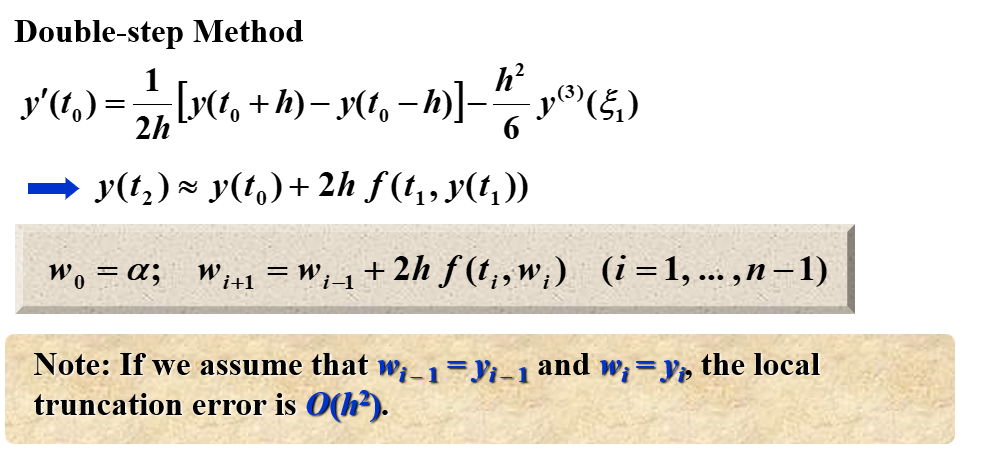
双步法 | Double-step Method

双步法相较于之前的方法,需要两个初始值,即 w0w_0 和 w1w_1,然后用这两个初始值来计算 w2w_2,再用 w1w_1 和 w2w_2 来计算 w3w_3,以此类推。

Alt text

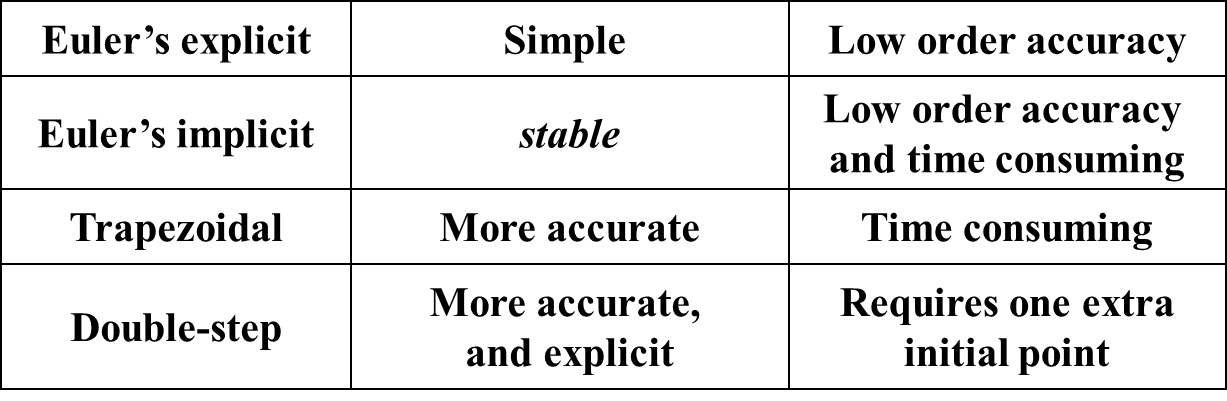
对比

Alt text

5.3 高阶 Taylor 法 | Higher-Order Taylor Methods

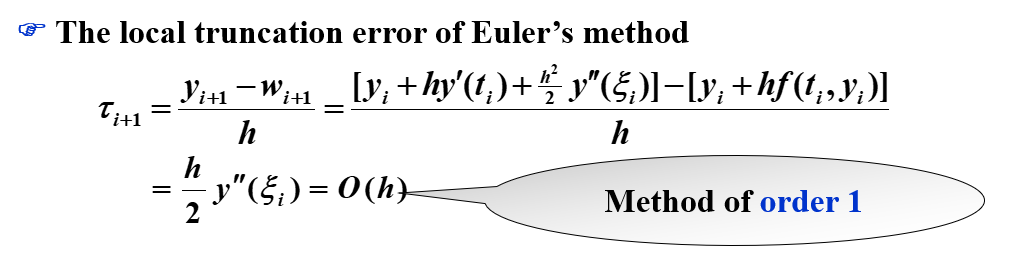
局部截断误差

局部截断误差只考虑一步的误差,即假设前面没有误差:

w0=αw_0=\alpha

wi+1=wi+hϕ(ti,wi),i=0,1,⋯ ,N−1w_{i+1}=w_i+h\phi(t_i,w_i),\quad i=0,1,\cdots,N-1

有局部截断误差

τi+1(h)=yi+1−(yi+hϕ(ti,yi))h=yi+1−yih−ϕ(ti,yi)\tau_{i+1}(h)=\frac{y_{i+1}-(y_i+h\phi(t_i,y_i))}{h}=\frac{y_{i+1}-y_i}{h}-\phi(t_i,y_i)

"对于 Euler 法"

Alt text

Euler 法实际上就是高阶 Taylor 法的一阶近似。

高阶 Taylor 法

yi+1=yi+hf(ti,yi)+h22f′(ti,yi)+⋯+hnn!f(n−1)(ti,yi)+hn+1(n+1)!f(n)(ξi,y(ξi))y_{i+1}=y_i+hf(t_i,y_i)+\frac{h^2}2f^{\prime}(t_i,y_i)+\cdots+\frac{h^n}{n!}f^{(n-1)}(t_i,y_i)+\frac{h^{n+1}}{(n+1)!}f^{(n)}(\xi_i,y(\xi_i))

nn 阶的 Taylor 法:

w0=αwi+1=wi+hT(n)(ti,wi)(i=0,...,n−1)whereT(n)(ti,wi)=f(ti,wi)+h2f′(ti,wi)+...+hn−1n!f(n−1)(ti,wi)\begin{aligned} w_{0}&=\alpha \\ w_{i+1}&=w_{i}+hT^{(n)}(t_{i},w_{i})\quad(i=0,...,n-1) \\ &\text{where}\quad T^{(n)}(t_i,w_i)=f(t_i,w_i)+\frac{h}{2}f^{\prime}(t_i,w_i)+...+\frac{h^{n-1}}{n!}f^{(n-1)}(t_i,w_i) \end{aligned}

其局部截断误差为 O(hn)O(h^{n})(如果 y∈Cn+1[a,b]y\in C^{n+1}[a,b])。

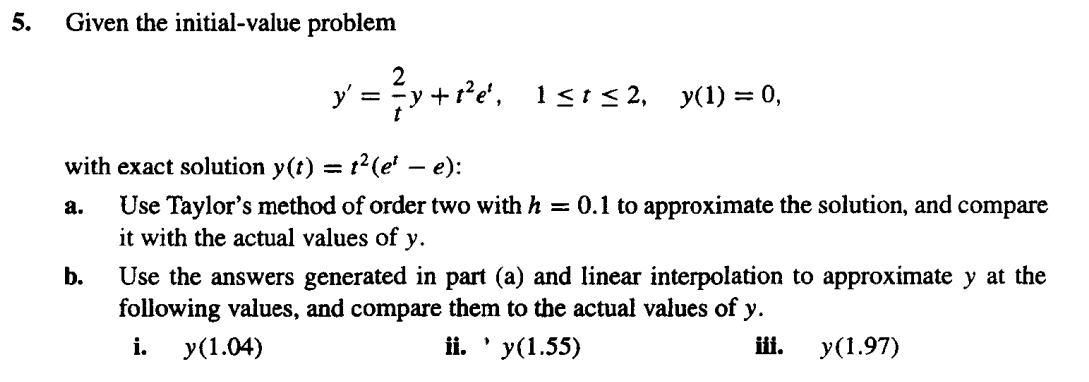
"例子"

Alt text

求 f(t,y(t))=2ty(t)+t2etf(t,y(t))=\frac{2}{t}y(t)+t^2e^t 关于 tt 的一阶导数

f(t,y(t))=2ty+t2etf′(t,y(t))=2ty′−2t2y+2tet+t2et=2t(2ty+t2et)−2t2y+2tet+t2et=4t2y+2tet−2t2y+2tet+t2et=2t2y+4tet+t2et\begin{aligned} f(t,y(t))&=\frac2ty+t^2e^t\\ f'(t,y(t))&=\frac2ty'-\frac{2}{t^2}y+2te^t+t^2e^t\\ &=\frac{2}{t}(\frac{2}{t}y+t^2e^t)-\frac{2}{t^2}y+2te^t+t^2e^t\\ &=\frac{4}{t^2}y+2te^t-\frac{2}{t^2}y+2te^t+t^2e^t\\ &=\frac{2}{t^2}y+4te^t+t^2e^t \end{aligned}

T(2)(ti,wi)=f(ti,wi)+h2f′(ti,wi)=2tiwi+ti2eti+h2(2ti2wi+4tieti+ti2eti)\begin{aligned} T^{(2)}(t_i,w_i)&=f(t_i,w_i)+\frac{h}{2}f'(t_i,w_i)\\ &=\frac{2}{t_i}w_i+t_i^2e^{t_i}+\frac{h}{2}(\frac{2}{t_i^2}w_i+4t_ie^{t_i}+t_i^2e^{t_i})\\ \end{aligned}

所以 wi+1w_{i+1} 的表达式为:

wi+1=wi+hf(ti,wi)+h22f′(ti,wi)=wi+h(2tiwi+ti2eti)+h22(2ti2wi+4tieti+ti2eti)\begin{aligned} w_{i+1}&=w_i+hf(t_i,w_i)+\frac{h^2}{2}f'(t_i,w_i)\\ &=w_i+h(\frac{2}{t_i}w_i+t_i^2e^{t_i})+\frac{h^2}{2}(\frac{2}{t_i^2}w_i+4t_ie^{t_i}+t_i^2e^{t_i})\\ \end{aligned}

h=0.1h=0.1 时:

ii tit_i wiw_i y(ti)y(t_i)
0 1.00 0.0000000 0.0000000
1 1.10 0.3397852 0.3459199
2 1.20 0.8521434 0.8666425
3 1.30 1.581770 1.607215
4 1.40 2.580997 2.620360
5 1.50 3.910985 3.967666
6 1.60 5.643081 5.720962
7 1.70 7.860382 7.963874
8 1.80 10.65951 10.79362
9 1.90 14.15268 14.32308
10 2.00 18.46999 18.68310

应用线性插值法,我们有

y(1.04)≈0.6y(1.00)+0.4y(1.10)=0.6∗0.0000000+0.4∗0.3397852=0.1359141y(1.55)≈0.5y(1.50)+0.5y(1.60)=0.5∗3.910985+0.5∗5.643081=4.777033y(1.97)≈0.3y(1.90)+0.7y(2.00)=0.3∗14.15268+0.7∗18.46999=17.17480\begin{aligned} y(1.04)&\approx 0.6y(1.00)+0.4y(1.10)\\ &=0.6*0.0000000+0.4*0.3397852\\ &=0.1359141\\ y(1.55)&\approx 0.5y(1.50)+0.5y(1.60)\\ &=0.5*3.910985+0.5*5.643081\\ &=4.777033\\ y(1.97)&\approx 0.3y(1.90)+0.7y(2.00)\\ &=0.3*14.15268+0.7*18.46999\\ &=17.17480 \end{aligned}

其精确值为:

y(1.04)=0.1199875y(1.55)=4.788635y(1.97)=17.27930\begin{aligned} y(1.04)&=0.1199875\\ y(1.55)&=4.788635\\ y(1.97)&=17.27930 \end{aligned}

5.4 Runge-Kutta 法 | Runge-Kutta Methods

泰勒方法需要计算 f(t,y)f(t,y) 的导数并求值,这是一个复杂、耗时的过程。Runge-Kutta 方法具有 Taylor 方法的高阶局部截断误差,但是不需要计算 f(t,y)f(t,y) 的导数。

二阶 Runge-Kutta 法 | Runge-Kutta method of order 2

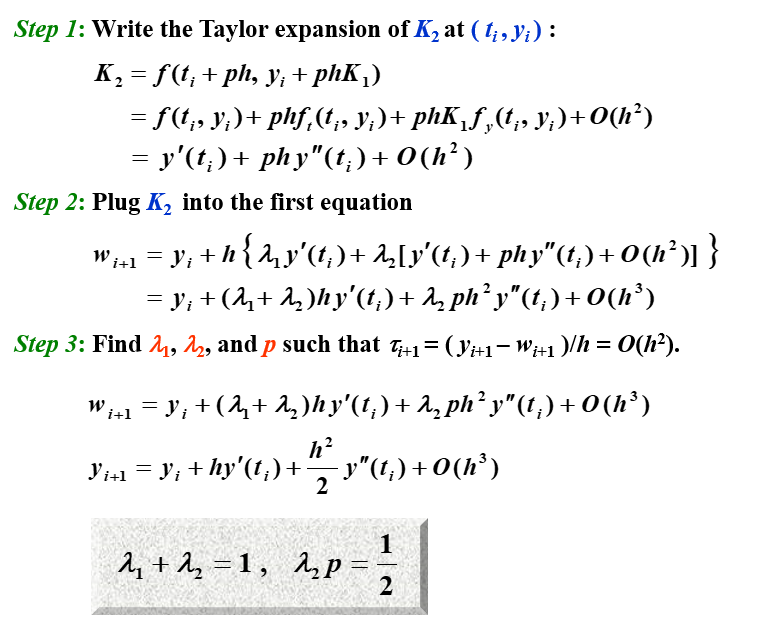
我们考察改进欧拉法 KK 前面的系数以及 K2K_2 的步长,使局部截断误差为 O(h2)O(h^2):

{wi+1=wi+h[λ1K1+λ2K2]K1=f(ti,wi)K2=f(ti+ph,wi+phK1)\begin{cases}w_{i+1}&=&w_i+h[{\color{red}{\lambda_1}}K_1+{\color{red}{\lambda_2}}K_2]\\K_1&=&f(t_i,w_i)\\K_2&=&f(t_i+{\color{red}{p}}h,w_i+{\color{red}{p}}hK_1)\end{cases}

Alt text

这有无穷多种可能,我们称其为 二阶 Runge-Kutta 方法(Runge-Kutta method of order 2)。

以下三个是二阶 Runge-Kutta 方法的特例

中点法 | Midpoint Method

{w0=αwi+1=wi+hf(ti+h2,wi+h2f(ti,wi))\begin{cases}w_0=\alpha\\ w_{i+1}=w_i+hf(t_i+\frac{h}{2},w_i+\frac{h}{2}f(t_i,w_i))\end{cases}

改进欧拉法 | Modified Euler Method

{w0=αwi+1=wi+h(12K1+12K2)K1=f(ti,wi)K2=f(ti+h,wi+hK1)\begin{cases}w_0=\alpha\\ w_{i+1}=w_i+h(\frac12K_1+\frac12K_2)\\ K_1=f(t_i,w_i)\\ K_2=f(t_{i}+h,w_i+hK_1)\end{cases}

"是不是感觉和梯形法很像?"

梯形法是用 f(ti,wi)f(t_i,w_i) 和 f(ti+1,wi+1)f(t_{i+1},w_{i+1}) 的平均值来代替 f(t,y)f(t,y),而改进欧拉法是用 f(ti,wi)f(t_i,w_i) 和 f(ti+h,wi+hK1)f(t_{i}+h,w_i+hK_1) 的平均值来代替 f(t,y)f(t,y)。区别在于前者是隐式的,后者是显式的。

Heun 法 | Heun's Method

{w0=αwi+1=wi+h(14K1+34K2)K1=f(ti,wi)K2=f(ti+23h,wi+23hK1)\begin{cases}w_0=\alpha\\ w_{i+1}=w_i+h(\frac{1}{4}K_1+\frac{3}{4}K_2)\\ K_1=f(t_i,w_i)\\ K_2=f(t_{i}+\frac{2}{3}h,w_i+\frac{2}{3}hK_1)\end{cases}

高阶 Runge-Kutta 法 | Runge-Kutta methods of order mm

{w0=αwi+1=wi+h(λ1K1+λ2K2+⋯+λmKm)K1=f(ti,wi)K2=f(ti+α2h,wi+β21hK1)K3=f(ti+α3h,wi+β31hK1+β32hK2)⋮Km=f(ti+αmh,wi+βm1hK1+βm2hK2+⋯+βm,m−1hKm−1)\begin{cases}w_0=\alpha\\ w_{i+1}=w_i+h({\color{red}{\lambda_1}}K_1+{\color{red}{\lambda_2}}K_2+\cdots+{\color{red}{\lambda_m}}K_m)\\ K_1=f(t_i,w_i)\\ K_2=f(t_i+{\color{red}{\alpha_2}}h,w_i+{\color{red}{\beta_{21}}}hK_1)\\ K_3=f(t_i+{\color{red}{\alpha_3}}h,w_i+{\color{red}{\beta_{31}}}hK_1+{\color{red}{\beta_{32}}}hK_2)\\ \vdots\\ K_m=f(t_i+{\color{red}{\alpha_m}}h,w_i+{\color{red}{\beta_{m1}}}hK_1+{\color{red}{\beta_{m2}}}hK_2+\cdots+{\color{red}{\beta_{m,m-1}}}hK_{m-1})\end{cases}

"Order 4-the most popular one"

{w0=αwi+1=wi+h(16K1+13K2+13K3+16K4)K1=f(ti,wi)K2=f(ti+h2,wi+h2K1)K3=f(ti+h2,wi+h2K2)K4=f(ti+h,wi+hK3)\begin{cases}w_0=\alpha\\ w_{i+1}=w_i+h(\frac16K_1+\frac13K_2+\frac13K_3+\frac16K_4)\\ K_1=f(t_i,w_i)\\ K_2=f(t_i+\frac{h}{2},w_i+\frac{h}{2}K_1)\\ K_3=f(t_i+\frac{h}{2},w_i+\frac{h}{2}K_2)\\ K_4=f(t_i+h,w_i+hK_3)\end{cases}

我们给出每步的求值次数和局部阶段误差的阶之间的关系:

Alt text

这说明了为什么人们更喜欢使用具有较小步长的小于 5 阶的 Runge-Kutta 方法。

因为 Runge-Kutta 方法是基于 Taylor 展开的,所以 y 必须足够平滑,才能获得更高阶方法的更高精度。通常情况下,人们更喜欢使用较小步长的低阶方法,而不是使用较大步长的高阶方法。

如果 yy 不够光滑,那么高阶的 Runge-Kutta 方法也不会有很好的效果,所以一般会用低阶的 Runge-Kutta 方法,但是步长会更小

5.6 多步法 | Multistep Methods

在一些网格点(mesh points)上使用 yy 和 y′y' 的线性组合来更好地近似 y(ti+1)y(t_{i+1})

求解初值问题

y′=f(t,y),a≤t≤b,y(a)=αy'=f(t,y),\quad a\leq t\leq b,\quad y(a)=\alpha

的 mm 步多步法(mm-step multistep method)的一般形式为

wi+1=am−1wi+am−2wi−1+...+a0wi+1−m+h[bmf(ti+1,wi+1)+bm−1f(ti,wi)+...+b0f(ti+1−m,wi+1−m)]\begin{aligned} w_{i+1}=&{\color{red}{a_{m-1}}}w_i+{\color{red}{a_{m-2}}}w_{i-1}+...+{\color{red}{a_0}}w_{i+1-m}\\+&h[{\color{red}{b_m}}f(t_{i+1},w_{i+1})+{\color{red}{b_{m-1}}}f(t_i,w_i)+...+{\color{red}{b_0}}f(t_{i+1-m},w_{i+1-m})] \end{aligned}

其中 h=(b−a)/Nh=(b-a)/N,给定 mm 个初始值 w0,w1,...,wm−1w_0,w_1,...,w_{m-1},a0,a1,...,am−1a_0,a_1,...,a_{m-1} 和 b0,b1,...,bmb_0,b_1,...,b_m 是常数。

bm=0b_m=0 的方法称为显式(explicit);bm≠0b_m\neq 0 的方法称为隐式(implicit)

局部截断误差(local truncation error)为

τi+1(h)=yi+1−wi+1h=yi+1−am−1yi−am−2yi−1−...−a0yi+1−mh−bmf(ti+1,yi+1)−bm−1f(ti,yi)−...−b0f(ti+1−m,yi+1−m)\begin{aligned} \tau_{i+1}(h)&=\frac{y_{i+1}-w_{i+1}}{h}\\ &=\frac{y_{i+1}-{\color{red}{a_{m-1}}}y_i-{\color{red}{a_{m-2}}}y_{i-1}-...-{\color{red}{a_0}}y_{i+1-m}}{h}\\ &-{\color{red}{b_m}}f(t_{i+1},y_{i+1})-{\color{red}{b_{m-1}}}f(t_i,y_i)-...-{\color{red}{b_0}}f(t_{i+1-m},y_{i+1-m}) \end{aligned}

Adams-Bashforth 显式 m 步方法 | Adams-Bashforth explicit m-step technique

注意到

y(ti+1)=y(ti)+∫titi+1f(t,y(t))dty(t_{i+1})=y(t_i)+\int_{t_i}^{t_{i+1}}f(t,y(t))dt

为了推导 Adams-Bashforth 显式 m 步方法,我们通过(ti,f(ti,y(ti)))(t_i,f(t_i,y(t_i))),(ti−1,f(ti−1,y(ti−1)))(t_{i-1},f(t_{i-1},y(t_{i-1}))),(ti−2,f(ti−2,y(ti−2)))(t_{i-2},f(t_{i-2},y(t_{i-2}))),...,(ti+1−m,f(ti+1−m,y(ti+1−m)))(t_{i+1-m},f(t_{i+1-m},y(t_{i+1-m}))) 形成向后差分多项式 Pm−1(t)P_{m-1}(t),然后用 Pm−1(t)P_{m-1}(t) 来代替 f(t,y(t))f(t,y(t)),从而得到

f(t,y(t))=Pm−1(t)+f(m)(ξi,y(ξi))m!(t−ti)(t−ti−1)...(t−ti+1−m)f(t,y(t))=P_{m-1}(t)+\frac{f^{(m)}(\xi_i,y(\xi_i))}{m!}(t-t_i)(t-t_{i-1})...(t-t_{i+1-m})

"向后差分多项式"

Pn(xs)=∑k=0n(−1)k(−sk)∇kf(xn)P_n(x_s)=\sum\limits_{k=0}^n(-1)^k\begin{pmatrix}-s\\k\end{pmatrix}\nabla^kf(x_n)

∫titi+1f(t,y(t))dt=∫titi+1Pm−1(t)dt+∫titi+1Rm−1(t)dt=h∫01Pm−1(ti+sh)ds+h∫01Rm−1(ti+sh)ds=h∑k=0m−1∇kf(ti,y(ti))(−1)k∫01(−sk)ds+hm+1m!∫01f(m)(ξi,y(ξi))s(s+1)...(s+m−1)ds\begin{aligned} \int_{t_i}^{t_{i+1}}f(t,y(t))dt&=\int_{t_i}^{t_{i+1}}P_{m-1}(t)dt+\int_{t_i}^{t_{i+1}}R_{m-1}(t)dt\\ &=h\int_{0}^{1}P_{m-1}(t_i+sh)ds+h\int_{0}^{1}R_{m-1}(t_i+sh)ds\\ &=h\sum\limits_{k=0}^{m-1}\nabla^kf(t_i,y(t_i))(-1)^k\int_{0}^{1}\begin{pmatrix}-s\\k\end{pmatrix}ds\\&+\frac{h^{m+1}}{m!}\int_{0}^{1}f^{(m)}(\xi_i,y(\xi_i))s(s+1)...(s+m-1)ds\\ \end{aligned}

其中 Rm−1(t)R_{m-1}(t) 是余项,也就是截断误差。

我们有

wi+1=wi+h∫01Pm−1(ti+sh)ds=wi+h∑k=0m−1∇kf(ti,y(ti))(−1)k∫01(−sk)ds∫titi+1Rm−1(t)dt=hm+1m!∫01f(m)(ξi,y(ξi))s(s+1)...(s+m−1)ds=hm+1f(m)(μi,y(μi))m!∫01s(s+1)...(s+m−1)ds=hm+1f(m)(μi,y(μi))(−1)m∫01(−sm)ds\begin{aligned} w_{i+1}&=w_i+h\int_{0}^{1}P_{m-1}(t_i+sh)ds\\ &=w_i+h\sum\limits_{k=0}^{m-1}\nabla^kf(t_i,y(t_i))(-1)^k\int_{0}^{1}\begin{pmatrix}-s\\k\end{pmatrix}ds\\ \int_{t_i}^{t_{i+1}}R_{m-1}(t)dt&=\frac{h^{m+1}}{m!}\int_{0}^{1}f^{(m)}(\xi_i,y(\xi_i))s(s+1)...(s+m-1)ds\\ &=\frac{h^{m+1}f^{(m)}(\mu_i,y(\mu_i))}{m!}\int_{0}^{1}s(s+1)...(s+m-1)ds\\ &={h^{m+1}f^{(m)}(\mu_i,y(\mu_i))}(-1)^m\int_{0}^{1}\begin{pmatrix}-s\\m\end{pmatrix}ds\\ \end{aligned}

其局部截断误差为

τi+1(h)=yi+1−am−1yi−am−2yi−1−...−a0yi+1−mh−bmf(ti+1,yi+1)−bm−1f(ti,yi)−...−b0f(ti+1−m,yi+1−m)=1h∫titi+1Rm−1(t)dt=hmf(m)(μi,y(μi))(−1)m∫01(−sm)ds\begin{aligned} \tau_{i+1}(h)&=\frac{y_{i+1}-{\color{red}{a_{m-1}}}y_i-{\color{red}{a_{m-2}}}y_{i-1}-...-{\color{red}{a_0}}y_{i+1-m}}{h}\\ &-{\color{red}{b_m}}f(t_{i+1},y_{i+1})-{\color{red}{b_{m-1}}}f(t_i,y_i)-...-{\color{red}{b_0}}f(t_{i+1-m},y_{i+1-m})\\ &=\frac{1}{h}\int_{t_i}^{t_{i+1}}R_{m-1}(t)dt\\ &={h^{m}f^{(m)}(\mu_i,y(\mu_i))}(-1)^m\int_{0}^{1}\begin{pmatrix}-s\\m\end{pmatrix}ds \end{aligned}

"(−1)k∫01(−sk)ds(-1)^k\int_{0}^{1}\begin{pmatrix}-s\\k\end{pmatrix}ds"

kk (−1)k∫01(−sk)ds(-1)^k\int_{0}^{1}\begin{pmatrix}-s\\k\end{pmatrix}ds
00 11
11 12\frac{1}{2}
22 512\frac{5}{12}
33 38\frac{3}{8}
44 251720\frac{251}{720}
55 95288\frac{95}{288}

"2步"

取 m=2m=2,我们有

wi+1=wi+h[∇0f(ti,wi)+12∇1f(ti,wi)]=wi+h[32f(ti,wi)−12f(ti−1,wi−1)]\begin{aligned} w_{i+1}&=w_i+h[\nabla^0f(t_i,w_i)+\frac12\nabla^1f(t_i,w_i)]\\ &=w_i+h[\frac32f(t_i,w_i)-\frac12f(t_{i-1},w_{i-1})]\\ \end{aligned}

因为 yi+1=yi+h[bmf(ti+1,wi+1)+bm−1f(ti,wi)+...+b0f(ti+1−m,wi+1−m)]+∫titi+1Rm−1(t)dty_{i+1}=y_i+h[{\color{red}{b_m}}f(t_{i+1},w_{i+1})+{\color{red}{b_{m-1}}}f(t_i,w_i)+...+{\color{red}{b_0}}f(t_{i+1-m},w_{i+1-m})]+\int_{t_i}^{t_{i+1}}R_{m-1}(t)dt,所以

其局部截断误差为

τi+1(h)=hmf(m)(μi,y(μi))(−1)m∫01(−sm)ds=512h2f′′(μi,y(μi))=512h2y′′′(μi)\begin{aligned} \tau_{i+1}(h)&={h^{m}f^{(m)}(\mu_i,y(\mu_i))}(-1)^m\int_{0}^{1}\begin{pmatrix}-s\\m\end{pmatrix}ds\\ &=\frac{5}{12}h^2f''(\mu_i,y(\mu_i))\\ &=\frac{5}{12}h^2y'''(\mu_i) \end{aligned}

mm fif_i fi−1f_{i-1} fi−2f_{i-2} fi−3f_{i-3}
11 11 −- −- −-
22 32\frac{3}{2} −12-\frac{1}{2} −- −-
33 2312\frac{23}{12} −43-\frac{4}{3} 512\frac{5}{12} −-
44 5524\frac{55}{24} −5924-\frac{59}{24} 3724\frac{37}{24} −38-\frac{3}{8}

查表可得,Adams-Bashforth 显式 4 步方法的为

wi+1=wi+h24(55fi−59fi−1+37fi−2−9fi−3)w_{i+1}=w_i+\frac{h}{24}(55f_i-59f_{i-1}+37f_{i-2}-9f_{i-3})

Adams-Moulton 隐式 m 步方法 | Adams-Moulton implicit m-step technique

同样的,我们采用向前差分多项式,可以得到 Adams-Moulton 隐式 m 步方法:
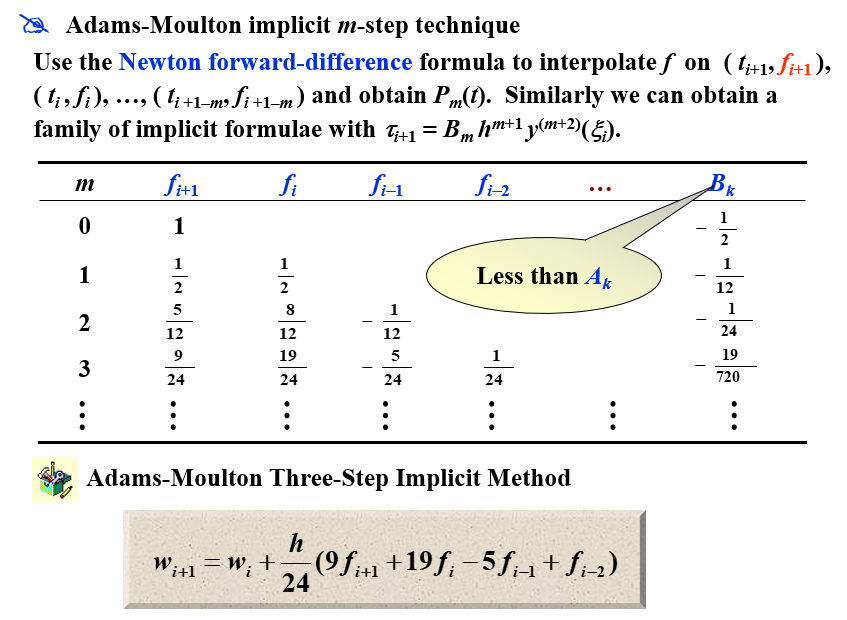
Alt text

Adams 预测-校正系统 | Adams predictor-corrector system

Adams 预测-校正系统是 Adams-Bashforth 显式 m 步方法和 Adams-Moulton 隐式 m 步方法的结合:

  1. 用 Runge-Kutta 法计算出 mm 个初始值 w0,w1,...,wm−1w_0,w_1,...,w_{m-1} (如果初值的个数不够)
  2. 预测:用 Adams-Bashforth 显式 m 步方法计算出 wm,wm+1,...w_m,w_{m+1},... 直到 wN−1w_{N-1}
  3. 校正:用 Adams-Moulton 隐式 m 步方法计算出 wm,wm+1,...w_m,w_{m+1},... 直到 wN−1w_{N-1}

在这三步中使用的所有公式的局部截断误差的阶必须相同。

最常用的系统是以 4 阶 Adams-Bashforth 方法作为预测器,以 Adams-Moulton 方法的一次迭代作为校正器,其起始值来自 4 阶 Runge-Kutta 方法。

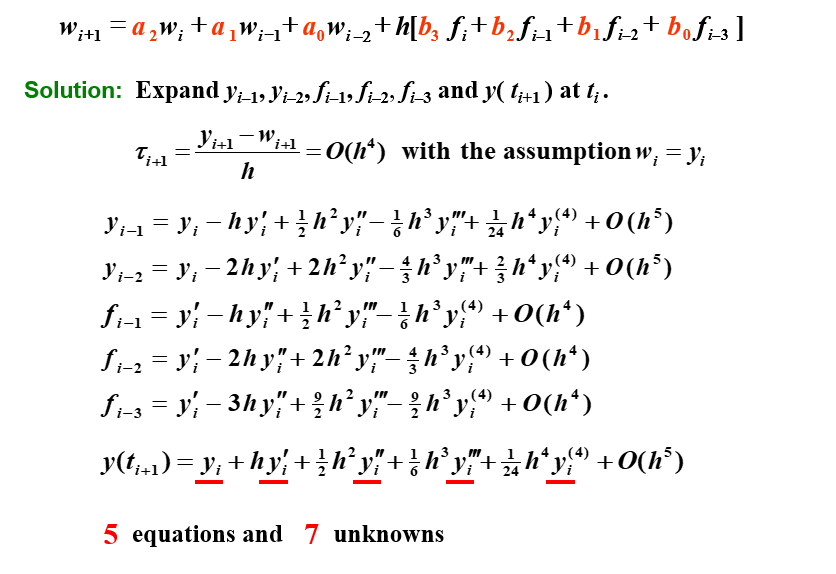
宏观角度:Taylor 展开
Alt text

通过对比系数,可以有一族解。

通过对这个解的再限制(添加两个条件),我们可以得到多种方法。
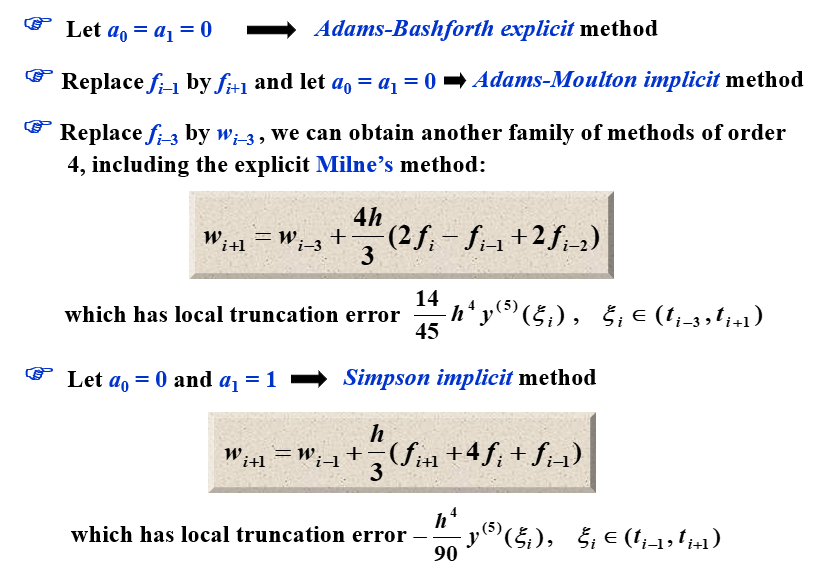
Alt text

5.9 高阶方程和微分方程组 | Higher-Order Equations and Systems of Differential Equations

微分方程组的矩阵形式

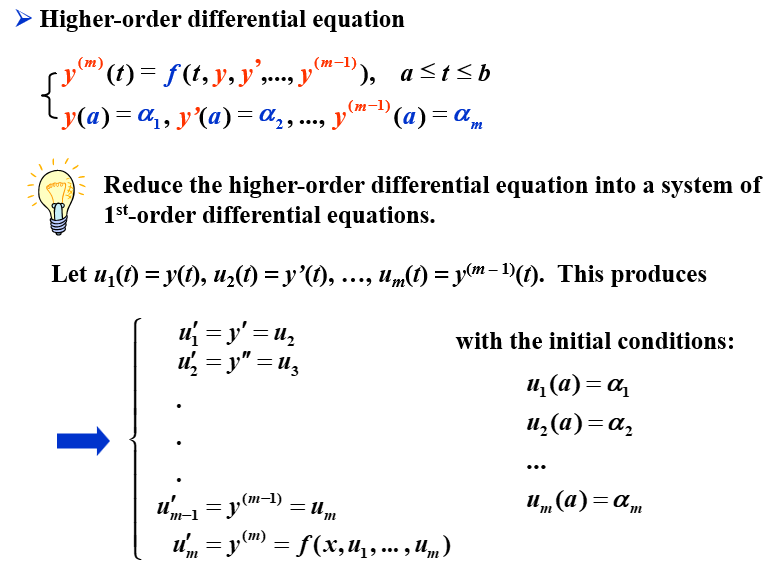
对 mm 阶微分方程组:

{u1′(t)=f1(t,u1(t),u2(t),...,um(t))⋮um′(t)=fm(t,u1(t),u2(t),...,um(t))\begin{cases} u_1'(t)=f_1(t,u_1(t),u_2(t),...,u_m(t))\\ \vdots\\ u_m'(t)=f_m(t,u_1(t),u_2(t),...,u_m(t))\\ \end{cases}

给定 mm 个初始值 u1(a),u2(a),...,um(a)u_1(a),u_2(a),...,u_m(a),我们可以用 mm 步的 Runge-Kutta 法来求解。

用矩阵的形式可以记作

{y′(t)=f(t,y(t))y(a)=α\begin{cases} \mathbf{y}'(t)=\mathbf{f}(t,\mathbf{y}(t))\\ \mathbf{y}(a)=\mathbf{\alpha}\\ \end{cases}

高阶微分方程的转化

Alt text

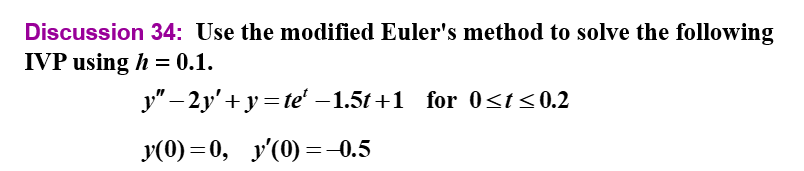
"例题"

Alt text

"modified Euler's method"

Alt text

Alt text

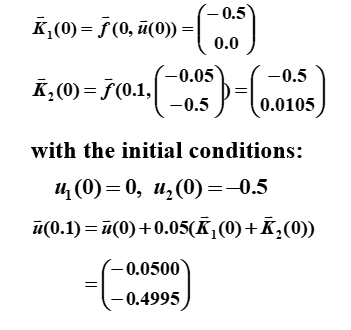
"第一次迭代:"

Alt text

"第二次迭代:"

Alt text

5.10 稳定性 | Stability

相容 | Consistency
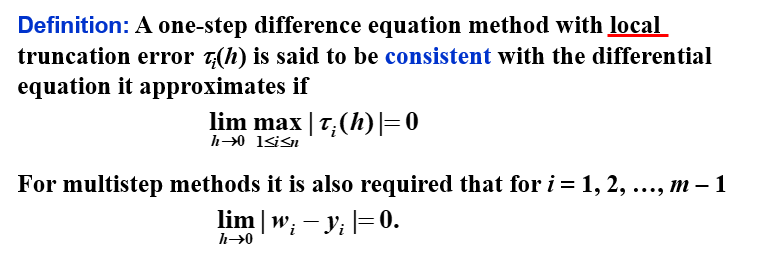
Alt text

注意到这个定义是在局部上的定义

收敛 | Convergence

Alt text

这是对整体而言

稳定性 | Stability

除了这两个概念,我们还需要一个概念:稳定性。如果初始条件的小变化或扰动会导致后续近似值的相应小变化,则该方法被称为稳定。

特征方程与稳定性

已知方程

w0=α,w1=α1,⋯ ,wm−1=αm−1wi+1=am−1wi+am−2wi−1+⋯+a0wi+1−m+hF(ti,h,wi+1,wi,⋯ ,wi+1−m)\begin{aligned} w_0&=\alpha,w_1=\alpha_1,\cdots,w_{m-1}=\alpha_{m-1}\\ w_{i+1}&=a_{m-1}w_i+a_{m-2}w_{i-1}+\cdots+a_0w_{i+1-m}+hF(t_i,h,w_{i+1},w_i,\cdots,w_{i+1-m}) \end{aligned}

我们给出一个相关的多项式,称为特征多项式(characteristic polynomial):

P(λ)=λm−am−1λm−1−am−2λm−2−⋯−a0P(\lambda)=\lambda^m-a_{m-1}\lambda^{m-1}-a_{m-2}\lambda^{m-2}-\cdots-a_0

  • 如果 P(λ)P(\lambda) 的所有根的模都小于等于 1,且取等时为单根,则称该方法满足根条件(root condition)
    • 如果有且仅有一个根的模等于 1,则该方法是强稳定(strongly stable)的
    • 如果有多个根的模等于 1,则该方法是弱稳定(weakly stable)的
  • 如果方法不满足根条件,则该方法是不稳定的

测试方程 | Test Equation

我们将一个特定的方法应用于一个简单的测试方程:

y’=λy,y(0)=α,where Re(λ)<0y’ = \lambda y, y(0) = \alpha, \text{where } Re(\lambda) < 0

假设舍入误差只在初始点引入。如果这个初始误差会在某个步长 hh 下减小,那么这个方法就被称为绝对稳定(absolutely stable),此时 H=λhH = \lambda h。所有这样的 HH 的集合构成了绝对稳定域(region of absolute stability)。
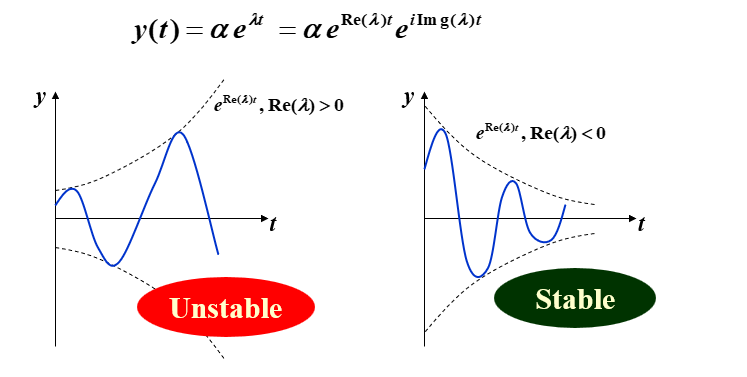
Alt text

如果方法 A 的绝对稳定域比方法 B 的大,那么方法 A 就比方法 B 更稳定

显式 Euler 法的稳定性

在显式 Euler 法中,我们有

wi+1=wi+hf(ti,wi)w_{i+1}=w_i+hf(t_i,w_i)

在这个测试方程中,我们有

wi+1=(1+λh)wi=(1+H)wi=(1+H)i+1αw_{i+1}=(1+\lambda h)w_i=(1+H)w_i=(1+H)^{i+1}\alpha

我们给初值加上一个扰动项 ϵ\epsilon,即 α∗=α+ϵ\alpha^*=\alpha+\epsilon,则

wi+1∗=(1+H)i+1(α+ϵ)w_{i+1}^*=(1+H)^{i+1}(\alpha+\epsilon)

所以

ϵi+1=(1+H)i+1ϵ\epsilon_{i+1}=(1+H)^{i+1}\epsilon

要确保稳定性,我们需要 ∣(1+H)i+1∣<1|(1+H)^{i+1}|<1,即 ∣1+H∣<1|1+H|<1。

隐式 Euler 法的稳定性

在隐式 Euler 法中,我们有

wi+1=wi+hf(ti+1,wi+1)w_{i+1}=w_i+hf(t_{i+1},w_{i+1})

在这个测试方程中,我们有

wi+1=wi+hλwi+1w_{i+1}=w_i+h\lambda w_{i+1}

所以

wi+1=11−hλwi=11−Hwi=(11−H)i+1αw_{i+1}=\frac{1}{1-h\lambda}w_i=\frac{1}{1-H}w_i=(\frac{1}{1-H})^{i+1}\alpha

我们给初值加上一个扰动项 ϵ\epsilon,即 α∗=α+ϵ\alpha^*=\alpha+\epsilon,则

wi+1∗=(11−H)i+1(α+ϵ)w_{i+1}^*=(\frac{1}{1-H})^{i+1}(\alpha+\epsilon)

所以

ϵi+1=(11−H)i+1ϵ\epsilon_{i+1}=(\frac{1}{1-H})^{i+1}\epsilon

要确保稳定性,我们需要 ∣(11−H)i+1∣<1|(\frac{1}{1-H})^{i+1}|<1,即 ∣11−H∣<1|\frac{1}{1-H}|<1。

二阶 隐式 Runge-Kutta 法的稳定性

在二阶 隐式 Runge-Kutta 法中,我们有

{wi+1=wi+hK1K1=f(ti+12h,wi+12hK1)\begin{cases}w_{i+1}&=&w_i+hK_1\\K_1&=&f(t_i+\frac12h,w_i+\frac12hK_1)\end{cases}

在这个测试方程中,我们有

K1=λ(wi+12hK1)⇒K1=λwi1−12hλwi+1=wi+hK1=wi+hλwi1−12hλ=wi+Hwi1−12H=2+H2−Hwi=(2+H2−H)i+1α\begin{aligned} K_1&=\lambda (w_i+\frac12hK_1)\Rightarrow K_1=\frac{\lambda w_i}{1-\frac12h\lambda}\\ w_{i+1}&=w_i+hK_1\\ &=w_i+h\frac{\lambda w_i}{1-\frac12h\lambda}\\ &=w_i+\frac{H w_i}{1-\frac12H}\\ &=\frac{2+H}{2-H}w_i\\ &=(\frac{2+H}{2-H})^{i+1}\alpha\\ \end{aligned}

我们给初值加上一个扰动项 ϵ\epsilon,即 α∗=α+ϵ\alpha^*=\alpha+\epsilon,则

wi+1∗=(2+H2−H)i+1(α+ϵ)w_{i+1}^*=(\frac{2+H}{2-H})^{i+1}(\alpha+\epsilon)

所以

ϵi+1=(2+H2−H)i+1ϵ\epsilon_{i+1}=(\frac{2+H}{2-H})^{i+1}\epsilon

要确保稳定性,我们需要 ∣2+H2−H∣<1|\frac{2+H}{2-H}|<1。

四阶 显式 Runge-Kutta 法的稳定性

在四阶 显式 Runge-Kutta 法中,我们有

{wi+1=wi+h6(K1+2K2+2K3+K4)K1=f(ti,wi)K2=f(ti+12h,wi+12hK1)K3=f(ti+12h,wi+12hK2)K4=f(ti+h,wi+hK3)\begin{cases}w_{i+1}&=&w_i+\frac{h}{6}(K_1+2K_2+2K_3+K_4)\\ K_1&=&f(t_i,w_i)\\ K_2&=&f(t_i+\frac12h,w_i+\frac12hK_1)\\ K_3&=&f(t_i+\frac12h,w_i+\frac12hK_2)\\ K_4&=&f(t_i+h,w_i+hK_3)\\ \end{cases}

在这个测试方程中,我们有

K1=λwiK2=λ(wi+12hK1)=λwi(1+12H)K3=λ(wi+12hK2)=λwi(1+12H+14H2)K4=λ(wi+hK3)=λwi(1+H+12H2+14H3)wi+1=wi+h6(K1+2K2+2K3+K4)=wi+h6λwi(1+2(1+12H)+2(1+12H+14H2)+(1+H+12H2+14H3))=wi+H6wi(6+3H+H2+14H3)=wi(1+H+12H2+16H3+124H4)=α(1+H+12H2+16H3+124H4)i+1\begin{aligned} K_1&=\lambda w_i\\ K_2&=\lambda (w_i+\frac12hK_1)=\lambda w_i(1+\frac12H )\\ K_3&=\lambda (w_i+\frac12hK_2)=\lambda w_i(1+\frac12H +\frac14H^2 )\\ K_4&=\lambda (w_i+hK_3)=\lambda w_i(1+H +\frac12H^2 +\frac14H^3 )\\ w_{i+1}&=w_i+\frac{h}{6}(K_1+2K_2+2K_3+K_4)\\ &=w_i+\frac{h}{6} \lambda w_i(1+2(1+\frac12H )+2(1+\frac12H +\frac14H^2 )+(1+H +\frac12H^2 +\frac14H^3 ))\\ &=w_i+\frac{H}{6} w_i(6+3H+H^2+\frac{1}{4}H^3)\\ &=w_i(1+H+\frac{1}{2}H^2+\frac{1}{6}H^3+\frac{1}{24}H^4)\\ &=\alpha(1+H+\frac{1}{2}H^2+\frac{1}{6}H^3+\frac{1}{24}H^4)^{i+1}\\ \end{aligned}

我们给初值加上一个扰动项 ϵ\epsilon,即 α∗=α+ϵ\alpha^*=\alpha+\epsilon,则

wi+1∗=α∗(1+H+12H2+16H3+124H4)i+1w_{i+1}^*=\alpha^*(1+H+\frac{1}{2}H^2+\frac{1}{6}H^3+\frac{1}{24}H^4)^{i+1}

所以

ϵi+1=(1+H+12H2+16H3+124H4)i+1ϵ\epsilon_{i+1}=(1+H+\frac{1}{2}H^2+\frac{1}{6}H^3+\frac{1}{24}H^4)^{i+1}\epsilon

要确保稳定性,我们需要 ∣1+H+12H2+16H3+124H4∣<1|1+H+\frac{1}{2}H^2+\frac{1}{6}H^3+\frac{1}{24}H^4|<1。

微分方程组

考虑一个微分方程组

{u1′=9u1+24u2+5cos⁡t−13sin⁡t,u1(0)=43u2′=−24u1−51u2−9cos⁡t+13sin⁡t,u2(0)=23\begin{cases}u_1^{\prime}&=9u_1+24u_2+5\cos t-\frac13\sin t,&u_1(0)&=\frac43\\\\u_2^{\prime}&=-24u_1-51u_2-9\cos t+\frac13\sin t,&u_2(0)&=\frac23\end{cases}

应用欧拉显式法,我们该如何选择步长 hh 才能保证稳定性?

我们将条件改写为矩阵形式:

(u1′u2′)=(924−24−51)(u1u2)+(5cos⁡t−13sin⁡t−9cos⁡t+13sin⁡t)\begin{pmatrix}u_1^{\prime}\\u_2^{\prime}\end{pmatrix}=\begin{pmatrix}9&24\\-24&-51\end{pmatrix}\begin{pmatrix}u_1\\u_2\end{pmatrix}+\begin{pmatrix}5\cos t-\frac13\sin t\\-9\cos t+\frac13\sin t\end{pmatrix}

应用欧拉显式法,我们有

(u1i+1u2i+1)=(u1iu2i)+h(924−24−51)(u1iu2i)+h(5cos⁡ti−13sin⁡ti−9cos⁡ti+13sin⁡ti)\begin{pmatrix}u_1^{i+1}\\u_2^{i+1}\end{pmatrix}=\begin{pmatrix}u_1^i\\u_2^i\end{pmatrix}+h\begin{pmatrix}9&24\\-24&-51\end{pmatrix}\begin{pmatrix}u_1^i\\u_2^i\end{pmatrix}+h\begin{pmatrix}5\cos t_i-\frac13\sin t_i\\-9\cos t_i+\frac13\sin t_i\end{pmatrix}

记 A=(924−24−51)\mathbf{A}=\begin{pmatrix}9&24\\-24&-51\end{pmatrix},则

(u1i+1u2i+1)=(I+hA)(u1iu2i)+h(5cos⁡ti−13sin⁡ti−9cos⁡ti+13sin⁡ti)\begin{pmatrix}u_1^{i+1}\\u_2^{i+1}\end{pmatrix}=(\mathbf{I}+h\mathbf{A})\begin{pmatrix}u_1^i\\u_2^i\end{pmatrix}+h\begin{pmatrix}5\cos t_i-\frac13\sin t_i\\-9\cos t_i+\frac13\sin t_i\end{pmatrix}

我们给初值加上一个扰动项 ϵ0\epsilon_0 和 μ0\mu_0,即 u0∗=u0+(ϵ0μ0)\mathbf{u}^*_0=\mathbf{u}_0+\begin{pmatrix}\epsilon_0\\\mu_0\end{pmatrix},则

(u1i+1∗u2i+1∗)=(I+hA)(u1i∗u2i∗)+h(5cos⁡ti−13sin⁡ti−9cos⁡ti+13sin⁡ti)\begin{pmatrix}u_1^{i+1*}\\u_2^{i+1*}\end{pmatrix}=(\mathbf{I}+h\mathbf{A})\begin{pmatrix}u_1^{i*}\\u_2^{i*}\end{pmatrix}+h\begin{pmatrix}5\cos t_i-\frac13\sin t_i\\-9\cos t_i+\frac13\sin t_i\end{pmatrix}

上面两个式子相减,我们有

(ϵi+1μi+1)=(I+hA)(ϵiμi)\begin{pmatrix}\epsilon_{i+1}\\\mu_{i+1}\end{pmatrix}=(\mathbf{I}+h\mathbf{A})\begin{pmatrix}\epsilon_i\\\mu_i\end{pmatrix}

所以

(ϵi+1μi+1)=(I+hA)i+1(ϵ0μ0)\begin{pmatrix}\epsilon_{i+1}\\\mu_{i+1}\end{pmatrix}=(\mathbf{I}+h\mathbf{A})^{i+1}\begin{pmatrix}\epsilon_0\\\mu_0\end{pmatrix}

要确保稳定性,我们需要 ∣(I+hA)i+1∣<1|(\mathbf{I}+h\mathbf{A})^{i+1}|<1。

也就是说,我们需要 ∣1+hλ∣<1⇔−2<hλ<0|1+h\lambda|<1\Leftrightarrow -2<h\lambda<0,其中 λ\lambda 是 A\mathbf{A} 的特征值。

我们求解 A\mathbf{A} 的特征值,得到 λ1=−3\lambda_1=-3 和 λ2=−39\lambda_2=-39。

所以,我们需要 −2<hλ1<0⇔23>h>0-2<h\lambda_1<0\Leftrightarrow \frac23>h>0 和 −2<hλ2<0⇔239>h>0-2<h\lambda_2<0\Leftrightarrow \frac{2}{39}>h>0。

所以,我们需要 0<h<2390<h<\frac{2}{39}。

Chapter 6 解线性方程组的直接法 | Direct Methods for Solving Linear Systems

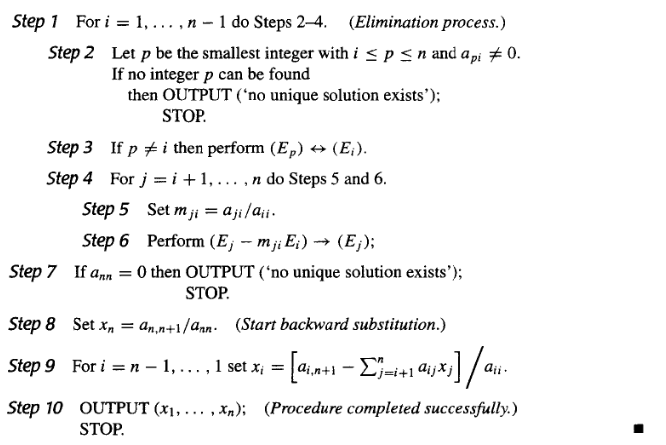
6.1 回代的Gauss消去法 | Gaussian elimination with backward substitution

算法内容

解方程组Ax⃗=b⃗\mathbf{A}\vec{x}=\vec{b},记A(1)=A=aij(1)\mathbf{A}^{(1)}=\mathbf{A}=a_{ij}^{(1)},b⃗(1)=b⃗=(b1(1)b2(1)⋮bn(1))\vec{b}^{(1)}=\vec{b}=\begin{pmatrix}b_{1}^{(1)}\\b_{2}^{(1)}\\\vdots\\b_{n}^{(1)}\end{pmatrix},x⃗(1)=x⃗=(x1(1)x2(1)⋮xn(1))\vec{x}^{(1)}=\vec{x}=\begin{pmatrix}x_{1}^{(1)}\\x_{2}^{(1)}\\\vdots\\x_{n}^{(1)}\end{pmatrix},则增广矩阵A~\tilde{\mathbf{A}}为:

A~=[a11(1)a12(1)⋯a1n(1)b1(1)a21(1)a22(1)⋯a2n(1)b2(1)⋮⋮⋱⋮⋮an1(1)an2(1)⋯ann(1)bn(1)]\tilde{\mathbf{A}}=\begin{bmatrix}a_{11}^{(1)}&a_{12}^{(1)}&\cdots&a_{1n}^{(1)}&b_{1}^{(1)}\\a_{21}^{(1)}&a_{22}^{(1)}&\cdots&a_{2n}^{(1)}&b_{2}^{(1)}\\\vdots&\vdots&\ddots&\vdots&\vdots\\a_{n1}^{(1)}&a_{n2}^{(1)}&\cdots&a_{nn}^{(1)}&b_{n}^{(1)}\end{bmatrix}

通过高斯消元我们可以得到新的增广矩阵A~(k)\tilde{\mathbf{A}}^{(k)}:

A~(k)=[a11(k)a12(k)⋯a1n(k)b1(k)0a22(k)⋯a2n(k)b2(k)⋮⋮⋱⋮⋮00⋯ann(k)bn(k)]\tilde{\mathbf{A}}^{(k)}=\begin{bmatrix}a_{11}^{(k)}&a_{12}^{(k)}&\cdots&a_{1n}^{(k)}&b_{1}^{(k)}\\0&a_{22}^{(k)}&\cdots&a_{2n}^{(k)}&b_{2}^{(k)}\\\vdots&\vdots&\ddots&\vdots&\vdots\\0&0&\cdots&a_{nn}^{(k)}&b_{n}^{(k)}\end{bmatrix}

第11次迭代过程为:如果 a11(1)≠0a_{11}^{(1)}\neq 0 ,记 mi1=ai1(1)/a11(1)m_{i1}= {a_{i1}^{(1)}}/{a_{11}^{(1)}} ,则

{aij(2)=aij(1)−mi1a1j(1)bi(2)=bi(1)−mi1b1(1)\begin{cases}a_{ij}^{(2)}=a_{ij}^{(1)}-m_{i1}a_{1j}^{(1)}\\b_{i}^{(2)}=b_{i}^{(1)}-m_{i1}b_{1}^{(1)}\end{cases}

第tt次迭代过程为:如果att(t)≠0a_{tt}^{(t)}\neq 0,记 mit=ait(t)/att(t)m_{it}={a_{it}^{(t)}}/{a_{tt}^{(t)}} ,则

{aij(t+1)=aij(t)−mitatj(t)bi(t+1)=bi(t)−mitbt(t)\begin{cases}a_{ij}^{(t+1)}=a_{ij}^{(t)}-m_{it}a_{tj}^{(t)}\\b_{i}^{(t+1)}=b_{i}^{(t)}-m_{it}b_{t}^{(t)}\end{cases}

如果att(t)=0a_{tt}^{(t)}=0,则交换第tt行与第kk行,使得akk(k)≠0a_{kk}^{(k)}\neq 0,然后再进行第kk次迭代。如果找不到akk(k)≠0a_{kk}^{(k)}\neq 0,则方程组没有唯一解,算法停止。

写成伪代码如下:

Alt text

计算次数

由于在计算机上完成乘法或除法所需的时间大致相同,且大于完成加法或减法所需的时间,所以我们分开考虑乘法和除法的计算次数。

对上述算法进行分析,可以得到计算次数如下:

消元过程

在每个 ii 中,

所以,消元过程共需要完成 ∑i=1n−1((n−i)+(n−i)(n−i+1))\sum\limits_{i=1}^{n-1}((n-i)+(n-i)(n-i+1)) 次乘法/除法和 ∑i=1n−1(n−i)(n−i+1)\sum\limits_{i=1}^{n-1}(n-i)(n-i+1) 次加法/减法。

即消元过程共需要完成 13n3+12n2−56n\frac{1}{3}n^3+\frac{1}{2}n^2-\frac{5}{6}n 次乘法/除法和 13n3−13n\frac{1}{3}n^3-\frac{1}{3}n 次加法/减法。

回代过程

Step 8 需要完成 11 次除法。

在每个 ii 中,

所以,回代过程共需要完成 1+∑i=1n−1((n−i)+1)1+\sum\limits_{i=1}^{n-1}((n-i)+1) 次乘法/除法和 ∑i=1n−1(n−i)\sum\limits_{i=1}^{n-1}(n-i) 次加法/减法。

即回代过程共需要完成 12n2+12n\frac{1}{2}n^2+\frac{1}{2}n 次乘法/除法和 12n2−12n\frac{1}{2}n^2-\frac{1}{2}n 次加法/减法。

总计算次数

乘法/除法:

(13n3+12n2−56n)+(12n2+12n)=13n3+n2−13n(\frac{1}{3}n^3+\frac{1}{2}n^2-\frac{5}{6}n)+(\frac{1}{2}n^2+\frac{1}{2}n)=\frac{1}{3}n^3+n^2-\frac{1}{3}n

加法/减法:

(13n3−13n)+(12n2−12n)=13n3+12n2−56n(\frac{1}{3}n^3-\frac{1}{3}n)+(\frac{1}{2}n^2-\frac{1}{2}n)=\frac{1}{3}n^3+\frac{1}{2}n^2-\frac{5}{6}n

从这里我们可以得知,高斯消元法的算法复杂度为O(N3)O(N^3)

6.2 选主元策略 | Pivoting Strategies

在上个算法中,我们观察到,如果与ajk(k)a_{jk}^{(k)}相比,∣akk(k)∣|a_{kk}^{(k)}|很小,那么乘数mik(k)=aik(k)akk(k)m_{ik}^{(k)}=\frac{a_{ik}^{(k)}}{a_{kk}^{(k)}}就会很大,这样就会导致误差的积累。而且在代换时,xk(k)x_{k}^{(k)}的值也会很大,这样就会导致误差的积累。所以我们需要选取一个合适的主元,使得误差的积累最小。

部分主元选取策略 | Partial Pivoting

我们考虑选择一个比较大的元素作为主元,这样就可以减小误差的积累。

所以我们可以在每次迭代时,从第kk行开始,选取该列中绝对值最大的元素作为主元,然后再进行消元。

"伪代码如下:"
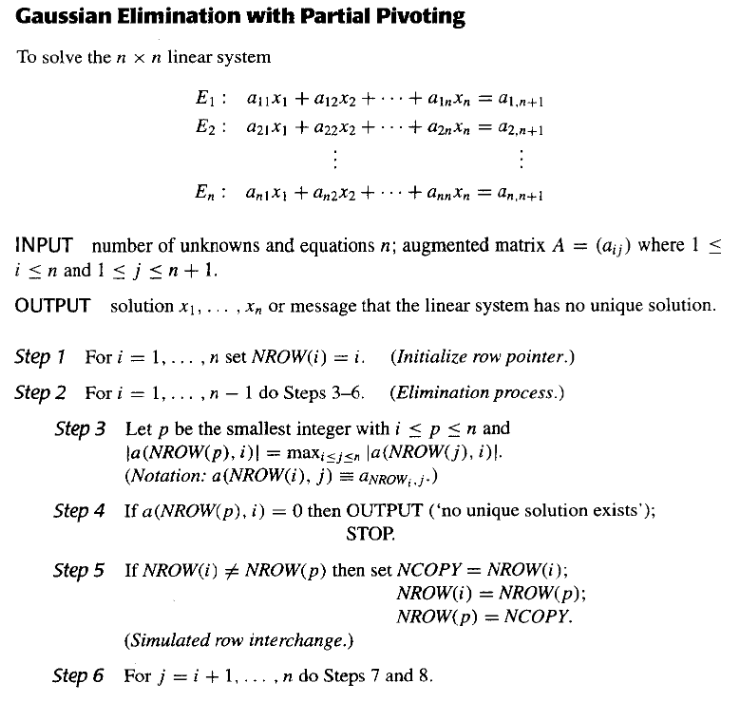
Alt text

Alt text

比例因子选取策略 | Scaling Partial Pivoting

这个方法通过比较"每一行的元素都除以该行的最大元素的绝对值",然后通过这个结果进行部分主元选取策略,再对原方程组部分进行行交换,从而选取主元。

这里的比例因子就是每一行的最大元素的绝对值,即

si=max⁡1≤j≤n∣aij∣s_{i}=\max_{1\leq j\leq n}|a_{ij}|

比例因子只在初始过程中计算一次,然后在每次迭代过程中,比例因子也需要参与交换。

"伪代码与部分主元策略的差别如下:"
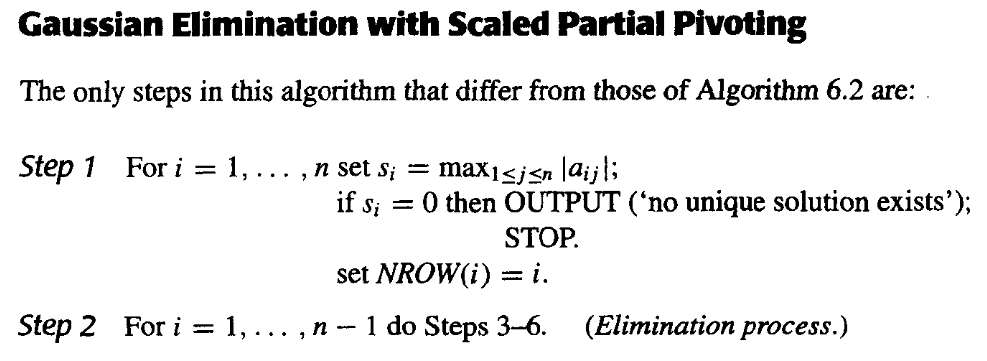
Alt text

Alt text

全主元选取策略 | Complete Pivoting

上个算法中,比例因子只在初始过程中计算一次。如果考虑到过程被修改,使得每次作行变换的决定时,要确定新的比例因子,那这种方法就是全主元选取策略(Complete Pivoting)。

6.5 矩阵分解 | Matrix Factorization

LU分解 | LU Factorization

假设Gauss消去法在此次解方程后没有进行行交换,Gauss消去法的第一步是对j=2,3,⋯ ,nj=2,3,\cdots,n行进行计算:

(Ej−mj1E1)→Ej,mj1=aj1(1)a11(1)(E_j-m_{j1}E_1)\rightarrow E_j,\quad m_{j1}=\frac{a_{j1}^{(1)}}{a_{11}^{(1)}}

那我们可以把这个过程写成矩阵的形式:

[10⋯0−m211⋯0−m310⋯0⋮⋮⋱⋮−mn10⋯1][a11(1)a12(1)⋯a1n(1)a21(1)a22(1)⋯a2n(1)⋮⋮⋱⋮an1(1)an2(1)⋯ann(1)]=[a11(1)a12(1)⋯a1n(1)0a22(2)⋯a2n(2)0a32(2)⋯a3n(2)⋮⋮⋱⋮0an2(2)⋯ann(2)]\begin{bmatrix}1&0&\cdots&0\\-m_{21}&1&\cdots&0\\-m_{31}&0&\cdots&0\\\vdots&\vdots&\ddots&\vdots\\-m_{n1}&0&\cdots&1\end{bmatrix}\begin{bmatrix}a_{11}^{(1)}&a_{12}^{(1)}&\cdots&a_{1n}^{(1)}\\a_{21}^{(1)}&a_{22}^{(1)}&\cdots&a_{2n}^{(1)}\\\vdots&\vdots&\ddots&\vdots\\a_{n1}^{(1)}&a_{n2}^{(1)}&\cdots&a_{nn}^{(1)}\end{bmatrix}=\begin{bmatrix}a_{11}^{(1)}&a_{12}^{(1)}&\cdots&a_{1n}^{(1)}\\0&a_{22}^{(2)}&\cdots&a_{2n}^{(2)}\\0&a_{32}^{(2)}&\cdots&a_{3n}^{(2)}\\\vdots&\vdots&\ddots&\vdots\\0&a_{n2}^{(2)}&\cdots&a_{nn}^{(2)}\end{bmatrix}

记最左边的矩阵为M(1)\mathbf{M}^{(1)},中间的矩阵为A(1)\mathbf{A}^{(1)},右边的矩阵为A(2)\mathbf{A}^{(2)},则有M(1)A(1)=A(2)\mathbf{M}^{(1)}\mathbf{A}^{(1)}=\mathbf{A}^{(2)}。

这里的M(1)\mathbf{M}^{(1)}称作第一Gauss交换矩阵(first Gauss transformation matrix)。

用b(2)\mathbf{b}^{(2)}表示b(1)\mathbf{b^{(1)}}经过第一次Gauss消去法后的结果,则有A(2)x=M(1)A(1)x=M(1)b(1)=b(2)\mathbf{A}^{(2)}\mathbf{x}=\mathbf{M}^{(1)}\mathbf{A}^{(1)}\mathbf{x}=\mathbf{M}^{(1)}\mathbf{b}^{(1)}=\mathbf{b}^{(2)}。

一般的,如果A(k)x=b(k)\mathbf{A}^{(k)}\mathbf{x}=\mathbf{b}^{(k)}已经构建,则由第kk个Gauss变换矩阵:

M(k)=[10⋯⋯⋯⋯⋯0010⋯⋯⋯⋯0⋮⋮⋱⋱⋯⋯⋯⋮0⋯⋯10⋯⋯00⋯⋯−mk+1,k1⋯⋯00⋯⋯−mk+2,k0⋱⋯0⋮⋮⋮⋮⋮⋱⋱⋮0⋯⋯−mn,k0⋯⋯1]\mathbf{M}^{(k)}= \begin{bmatrix} 1&0&\cdots&\cdots&\cdots&\cdots&\cdots&0\\ 0&1&0&\cdots&\cdots&\cdots&\cdots&0\\ \vdots&\vdots&\ddots&\ddots&\cdots&\cdots&\cdots&\vdots\\ 0&\cdots&\cdots&1&0&\cdots&\cdots&0\\ 0&\cdots&\cdots&-m_{k+1,k}&1&\cdots&\cdots&0\\ 0&\cdots&\cdots&-m_{k+2,k}&0&\ddots&\cdots&0\\ \vdots&\vdots&\vdots&\vdots&\vdots&\ddots&\ddots&\vdots\\ 0&\cdots&\cdots&-m_{n,k}&0&\cdots&\cdots&1 \end{bmatrix}

则有A(k+1)x=M(k)A(k)x=M(k)b(k)=b(k+1)\mathbf{A}^{(k+1)}\mathbf{x}=\mathbf{M}^{(k)}\mathbf{A}^{(k)}\mathbf{x}=\mathbf{M}^{(k)}\mathbf{b}^{(k)}=\mathbf{b}^{(k+1)}。

这个过程结束在第A(n)x=b(n)\mathbf{A}^{(n)}\mathbf{x}=\mathbf{b}^{(n)},这里的A(n)=M(n−1)A(n−2)=⋯=M(n−1)M(n−2)⋯M(1)A(1)\mathbf{A}^{(n)}=\mathbf{M}^{(n-1)}\mathbf{A}^{(n-2)}=\cdots=\mathbf{M}^{(n-1)}\mathbf{M}^{(n-2)}\cdots\mathbf{M}^{(1)}\mathbf{A}^{(1)}。由高斯消元法知道,A(n)\mathbf{A}^{(n)}是一个上三角矩阵。

此过程就形成了A=LU\mathbf{A}=\mathbf{L}\mathbf{U}的分解中的U\mathbf{U}部分,而L\mathbf{L}部分就是上文A\mathbf{A}左侧矩阵的逆矩阵,即(M(n−1)M(n−2)⋯M(1))−1=M(1)−1M(2)−1⋯M(n−1)−1\mathbf{M}^{(n-1)}\mathbf{M}^{(n-2)}\cdots\mathbf{M}^{(1)})^{-1}=\mathbf{M}^{(1)^{-1}}\mathbf{M}^{(2)^{-1}}\cdots\mathbf{M}^{(n-1)^{-1}}。

因为M(k)\mathbf{M}^{(k)}的逆矩阵就是把对角线下方的元素取反,所以L\mathbf{L}的元素为:

L(k)=(M(k))−1=[10⋯⋯⋯⋯⋯0010⋯⋯⋯⋯0⋮⋮⋱⋱⋯⋯⋯⋮0⋯⋯10⋯⋯00⋯⋯mk+1,k1⋯⋯00⋯⋯mk+2,k0⋱⋯0⋮⋮⋮⋮⋮⋱⋱⋮0⋯⋯mn,k0⋯⋯1]\mathbf{L}^{(k)}=(\mathbf{M}^{(k)})^{-1}=\begin{bmatrix}1&0&\cdots&\cdots&\cdots&\cdots&\cdots&0\\0&1&0&\cdots&\cdots&\cdots&\cdots&0\\\vdots&\vdots&\ddots&\ddots&\cdots&\cdots&\cdots&\vdots\\0&\cdots&\cdots&1&0&\cdots&\cdots&0\\0&\cdots&\cdots&m_{k+1,k}&1&\cdots&\cdots&0\\0&\cdots&\cdots&m_{k+2,k}&0&\ddots&\cdots&0\\\vdots&\vdots&\vdots&\vdots&\vdots&\ddots&\ddots&\vdots\\0&\cdots&\cdots&m_{n,k}&0&\cdots&\cdots&1\end{bmatrix}

所以

L=L(1)L(2)⋯L(n−1)=[10⋯⋯0m2110⋯0m31m32⋱⋱⋮⋮⋮⋱⋱0mn1mn2⋯mn,n−11]\mathbf{L}=\mathbf{L}^{(1)}\mathbf{L}^{(2)}\cdots\mathbf{L}^{(n-1)}=\begin{bmatrix}1&0&\cdots&\cdots&0\\m_{21}&1&0&\cdots&0\\m_{31}&m_{32}&\ddots&\ddots&\vdots\\\vdots&\vdots&\ddots&\ddots&0\\m_{n1}&m_{n2}&\cdots&m_{n,n-1}&1\end{bmatrix}

由此我们可以得到:

如果Gauss消去法在线性方程组Ax⃗=b⃗\mathbf{A}\vec{x}=\vec{b}中没有进行行交换,则A=LU\mathbf{A}=\mathbf{L}\mathbf{U},
其中

L=L(1)L(2)⋯L(n−1)=[10⋯⋯0m2110⋯0m31m32⋱⋱⋮⋮⋮⋱⋱0mn1mn2⋯mn,n−11]\mathbf{L}=\mathbf{L}^{(1)}\mathbf{L}^{(2)}\cdots\mathbf{L}^{(n-1)}=\begin{bmatrix}1&0&\cdots&\cdots&0\\m_{21}&1&0&\cdots&0\\m_{31}&m_{32}&\ddots&\ddots&\vdots\\\vdots&\vdots&\ddots&\ddots&0\\m_{n1}&m_{n2}&\cdots&m_{n,n-1}&1\end{bmatrix}

U=A(n)=[a11(1)a12(1)⋯a1n(1)0a22(2)⋯a2n(2)00⋯a3n(3)⋮⋮⋱⋮00⋯ann(n)]\mathbf{U}=\mathbf{A}^{(n)}=\begin{bmatrix}a_{11}^{(1)}&a_{12}^{(1)}&\cdots&a_{1n}^{(1)}\\0&a_{22}^{(2)}&\cdots&a_{2n}^{(2)}\\0&0&\cdots&a_{3n}^{(3)}\\\vdots&\vdots&\ddots&\vdots\\0&0&\cdots&a_{nn}^{(n)}\end{bmatrix}

如果LL是单位下三角矩阵,则这个分解是唯一的。

用反证法。

如果A=L1U1=L2U2\mathbf{A}=\mathbf{L}_1\mathbf{U}_1=\mathbf{L}_2\mathbf{U}_2,其中L1\mathbf{L}_1和L2\mathbf{L}_2是单位下三角矩阵,U1\mathbf{U}_1和U2\mathbf{U}_2是上三角矩阵。则有

U1U2−1=L1−1L2\mathbf{U_1}\mathbf{U_2}^{-1}=\mathbf{L_1}^{-1}\mathbf{L_2}

因为上三角阵的逆依然是上三角阵,下三角阵同理。所以等式左右分别为上三角阵和下三角阵。又因为L1−1L2\mathbf{L_1}^{-1}\mathbf{L_2}的对角线上的元素均为11,所以两式相等当且仅当

U1U2−1=L1−1L2=I\mathbf{U_1}\mathbf{U_2}^{-1}=\mathbf{L_1}^{-1}\mathbf{L_2}=\mathbf{I}

即U1=U2\mathbf{U_1}=\mathbf{U_2},L1=L2\mathbf{L_1}=\mathbf{L_2}。

所以这个分解是唯一的。

伪代码

先进行LU分解。

Alt text

Alt text

解第一个方程Ly⃗=b⃗\mathbf{L}\vec{y}=\vec{b}。

Alt text

解第二个方程Ux⃗=y⃗\mathbf{U}\vec{x}=\vec{y}。

Alt text

6.6 特殊类型的矩阵 | Special Types of Matrices

严格对角占优矩阵 | Strictly Diagonally Dominant Matrices

如果对矩阵A\mathbf{A}的每一行,对角线上的元素的绝对值大于该行上其他元素的绝对值之和,则称A\mathbf{A}为严格对角占优矩阵。

定理:严格对角占优矩阵是非奇异的。而且,在此情况下,Gauss消去法可用在形如Ax⃗=b⃗\mathbf{A}\vec{x}=\vec{b}的方程组中以得到唯一解,而且不需要进行或列交换,并且对于舍入误差的增长而言计算是稳定的。

正定矩阵 | Positive Definite Matrices

本书中的正定矩阵是指对称正定矩阵,与其他书中的定义不同。

一个矩阵A\mathbf{A}是正定的,如果它是对称的,并且对于所有非零向量x⃗\vec{x},都有x⃗TAx⃗>0\vec{x}^T\mathbf{A}\vec{x}>0。

"定理"

如果A\mathbf{A}是n×nn\times n的正定矩阵,则

a. A\mathbf{A}是非奇异的。

b. aii>0a_{ii}>0,i=1,2,⋯ ,ni=1,2,\cdots,n。

c. max⁡1≤k,j≤n∣akj∣<max⁡1≤i≤n∣aii∣\max\limits_{1\leq k,j\leq n}|a_{kj}|<\max\limits_{1\leq i\leq n}|a_{ii}|,其中 k≠jk\neq j。

d. (aij)2<aiiajj(a_{ij})^2<a_{ii}a_{jj},i≠ji\neq j。

重要结论:如果A\mathbf{A}是正定的,则A\mathbf{A}的所有主子式都是正的。

A=LDLT\mathbf{A}=\mathbf{L}\mathbf{D}\mathbf{L}^T分解

我们可以把A=LU\mathbf{A}=\mathbf{L}\mathbf{U}中的U\mathbf{U}进一步分解为对角矩阵D\mathbf{D}和单位上三角矩阵U~\widetilde{\mathbf{U}},如下图所示:

Alt text

我们知道,A\mathbf{A}是对称的,所以A=AT\mathbf{A}=\mathbf{A}^T,即LU=LDU~=U~TDLT\mathbf{L}\mathbf{U}=\mathbf{L}\mathbf{D}\widetilde{\mathbf{U}}=\widetilde{\mathbf{U}}^T\mathbf{D}\mathbf{L}^T,所以可以有L=U~T\mathbf{L}=\widetilde{\mathbf{U}}^T,所以A=LDLT\mathbf{A}=\mathbf{L}\mathbf{D}\mathbf{L}^T。其中L\mathbf{L}是一个主对角线为1的下三角矩阵,D\mathbf{D}是对角线元素为正值的对角矩阵。

伪代码如下:

Alt text

Cholesky分解

Alt text

取L~=LD12\widetilde{\mathbf{L}}=\mathbf{L}\mathbf{D}^{\frac{1}{2}},则有A=L~L~T\mathbf{A}=\widetilde{\mathbf{L}}\widetilde{\mathbf{L}}^T。其中L~\widetilde{\mathbf{L}}是一个具有非零对角线元素的下三角矩阵。

伪代码如下:

Alt text

Alt text

三对角矩阵 | Tridiagonal Matrices

三对角矩阵是指除了对角线和对角线上方和下方的第一条对角线外,其他元素均为0的矩阵,形式如下:

[a11a120⋯⋯0a21a22a230⋯00a32a33a34⋯0⋮⋱⋱⋱⋱⋮⋮⋯⋱⋱⋱an−1,n0⋯⋯0an,n−1ann]\begin{bmatrix}a_{11}&a_{12}&0&\cdots&\cdots&0\\a_{21}&a_{22}&a_{23}&0&\cdots&0\\0&a_{32}&a_{33}&a_{34}&\cdots&0\\\vdots&\ddots&\ddots&\ddots&\ddots&\vdots\\\vdots&\cdots&\ddots&\ddots&\ddots&a_{n-1,n}\\0&\cdots&\cdots&0&a_{n,n-1}&a_{nn}\end{bmatrix}

定理:假设A\mathbf{A}是三对角矩阵,对每个i=2,3,⋯ ,n−1i=2,3,\cdots,n-1,有ai,i−1ai,i+1≠0a_{i,i-1}a_{i,i+1}\neq 0,如果∣a11∣>∣a12∣|a_{11}|>|a_{12}|,∣aii∣>∣ai,i−1∣+∣ai,i+1∣|a_{ii}|>|a_{i,i-1}|+|a_{i,i+1}|,∣ann∣>∣an,n−1∣|a_{nn}|>|a_{n,n-1}|,则A\mathbf{A}是非奇异的,且在Crout分解中,liil_{ii}的值都是非零的。

Crout分解

Crout分解是LU分解的一种特殊情况,我们可以求出具有形式

L=[l1100⋯0l21l220⋯00l32l33⋯0⋮⋱⋱⋱⋮0⋯0ln,n−1lnn],U=[1u120⋯001u23⋯0001⋯0⋮⋱⋱⋱⋮0⋯001]\mathbf{L}=\begin{bmatrix}l_{11}&0&0&\cdots&0\\l_{21}&l_{22}&0&\cdots&0\\0&l_{32}&l_{33}&\cdots&0\\\vdots&\ddots&\ddots&\ddots&\vdots\\0&\cdots&0&l_{n,n-1}&l_{nn}\end{bmatrix},\quad\mathbf{U}=\begin{bmatrix}1&u_{12}&0&\cdots&0\\0&1&u_{23}&\cdots&0\\0&0&1&\cdots&0\\\vdots&\ddots&\ddots&\ddots&\vdots\\0&\cdots&0&0&1\end{bmatrix}

的三对角矩阵A\mathbf{A}的分解。

通过矩阵乘法,我们可以得到:

{a11=l11ai,i−1=li,i−1ai,i=li,i−1ui−1,i+li,iai,i+1=li,iui,i+1\begin{cases}a_{11}=l_{11}\\a_{i,i-1}=l_{i,i-1}\\a_{i,i}=l_{i,i-1}u_{i-1,i}+l_{i,i}\\a_{i,i+1}=l_{i,i}u_{i,i+1}\end{cases}

在求解部分,我们可以先解Lz=b\mathbf{L}\mathbf{z}=\mathbf{b},然后再解Ux=z\mathbf{U}\mathbf{x}=\mathbf{z}。有伪代码:

Alt text

Chapter 7 矩阵代数中的迭代方法 | Iterative Techniques in Matrix Algebra

7.1 向量和矩阵范数 | Norms of Vectors and Matrices

向量范数

Rn\mathbf{R}^n上的向量范数是一个函数∥⋅∥:Rn→R\|\cdot\|:\mathbf{R}^n\rightarrow\mathbf{R},满足下列条件:

  1. ∥x∥≥0\|\mathbf{x}\|\geq 0,且∥x∥=0\|\mathbf{x}\|=0当且仅当x=0\mathbf{x}=\mathbf{0};(x∈Rn\mathbf{x}\in\mathbf{R}^n)
  2. ∥αx∥=∣α∣∥x∥\|\alpha\mathbf{x}\|=|\alpha|\|\mathbf{x}\|,其中α∈R,x∈Rn\alpha\in\mathbf{R},\mathbf{x}\in\mathbf{R}^n;
  3. ∥x+y∥≤∥x∥+∥y∥\|\mathbf{x}+\mathbf{y}\|\leq\|\mathbf{x}\|+\|\mathbf{y}\|。(x,y∈Rn\mathbf{x},\mathbf{y}\in\mathbf{R}^n)

常用的向量范数有:

  1. pp-范数:∥x∥p=(∑i=1n∣xi∣p)1/p\|\mathbf{x}\|_p=(\sum\limits_{i=1}^n|x_i|^p)^{1/p},其中p≥1p\geq 1;
  2. 无穷范数:∥x∥∞=max⁡1≤i≤n∣xi∣\|\mathbf{x}\|_\infty=\max_{1\leq i\leq n}|x_i|;
向量的收敛性

Rn\mathbf{R}^n上的向量序列{x(k)}k=1∞\{\mathbf{x}^{(k)}\}_{k=1}^\infty按照向量范数∥⋅∥\|\cdot\|收敛到向量x\mathbf{x},当且仅当对于任意的ϵ>0\epsilon>0,存在整数N(ϵ)N(\epsilon),使得当k>N(ϵ)k>N(\epsilon)时,有∥x(k)−x∥<ϵ\|\mathbf{x}^{(k)}-\mathbf{x}\|<\epsilon。

对于无穷范数,如果向量序列{x(k)}k=1∞\{\mathbf{x}^{(k)}\}_{k=1}^\infty按照无穷范数∥⋅∥∞\|\cdot\|_\infty收敛到向量x\mathbf{x},当且仅当对于任意i=1,2,⋯ ,ni=1,2,\cdots,n,有lim⁡k→∞xi(k)=xi\lim_{k\rightarrow\infty}x_i^{(k)}=x_i。

范数的等价性

等价性定义:Rn\mathbf{R}^n上的向量范数∥⋅∥\|\cdot\|和∥⋅∥′\|\cdot\|'等价,当且仅当存在正常数c1,c2c_1,c_2,使得对于任意的x∈Rn\mathbf{x}\in\mathbf{R}^n,有c1∥x∥≤∥x∥′≤c2∥x∥c_1\|\mathbf{x}\|\leq\|\mathbf{x}\|'\leq c_2\|\mathbf{x}\|。

实际上,Rn\mathbf{R}^n上的所有范数都是等价的。也就是说,如果∥⋅∥\|\cdot\|和∥⋅∥′\|\cdot\|'是Rn\mathbf{R}^n上的任意两个范数,并且{x(k)}k=1∞\{\mathbf{x}^{(k)}\}_{k=1}^\infty按照∥⋅∥\|\cdot\|收敛到x\mathbf{x},那么{x(k)}k=1∞\{\mathbf{x}^{(k)}\}_{k=1}^\infty也按照∥⋅∥′\|\cdot\|'收敛到x\mathbf{x}。

我们接下来证明对于范数∥⋅∥2\|\cdot\|_2和∥⋅∥∞\|\cdot\|_\infty,它们是等价的。

"∥⋅∥2\|\cdot\|_2和∥⋅∥∞\|\cdot\|_\infty的等价性"

设∥x∥∞=max⁡1≤i≤n∣xi∣=∣xj∣\|\mathbf{x}\|_\infty=\max\limits_{1\leq i\leq n}|x_i|=|x_j|。那么

∥x∥2=∑i=1n∣xi∣2≥∣xj∣2=∣xj∣=∥x∥∞\|\mathbf{x}\|_2=\sqrt{\sum\limits_{i=1}^n|x_i|^2}\geq\sqrt{|x_j|^2}=|x_j|=\|\mathbf{x}\|_\infty

并且

∥x∥2=∑i=1n∣xi∣2≤∑i=1n∣xj∣2=n∣xj∣\|\mathbf{x}\|_2=\sqrt{\sum\limits_{i=1}^n|x_i|^2}\leq\sqrt{\sum\limits_{i=1}^n|x_j|^2}=\sqrt{n}|x_j|

所以∥x∥∞≤∥x∥2≤n∥x∥∞\|\mathbf{x}\|_\infty\leq\|\mathbf{x}\|_2\leq\sqrt{n}\|\mathbf{x}\|_\infty,即∥⋅∥2\|\cdot\|_2和∥⋅∥∞\|\cdot\|_\infty是等价的。

矩阵范数

Rn×n\mathbf{R}^{n\times n}上的矩阵范数是一个函数∥⋅∥:Rn×n→R\|\cdot\|:\mathbf{R}^{n\times n}\rightarrow\mathbf{R},满足下列条件:

  1. ∥A∥≥0\|\mathbf{A}\|\geq 0,且∥A∥=0\|\mathbf{A}\|=0当且仅当A\mathbf{A}是零矩阵;(A∈Rn×n\mathbf{A}\in\mathbf{R}^{n\times n})
  2. ∥αA∥=∣α∣∥A∥\|\alpha\mathbf{A}\|=|\alpha|\|\mathbf{A}\|,其中α∈R,A∈Rn×n\alpha\in\mathbf{R},\mathbf{A}\in\mathbf{R}^{n\times n};
  3. ∥A+B∥≤∥A∥+∥B∥\|\mathbf{A}+\mathbf{B}\|\leq\|\mathbf{A}\|+\|\mathbf{B}\|。(A,B∈Rn×n\mathbf{A},\mathbf{B}\in\mathbf{R}^{n\times n})
  4. ∥AB∥≤∥A∥∥B∥\|\mathbf{AB}\|\leq\|\mathbf{A}\|\|\mathbf{B}\|。(A,B∈Rn×n\mathbf{A},\mathbf{B}\in\mathbf{R}^{n\times n})

矩阵A\mathbf{A}和B\mathbf{B}之间的距离定义为∥A−B∥\|\mathbf{A}-\mathbf{B}\|。

Frobenius范数

A∈Rn×n\mathbf{A}\in\mathbf{R}^{n\times n}的Frobenius范数是A\mathbf{A}的所有元素的平方和的平方根,即∥A∥F=∑i=1n∑j=1naij2\|\mathbf{A}\|_F=\sqrt{\sum\limits_{i=1}^n\sum\limits_{j=1}^na_{ij}^2}。

自然矩阵范数 | Natural Matrix Norm

如果∥⋅∥\|\cdot\|是Rn×n\mathbf{R}^{n\times n}上的向量范数,那么∥A∥=max⁡∥x∥=1∥Ax∥\|\mathbf{A}\|=\max\limits_{\|\mathbf{x}\|=1}\|\mathbf{Ax}\|是Rn×n\mathbf{R}^{n\times n}上的矩阵范数,称为与向量范数∥⋅∥\|\cdot\|相关的自然矩阵范数。

∥A∥=max⁡∥x∥=1∥Ax∥\|\mathbf{A}\|=\max\limits_{\|\mathbf{x}\|=1}\|\mathbf{Ax}\|也可以写成∥A∥=max⁡x≠0∥Ax∥∥x∥\|\mathbf{A}\|=\max\limits_{\mathbf{x}\neq\mathbf{0}}\frac{\|\mathbf{Ax}\|}{\|\mathbf{x}\|}。

常用的自然矩阵范数(Natural Norm)有:

  1. pp-范数:∥A∥p=max⁡x≠0∥Ax∥p∥x∥p\|\mathbf{A}\|_p=\max\limits_{\mathbf{x}\neq\mathbf{0}}\frac{\|\mathbf{Ax}\|_p}{\|\mathbf{x}\|_p},其中p≥1p\geq 1;
  2. 无穷范数:∥A∥∞=max⁡1≤i≤n∑j=1n∣aij∣\|\mathbf{A}\|_\infty=\max\limits_{1\leq i\leq n}\sum\limits_{j=1}^n|a_{ij}|;也就是A\mathbf{A}的所有行和的最大值;
  3. 11-范数:∥A∥1=max⁡1≤j≤n∑i=1n∣aij∣\|\mathbf{A}\|_1=\max\limits_{1\leq j\leq n}\sum\limits_{i=1}^n|a_{ij}|;也就是A\mathbf{A}的所有列和的最大值;
  4. 22-范数(spectral norm):∥A∥2=λmax⁡(ATA)\|\mathbf{A}\|_2=\sqrt{\lambda_{\max}(\mathbf{A}^T\mathbf{A})},其中λmax⁡(ATA)\lambda_{\max}(\mathbf{A}^T\mathbf{A})是ATA\mathbf{A}^T\mathbf{A}的最大特征值。

"推论"

根据 pp-范数的定义,我们可以得到:对于任意非零向量 z\mathbf{z} 和矩阵 A\mathbf{A} 和任意一个自然范数 ∥⋅∥\|\cdot\|,有

∥Az∥∥z∥≤∥A∥\frac{\|\mathbf{Az}\|}{\|\mathbf{z}\|}\leq\|\mathbf{A}\|

即

∥Az∥≤∥A∥∥z∥\|\mathbf{A}\mathbf{z}\|\leq\|\mathbf{A}\|\|\mathbf{z}\|

7.2 特征值与特征向量 | Eigenvalues and Eigenvectors

谱半径 | Spectral Radius

A∈Rn×n\mathbf{A}\in\mathbf{R}^{n\times n}的谱半径定义为ρ(A)=max⁡1≤i≤n∣λi∣\rho(\mathbf{A})=\max\limits_{1\leq i\leq n}|\lambda_i|,其中λi\lambda_i是A\mathbf{A}的特征值,这里的特征值可以是复数。

ρ(A)=max⁡{1,∣1+3i∣,∣1−3i∣}=max⁡{1,2,2}=2\rho(\mathbf{A})=\max\{1,|1+\sqrt{3}i|,|1-\sqrt{3}i|\}=\max\{1,2,2\}=2。

对于任意一个自然范数∥⋅∥\|\cdot\|,有ρ(A)≤∥A∥\rho(\mathbf{A})\leq\|\mathbf{A}\|。

矩阵的收敛性

当满足以下条件时,矩阵A∈Rn×n\mathbf{A}\in\mathbf{R}^{n\times n}是收敛的:

lim⁡k→∞(Ak)ij=0\lim_{k\rightarrow\infty}(\mathbf{A}^k)_{ij}=\mathbf{0}

以下命题是等价的:

  1. 矩阵A∈Rn×n\mathbf{A}\in\mathbf{R}^{n\times n}是收敛的;
  2. ρ(A)<1\rho(\mathbf{A})<1;
  3. 对于某些自然范数∥⋅∥\|\cdot\|,有lim⁡k→∞∥Ak∥=0\lim\limits_{k\rightarrow\infty}\|\mathbf{A}^k\|=0。
  4. 对于任意的自然范数∥⋅∥\|\cdot\|,有lim⁡k→∞∥Ak∥=0\lim\limits_{k\rightarrow\infty}\|\mathbf{A}^k\|=0。
  5. 对于每一个x∈Rn\mathbf{x}\in\mathbf{R}^n,有lim⁡k→∞Akx=0\lim\limits_{k\rightarrow\infty}\mathbf{A}^k\mathbf{x}=\mathbf{0}。

7.3 求解线性方程组的迭代法 | Iterative Techniques for Solving Linear Systems

Jacobi迭代法

记矩阵A∈Rn×n\mathbf{A}\in\mathbf{R}^{n\times n}的下三角部分为−L-\mathbf{L},上三角部分为−U-\mathbf{U},对角线部分为D\mathbf{D},即A=D−L−U\mathbf{A}=\mathbf{D}-\mathbf{L}-\mathbf{U}。

所以方程组Ax=b\mathbf{Ax}=\mathbf{b}可以写成Dx=(L+U)x+b\mathbf{Dx}=(\mathbf{L}+\mathbf{U})\mathbf{x}+\mathbf{b}。

即x=D−1(L+U)x+D−1b\mathbf{x}=\mathbf{D}^{-1}(\mathbf{L}+\mathbf{U})\mathbf{x}+\mathbf{D}^{-1}\mathbf{b}。

引入符号Tj=D−1(L+U)\mathbf{T}_j=\mathbf{D}^{-1}(\mathbf{L}+\mathbf{U}),cj=D−1b\mathbf{c}_j=\mathbf{D}^{-1}\mathbf{b},则x=Tjx+cj\mathbf{x}=\mathbf{T}_j\mathbf{x}+\mathbf{c}_j。

Jacobi迭代法的迭代格式为:

x(k+1)=Tjx(k)+cj\mathbf{x}^{(k+1)}=\mathbf{T}_j\mathbf{x}^{(k)}+\mathbf{c}_j

其伪代码为:

Alt text

Gauss-Seidel迭代法

我们可以改进Jacobi迭代法,使得每次迭代时,都使用已经算出来的x(k)\mathbf{x}^{(k)}的元素来计算x(k)\mathbf{x}^{(k)}之后的元素。如下图所示:

Alt text

也就是说,可以使用:

xi(k)=−∑j=1i−1aijxj(k)−∑j=i+1naijxj(k−1)+biaiix_i^{(k)}=\frac{-\sum\limits_{j=1}^{i-1}a_{ij}x_j^{(k)}-\sum\limits_{j=i+1}^na_{ij}x_j^{(k-1)}+b_i}{a_{ii}}

来计算xi(k)x_i^{(k)}。

结合之前D\mathbf{D},L\mathbf{L},U\mathbf{U}的定义,我们可以得到:

(D−L)x(k)=Ux(k−1)+b(\mathbf{D}-\mathbf{L})\mathbf{x}^{(k)}=\mathbf{U}\mathbf{x}^{(k-1)}+\mathbf{b}

即:

x(k)=(D−L)−1Ux(k−1)+(D−L)−1b\mathbf{x}^{(k)}=(\mathbf{D}-\mathbf{L})^{-1}\mathbf{U}\mathbf{x}^{(k-1)}+(\mathbf{D}-\mathbf{L})^{-1}\mathbf{b}

引入符号Tg=(D−L)−1U\mathbf{T}_{g}=(\mathbf{D}-\mathbf{L})^{-1}\mathbf{U},cg=(D−L)−1b\mathbf{c}_{g}=(\mathbf{D}-\mathbf{L})^{-1}\mathbf{b},则x=Tgx(k−1)+cg\mathbf{x}=\mathbf{T}_{g}\mathbf{x}^{(k-1)}+\mathbf{c}_{g}。

Gauss-Seidel迭代法的迭代格式为:

x(k+1)=Tgx(k)+cg\mathbf{x}^{(k+1)}=\mathbf{T}_{g}\mathbf{x}^{(k)}+\mathbf{c}_{g}

其伪代码为:

Alt text

Alt text

两种迭代法的收敛性

对于任意一个x(0)∈Rn\mathbf{x}^{(0)}\in\mathbf{R}^n,由

x(k+1)=Tx(k)+c\mathbf{x}^{(k+1)}=\mathbf{Tx}^{(k)}+\mathbf{c}

定义的序列 {x(k)}k=0∞\{\mathbf{x}^{(k)}\}_{k=0}^\infty 收敛到x=Tx+c\mathbf{x}=\mathbf{Tx}+\mathbf{c}的唯一解,当且仅当ρ(T)<1\rho(\mathbf{T})<1。

"证明"

⇐\Leftarrow:

设ρ(T)<1\rho(\mathbf{T})<1,那么

x(k)=Tx(k−1)+c=T(Tx(k−2)+c)+c=T2x(k−2)+(T+I)c⋮=Tkx(0)+(Tk−1+Tk−2+⋯+T+I)c\begin{aligned} \mathbf{x}^{(k)}=&\mathbf{Tx}^{(k-1)}+\mathbf{c}\\ =&\mathbf{T}(\mathbf{Tx}^{(k-2)}+\mathbf{c})+\mathbf{c}\\ =&\mathbf{T}^2\mathbf{x}^{(k-2)}+(\mathbf{T}+\mathbf{I})\mathbf{c}\\ \vdots&\\ =&\mathbf{T}^k\mathbf{x}^{(0)}+(\mathbf{T}^{k-1}+\mathbf{T}^{k-2}+\cdots+\mathbf{T}+\mathbf{I})\mathbf{c}\\ \end{aligned}

由于ρ(T)<1\rho(\mathbf{T})<1,所以矩阵T\mathbf{T}是收敛的,且lim⁡k→∞Tkx(0)=0\lim\limits_{k\rightarrow\infty}\mathbf{T}^k\mathbf{x}^{(0)}=\mathbf{0}

由于lim⁡k→∞(Tk−1+Tk−2+⋯+T+I)c=(I−T)−1c\lim\limits_{k\rightarrow\infty}(\mathbf{T}^{k-1}+\mathbf{T}^{k-2}+\cdots+\mathbf{T}+\mathbf{I})\mathbf{c}=(\mathbf{I}-\mathbf{T})^{-1}\mathbf{c},所以lim⁡k→∞x(k)=(I−T)−1c=x\lim\limits_{k\rightarrow\infty}\mathbf{x}^{(k)}=(\mathbf{I}-\mathbf{T})^{-1}\mathbf{c}=\mathbf{x},这里的x\mathbf{x}就是x=Tx+c\mathbf{x}=\mathbf{Tx}+\mathbf{c}的唯一解。

⇒\Rightarrow:

设{x(k)}k=0∞\{\mathbf{x}^{(k)}\}_{k=0}^\infty收敛到x=Tx+c\mathbf{x}=\mathbf{Tx}+\mathbf{c}的唯一解,取任意一个向量y∈Rn\mathbf{y}\in\mathbf{R}^n,定义x(0)=x−y\mathbf{x}^{(0)}=\mathbf{x}-\mathbf{y},那么

x−x(k)=(Tx+c)−(Tx(k−1)+c)=T(x−x(k−1))\mathbf{x}-\mathbf{x}^{(k)}=(\mathbf{Tx}+\mathbf{c})-(\mathbf{Tx}^{(k-1)}+\mathbf{c})=\mathbf{T}(\mathbf{x}-\mathbf{x}^{(k-1)})

所以

x−x(k)=Tk(x−x(0))=Tky\mathbf{x}-\mathbf{x}^{(k)}=\mathbf{T}^k(\mathbf{x}-\mathbf{x}^{(0)})=\mathbf{T}^k\mathbf{y}

因此

lim⁡k→∞Tky=lim⁡k→∞(x−x(k))=0\lim_{k\rightarrow\infty}\mathbf{T}^k\mathbf{y}=\lim_{k\rightarrow\infty}(\mathbf{x}-\mathbf{x}^{(k)})=\mathbf{0}

由于y\mathbf{y}是任意的,根据矩阵的收敛性,ρ(T)<1\rho(\mathbf{T})<1。

误差界 | Error Bounds for Iterative Methods

如果对任意自然矩阵范数∥T∥<1\|\mathbf{T}\|<1,c\mathbf{c}是给定的向量,那么由x(k+1)=Tx(k)+c\mathbf{x}^{(k+1)}=\mathbf{Tx}^{(k)}+\mathbf{c}定义的序列{x(k)}k=0∞\{\mathbf{x}^{(k)}\}_{k=0}^\infty收敛到x=Tx+c\mathbf{x}=\mathbf{Tx}+\mathbf{c}的唯一解,且有误差界:

  1. ∥x−x(k)∥≤∥T∥k∥x(0)−x∥\|\mathbf{x}-\mathbf{x}^{(k)}\|\leq\|\mathbf{T}\|^k\|\mathbf{x}^{(0)}-\mathbf{x}\|;
  2. ∥x−x(k)∥≤∥T∥k1−∥T∥∥x(1)−x(0)∥\|\mathbf{x}-\mathbf{x}^{(k)}\|\leq\frac{\|\mathbf{T}\|^k}{1-\|\mathbf{T}\|}\|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\|;

通过(2)式,我们可以根据我们要的精度算出迭代次数kk

"证明(1)式"

x−x(k)=(Tx+c)−(Tx(k−1)+c)=T(x−x(k−1))\mathbf{x}-\mathbf{x}^{(k)}=(\mathbf{Tx}+\mathbf{c})-(\mathbf{Tx}^{(k-1)}+\mathbf{c})=\mathbf{T}(\mathbf{x}-\mathbf{x}^{(k-1)})

所以

∥x−x(k)∥=∥T(x−x(k−1))∥≤∥T∥∥x−x(k−1)∥≤∥T∥k∥x−x(0)∥\begin{aligned} \|\mathbf{x}-\mathbf{x}^{(k)}\|&=\|\mathbf{T}(\mathbf{x}-\mathbf{x}^{(k-1)})\|\\ &\leq\|\mathbf{T}\|\|\mathbf{x}-\mathbf{x}^{(k-1)}\|\\ &\leq\|\mathbf{T}\|^k\|\mathbf{x}-\mathbf{x}^{(0)}\| \end{aligned}

∥x(k)−x∥≈ρ(T)k∥x(0)−x∥\|\mathbf{x}^{(k)}-\mathbf{x}\|\approx\rho(T)^k\|\mathbf{x}^{(0)}-\mathbf{x}\|

"证明(2)式"

∥x(k+1)−x(k)∥=∥T(x(k)−x(k−1))∥≤∥T∥∥x(k)−x(k−1)∥≤∥T∥k∥x(1)−x(0)∥\begin{aligned} \|\mathbf{x}^{(k+1)}-\mathbf{x}^{(k)}\| &=\|\mathbf{T}(\mathbf{x}^{(k)}-\mathbf{x}^{(k-1)})\|\\ &\leq\|\mathbf{T}\|\|\mathbf{x}^{(k)}-\mathbf{x}^{(k-1)}\|\\ &\leq\|\mathbf{T}\|^k \|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\| \end{aligned}

所以对于任意的m≥nm\geq n,有

∥x(m)−x(n)∥=∥x(m)−x(m−1)+x(m−1)−x(m−2)+⋯+x(n+1)−x(n)∥≤∥x(m)−x(m−1)∥+∥x(m−1)−x(m−2)∥+⋯+∥x(n+1)−x(n)∥≤∥T∥m−1∥x(1)−x(0)∥+∥T∥m−2∥x(1)−x(0)∥+⋯+∥T∥n∥x(1)−x(0)∥=∥x(1)−x(0)∥∑k=nm−1∥T∥k\begin{aligned} \|\mathbf{x}^{(m)}-\mathbf{x}^{(n)}\| &=\|\mathbf{x}^{(m)}-\mathbf{x}^{(m-1)}+\mathbf{x}^{(m-1)}-\mathbf{x}^{(m-2)}+\cdots+\mathbf{x}^{(n+1)}-\mathbf{x}^{(n)}\|\\ &\leq\|\mathbf{x}^{(m)}-\mathbf{x}^{(m-1)}\|+\|\mathbf{x}^{(m-1)}-\mathbf{x}^{(m-2)}\|+\cdots+\|\mathbf{x}^{(n+1)}-\mathbf{x}^{(n)}\|\\ &\leq\|\mathbf{T}\|^{m-1}\|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\|+\|\mathbf{T}\|^{m-2}\|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\|+\cdots+\|\mathbf{T}\|^{n}\|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\|\\ &=\|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\|\sum\limits_{k=n}^{m-1}\|\mathbf{T}\|^k\\ \end{aligned}

当m→∞m\rightarrow\infty时,∑k=nm−1∥T∥k=∥T∥n1−∥T∥\sum\limits_{k=n}^{m-1}\|\mathbf{T}\|^k=\frac{\|\mathbf{T}\|^n}{1-\|\mathbf{T}\|},所以

∥x−x(n)∥≤∥T∥n1−∥T∥∥x(1)−x(0)∥\|\mathbf{x}-\mathbf{x}^{(n)}\|\leq\frac{\|\mathbf{T}\|^n}{1-\|\mathbf{T}\|}\|\mathbf{x}^{(1)}-\mathbf{x}^{(0)}\|

对于严格对角占优矩阵

如果A\mathbf{A}是严格对角占优的,那么Jacobi迭代法和Gauss-Seidel迭代法都是收敛的。

证明其不存在大于1的特征值

松弛法 | Relaxation Methods

假设x~∈Rn\tilde{\mathbf{x}}\in R^n是Ax=b\mathbf{Ax}=\mathbf{b}的一个近似解,那么相对于该方程组的剩余向量(residual vector)为r=b−Ax~\mathbf{r}=\mathbf{b}-\mathbf{A}\tilde{\mathbf{x}}。

我们从剩余向量的视角来看Gauss-Seidel迭代法。

xi(k)=−∑j=1i−1aijxj(k)−∑j=i+1naijxj(k−1)+biaii=xi(k−1)+1aii(bi−∑j=1i−1aijxj(k)−∑j=inaijxj(k−1))=xi(k−1)+ri(k)aii\begin{aligned} x_i^{(k)}&=\frac{-\sum\limits_{j=1}^{i-1}a_{ij}x_j^{(k)}-\sum\limits_{j=i+1}^na_{ij}x_j^{(k-1)}+b_i}{a_{ii}} \\ &=x_i^{(k-1)}+\frac{1}{a_{ii}}(b_i-\sum\limits_{j=1}^{i-1}a_{ij}x_j^{(k)}-\sum\limits_{j=i}^na_{ij}x_j^{(k-1)}) \\ &=x_i^{(k-1)}+\frac{r_i^{(k)}}{a_{ii}} \end{aligned}

我们可以添加一个参数ω\omega,使得

xi(k)=xi(k−1)+ωri(k)aiix_i^{(k)}=x_i^{(k-1)}+\omega\frac{r_i^{(k)}}{a_{ii}}

这就是松弛法的基本思想,可以用来减少剩余向量的范数和加速收敛。

根据ω\omega的取值,松弛法可以分为:

  1. ω<1\omega<1:欠松弛法(Under-Relaxation methods);可使由Gauss-Seidel方法不能收敛的方程组收敛;
  2. ω=1\omega=1:退化为Gauss-Seidel迭代法;
  3. ω>1\omega>1:超松弛法(Over-Relaxation methods);可使收敛速度加快。

这些方法缩写为SOR方法(Successive Over-Relaxation)。

SOR方法的矩阵形式

我们尝试把SOR方法的迭代格式写成矩阵形式:

xi(k)=xi(k−1)+ωri(k)aii=xi(k−1)+ωaii(bi−∑j=1i−1aijxj(k)−∑j=inaijxj(k−1))=(1−ω)xi(k−1)+ωaii(bi−∑j=1i−1aijxj(k)−∑j=i+1naijxj(k−1))\begin{aligned} x_i^{(k)}&=x_i^{(k-1)}+\omega\frac{r_i^{(k)}}{a_{ii}}\\ &=x_i^{(k-1)}+\frac{\omega}{a_{ii}}(b_i-\sum\limits_{j=1}^{i-1}a_{ij}x_j^{(k)}-\sum\limits_{j=i}^na_{ij}x_j^{(k-1)}) \\ &=(1-\omega)x_i^{(k-1)}+\frac{\omega}{a_{ii}}(b_i-\sum\limits_{j=1}^{i-1}a_{ij}x_j^{(k)}-\sum\limits_{j=i+1}^na_{ij}x_j^{(k-1)}) \\ \end{aligned}

所以

x(k)=(1−ω)x(k−1)+ωD−1(b+Lx(k)+Ux(k−1))(I−ωD−1L)x(k)=((1−ω)I+ωD−1U)x(k−1)+ωD−1bx(k)=(I−ωD−1L)−1((1−ω)I+ωD−1U)x(k−1)+(I−ωD−1L)−1ωD−1bx(k)=(D−ωL)−1((1−ω)D+ωU)x(k−1)+ω(D−ωL)−1b\begin{aligned} \mathbf{x}^{(k)}&=(1-\omega)\mathbf{x}^{(k-1)}+\omega\mathbf{D}^{-1}(\mathbf{b}+\mathbf{L}\mathbf{x}^{(k)}+\mathbf{U}\mathbf{x}^{(k-1)}) \\ (\mathbf{I}-\omega\mathbf{D}^{-1}\mathbf{L})\mathbf{x}^{(k)}&=((1-\omega)\mathbf{I}+\omega\mathbf{D}^{-1}\mathbf{U})\mathbf{x}^{(k-1)}+\omega\mathbf{D}^{-1}\mathbf{b} \\ \mathbf{x}^{(k)}&=(\mathbf{I}-\omega\mathbf{D}^{-1}\mathbf{L})^{-1}((1-\omega)\mathbf{I}+\omega\mathbf{D}^{-1}\mathbf{U})\mathbf{x}^{(k-1)}+(\mathbf{I}-\omega\mathbf{D}^{-1}\mathbf{L})^{-1}\omega\mathbf{D}^{-1}\mathbf{b} \\ \mathbf{x}^{(k)}&=(\mathbf{D}-\omega\mathbf{L})^{-1}((1-\omega)\mathbf{D}+\omega\mathbf{U})\mathbf{x}^{(k-1)}+\omega(\mathbf{D}-\omega\mathbf{L})^{-1}\mathbf{b} \\ \end{aligned}

记Tω=(D−ωL)−1((1−ω)D+ωU)\mathbf{T}_{\omega}=(\mathbf{D}-\omega\mathbf{L})^{-1}((1-\omega)\mathbf{D}+\omega\mathbf{U}),cω=ω(D−ωL)−1b\mathbf{c}_{\omega}=\omega(\mathbf{D}-\omega\mathbf{L})^{-1}\mathbf{b},则SOR方法的迭代格式为:

x(k)=Tωx(k−1)+cω\mathbf{x}^{(k)}=\mathbf{T}_{\omega}\mathbf{x}^{(k-1)}+\mathbf{c}_{\omega}

Kahan定理

如果aii≠0(i=1,2,⋯ ,n)a_{ii}\neq 0(i=1,2,\cdots,n),那么ρ(Tω)≥∣ω−1∣\rho(\mathbf{T}_{\omega})\geq|\omega-1|。这表明,SOR方法当且仅当ω∈(0,2)\omega\in(0,2)时收敛。

Ostrowski-Reich定理

如果A\mathbf{A}是一个正定矩阵,并且ω∈(0,2)\omega\in(0,2),那么SOR方法对于任意的初始近似向量x(0)∈Rn\mathbf{x}^{(0)}\in\mathbf{R}^n都收敛。

ω\omega的最佳选择

如果A\mathbf{A}是一个正定的三对角矩阵,那么ρ(Tg)=[ρ(Tj)]2<1\rho(\mathbf{T}_{g})=[\rho(\mathbf{T}_{j})]^2<1,并且SOR方法的最佳ω\omega选择是:

ωopt=21+1−[ρ(Tj)]2\omega_{opt}=\frac{2}{1+\sqrt{1-[\rho(\mathbf{T}_{j})]^2}}

由此选择的ω\omega,有ρ(Tω)=ω−1\rho(\mathbf{T}_{\omega})=\omega-1。

SOR伪代码

Alt text

Alt text

7.4 误差界与迭代改进 | Error Bounds and Iterative Refinement

误差界

对于线性方程组 Ax=b\mathbf{Ax}=\mathbf{b} ,A\mathbf{A}是非奇异的。如果 A\mathbf{A} 和 b\mathbf{b} 存在误差,那么解 x\mathbf{x} 也会存在误差。

A\mathbf{A} 精确,b\mathbf{b} 有误差

即 Ax=b\mathbf{Ax}=\mathbf{b} 变成 A(x+δx)=b+δb\mathbf{A(x+\delta x)}=\mathbf{b}+\delta\mathbf{b} 。所以有:

Aδx=δb⇒δx=A−1δb\begin{aligned} \mathbf{A}\delta\mathbf{x}&=\delta\mathbf{b}\\ \Rightarrow \delta\mathbf{x}&=\mathbf{A}^{-1}\delta\mathbf{b}\\ \end{aligned}

根据推论

对于任意向量 z≠0\mathbf{z}\neq\mathbf{0},矩阵 A\mathbf{A} 和任意一个自然范数 ∥⋅∥\|\cdot\|,有

∥Az∥∥z∥≤∥A∥\frac{\|\mathbf{Az}\|}{\|\mathbf{z}\|}\leq\|\mathbf{A}\|

我们有:

∥δx∥≤∥A−1∥∥δb∥\| \delta\mathbf{x} \|\leq\|\mathbf{A}^{-1}\|\|\delta\mathbf{b}\|\\

b=Ax⇒∥b∥=∥Ax∥≤∥A∥∥x∥\mathbf{b}=\mathbf{Ax}\Rightarrow\|\mathbf{b}\|=\|\mathbf{Ax}\|\leq\|\mathbf{A}\|\|\mathbf{x}\|\\

所以

∥δx∥∥x∥≤∥A∥∥A−1∥∥δb∥∥b∥\frac{\|\delta\mathbf{x}\|}{\|\mathbf{x}\|}\leq\|\mathbf{A}\|\|\mathbf{A}^{-1}\|\frac{\|\delta\mathbf{b}\|}{\|\mathbf{b}\|}

我们记非奇异矩阵 AA 相对于范数 ∥⋅∥\|\cdot\| 的条件数为:

K(A)=∥A∥∥A−1∥K(\mathbf{A})=\|\mathbf{A}\|\|\mathbf{A}^{-1}\|

当 K(A)K(\mathbf{A}) 很大时,A\mathbf{A} 是病态的,当 K(A)K(\mathbf{A}) 接近于 11 时,A\mathbf{A} 是良态的。

A\mathbf{A} 有误差,b\mathbf{b} 精确

即 Ax=b\mathbf{Ax}=\mathbf{b} 变成 (A+δA)(x+δx)=b\mathbf{(A+\delta A)(x+\delta x)}=\mathbf{b} 。所以有:

(A+δA)δx+xδA=0(\mathbf{A}+\delta\mathbf{A})\delta\mathbf{x}+\mathbf{x}\delta\mathbf{A}=0

这里的 δA\delta\mathbf{A} 往往是一个小量。

"证明∥(I+A−1δA)−1∥≤11−∥A−1δA∥\|\mathbf{(I+A^{-1}\delta A)^{-1}}\|\leq\frac{1}{1-\|\mathbf{A^{-1}\delta A}\|}"

"推论"

对于矩阵 F\mathbf{F},若∥F∥<1\|\mathbf{F}\|<1,则I±F\mathbf{I}\pm\mathbf{F}是非奇异的,且

∥(I±F)−1∥≤11−∥F∥\left\|\left(\mathbf{I}\pm \mathbf{F}\right)^{-1}\right\|\leq\frac1{1-\left\|\mathbf{F}\right\|}

"下面给出 I−F\mathbf{I} - \mathbf{F}情况的证明"

因为 ∥−F∥=∥F∥<1\|\mathbf{-F}\|=\|\mathbf{F}\|<1,所以我们将−F\mathbf{-F}替换 F\mathbf{F} ,就可以得到 I+F\mathbf{I+F}情况的证明

Alt text

"推论"

∥A−1∥p=1min⁡∣∣Ax∣∣p∣∣x∣∣p\|\mathbf{A}^{-1}\|_{p}=\frac{1}{\min\frac{\left|\left|\mathbf{A}\mathbf{x}\right|\right|p}{\left|\left|\mathbf{x}\right|\right|p}}

"证明"

∥A−1∥p=max⁡x≠0∥A−1x∥p∥x∥p)=max⁡Ax≠0∥A−1Ax∥p∥A−1x∥p=max⁡x≠0∥x∥p∥Ax∥p=max⁡x≠01∥Ax∥p∥x∥p=1min⁡∣∣Ax∣∣p∣∣x∣∣p\begin{aligned} &\|\mathbf{A}^{-1}\|_{p}\\ =&\max_{\mathbf{x}\neq0}\frac{\|\mathbf{A}^{-1}\mathbf{x}\|_{p}}{\|\mathbf{x}\|_{p}})\\ =&\max_{\mathbf{A}\mathbf{x}\neq0}\frac{\| \mathbf{A}^{-1}\mathbf{A}\mathbf{x}\|p}{\parallel \mathbf{A}^{-1}\mathbf{x}\|p} \\ =&\max_{\mathbf{x}\neq0}\frac{\|\mathbf{x}\|p}{\|\mathbf{A}\mathbf{x}\|p} \\ =&\max_{\mathbf{x}\neq0}\frac{1}{\frac{\|\mathbf{A}\mathbf{x}\|p}{\|\mathbf{x}\|p}} \\ =&\frac{1}{\min\frac{\left|\left|\mathbf{A}\mathbf{x}\right|\right|p}{\left|\left|\mathbf{x}\right|\right|p}} \end{aligned}

我们有

(A+δA)=A(I+A−1δA)\mathbf{(A+\delta A)}=\mathbf{A}\mathbf{(I+A^{-1}\delta A)}

而

∥A−1δA∥≤∥A−1∥∥δA∥=∥δA∥min⁡∣∣Ax1∣∣p∣∣x1∣∣p\|\mathbf{A^{-1}\delta A}\| \leq \|\mathbf{A^{-1}}\|\|\mathbf{\delta A}\| =\frac{\|\mathbf{\delta A}\|}{\min\frac{\left|\left|\mathbf{A}\mathbf{x_1}\right|\right|p}{\left|\left|\mathbf{x_1}\right|\right|p}}

因为∥δA∥\|\delta\mathbf{A}\|相对于∥A∥\|\mathbf{A}\|很小,所以往往有∥A−1δA∥≤1\|\mathbf{A^{-1}\delta A}\|\leq 1,所以I+A−1δA\mathbf{I+A^{-1}\delta A}是非奇异的,且

∥(I+A−1δA)−1∥≤11−∥A−1δA∥\|\mathbf{(I+A^{-1}\delta A)^{-1}}\|\leq\frac{1}{1-\|\mathbf{A^{-1}\delta A}\|}

所以在∥A−1δA∥≤1\|\mathbf{A^{-1}\delta A}\|\leq 1的情况下(我们不妨将其放缩为∥δA∥≤∥1A−1∥\|\mathbf{\delta A}\|\leq\|\frac{\mathbf{1}}{A^{-1}}\|),有:

∥(I+A−1δA)−1∥≤11−∥A−1δA∥\|\mathbf{(I+A^{-1}\delta A)^{-1}}\|\leq\frac{1}{1-\|\mathbf{A^{-1}\delta A}\|}

所以

(A+δA)δx+xδA=0A(I+A−1δA)δx=−xδAδx=−(I+A−1δA)−1A−1xδA∥δx∥≤∥(I+A−1δA)−1∥∥A−1∥∥x∥∥δA∥≤∥A−1∥∥x∥∥δA∥1−∥A−1∥∥δA∥\begin{aligned} (\mathbf{A}+\delta\mathbf{A})\delta\mathbf{x}+\mathbf{x}\delta\mathbf{A}&=0\\ \mathbf{A}(I+\mathbf{A}^{-1}\delta\mathbf{A})\delta\mathbf{x}&=-\mathbf{x}\delta\mathbf{A}\\ \delta\mathbf{x} &= -(I+\mathbf{A}^{-1}\delta\mathbf{A})^{-1}\mathbf{A}^{-1}\mathbf{x}\delta\mathbf{A}\\ \|\delta\mathbf{x}\| &\leq\|\mathbf{(I+A^{-1}\delta A)^{-1}}\|\|\mathbf{A}^{-1}\|\|\mathbf{x}\|\|\delta\mathbf{A}\|\\ &\leq \frac{\|\mathbf{A}^{-1}\|\|\mathbf{x}\|\|\delta\mathbf{A}\|}{1-\|\mathbf{A}^{-1}\|\|\delta\mathbf{A}\|}\\ \end{aligned}

所以:

∥δx∥∥x∥≤∥A−1∥∥δA∥1−∥A−1∥∥δA∥=K(A)∥δA∥∥A∥1−K(A)∥δA∥∥A∥\frac{\|\delta\mathbf{x}\|}{\|\mathbf{x}\|}\leq\frac{\|\mathbf{A}^{-1}\|\|\delta\mathbf{A}\|}{1-\|\mathbf{A}^{-1}\|\|\delta\mathbf{A}\|}=\frac{K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}{1-K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}

A\mathbf{A},b\mathbf{b} 都有误差

即 Ax=b\mathbf{Ax}=\mathbf{b} 变成 (A+δA)(x+δx)=b+δb\mathbf{(A+\delta A)(x+\delta x)}=\mathbf{b}+\delta\mathbf{b} 。所以有:

(A+δA)δx+xδA=δb\begin{aligned} (\mathbf{A}+\delta\mathbf{A})\delta\mathbf{x}+\mathbf{x}\delta\mathbf{A}&=\delta\mathbf{b}\\ \end{aligned}

所以,当∥δA∥<1∥A−1∥\|\delta\mathbf{A}\|<\frac{1}{\|\mathbf{A}^{-1}\|}时,有:

δx=(I+A−1δA)−1A−1(δb−xδA)\begin{aligned} \delta\mathbf{x}&=(I+\mathbf{A}^{-1}\delta\mathbf{A})^{-1}\mathbf{A}^{-1}(\delta\mathbf{b}-\mathbf{x}\delta\mathbf{A})\\ \end{aligned}

所以

∥δx∥≤∥A−1∥1−∥A−1∥∥δA∥∥δb−xδA∥≤∥A−1∥1−∥A−1∥∥δA∥(∥δb∥+∥x∥∥δA∥)≤K(A)1−K(A)∥δA∥∥A∥(∥δb∥∥A∥+∥x∥∥δA∥∥A∥)≤K(A)1−K(A)∥δA∥∥A∥(∥δb∥∥A∥∥x∥+∥δA∥∥A∥)∥x∥≤K(A)1−K(A)∥δA∥∥A∥(∥δb∥∥Ax∥+∥δA∥∥A∥)∥x∥≤K(A)1−K(A)∥δA∥∥A∥(∥δb∥∥b∥+∥δA∥∥A∥)∥x∥\begin{aligned} \|\delta\mathbf{x}\|&\leq \frac{\|\mathbf{A}^{-1}\|}{1-\|\mathbf{A}^{-1}\|\|\delta\mathbf{A}\|}\|\delta\mathbf{b}-\mathbf{x}\delta\mathbf{A}\|\\ &\leq \frac{\|\mathbf{A}^{-1}\|}{1-\|\mathbf{A}^{-1}\|\|\delta\mathbf{A}\|}(\|\delta\mathbf{b}\|+\|\mathbf{x}\|\|\delta\mathbf{A}\|)\\ &\leq \frac{K(\mathbf{A})}{1-K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}(\frac{\|\delta\mathbf{b}\|}{\|\mathbf{A}\|}+\frac{\|\mathbf{x}\|\|\delta\mathbf{A}\|}{\|\mathbf{A}\|})\\ &\leq \frac{K(\mathbf{A})}{1-K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}(\frac{\|\delta\mathbf{b}\|}{\|\mathbf{A}\|\|\mathbf{x}\|}+\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|})\|\mathbf{x}\|\\ &\leq \frac{K(\mathbf{A})}{1-K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}(\frac{\|\delta\mathbf{b}\|}{\|\mathbf{A}\mathbf{x}\|}+\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|})\|\mathbf{x}\|\\ &\leq \frac{K(\mathbf{A})}{1-K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}(\frac{\|\delta\mathbf{b}\|}{\|\mathbf{b}\|}+\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|})\|\mathbf{x}\|\\ \end{aligned}

因此,当∥δA∥<1∥A−1∥\|\delta\mathbf{A}\|<\frac{1}{\|\mathbf{A}^{-1}\|}时,有:

∥δx∥∥x∥≤K(A)1−K(A)∥δA∥∥A∥(∥δb∥∥b∥+∥δA∥∥A∥)\frac{\|\delta\mathbf{x}\|}{\|\mathbf{x}\|}\leq\frac{K(\mathbf{A})}{1-K(\mathbf{A})\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|}}(\frac{\|\delta\mathbf{b}\|}{\|\mathbf{b}\|}+\frac{\|\delta\mathbf{A}\|}{\|\mathbf{A}\|})

K(A)K(\mathbf{A}) 的性质

我们记非奇异矩阵 AA 相对于范数 ∥⋅∥\|\cdot\| 的条件数为:

K(A)=∥A∥∥A−1∥K(\mathbf{A})=\|\mathbf{A}\|\|\mathbf{A}^{-1}\|

当 K(A)K(\mathbf{A}) 很大时,A\mathbf{A} 是病态的,当 K(A)K(\mathbf{A}) 接近于 11 时,A\mathbf{A} 是良态的。

  1. K(A)p≥1K(\mathbf{A})_p\geq 1 对所有的自然范数 ∥⋅∥p\|\cdot\|_p 成立;
  2. 如果 A\mathbf{A} 是对称的,那么 K(A)2=∣λmax∣∣λmin∣K(\mathbf{A})_2=\frac{|\lambda_{max}|}{|\lambda_{min}|},其中 λmax\lambda_{max} 和 λmin\lambda_{min} 分别是 A\mathbf{A} 的最大和最小特征值;
  3. K(aA)=K(A)K(a\mathbf{A})=K(\mathbf{A}),其中 aa 是一个非零常数;
  4. K(A)2=1K(\mathbf{A})_2=1 当且仅当 A\mathbf{A} 是正交矩阵(ATA=I\mathbf{A}^T\mathbf{A}=\mathbf{I});
  5. K(RA)2=K(AR)2=K(A)2K(\mathbf{RA})_2 =K(\mathbf{AR})_2 = K(\mathbf{A})_2,其中 R\mathbf{R} 是一个正交矩阵;

题目例子

Alt text

"(1)"

Alt text

"(2)"

Alt text

Chapter 8 逼近论 | Approximation Theory

逼近和插值的区别在于,插值是要求通过所有的数据点,而逼近没有这个限制,而是要求逼近的函数和原函数的误差尽可能小——尽可能接近每个点。

8.1 Discrete Least Squares Approximation | 离散最小二乘逼近

误差表达

设 p(x)p(x) 是逼近函数,yiy_{i} 是给定的 nn 个数据点,那么逼近误差的三种表达方式如下:

Minimax problem

E∞(p)=max⁡{∣yi−f(x)∣}E_\infty(p) = \max \{|y_i - f(x)|\}

这用初等技术是解决不了的

Absolute deviation

E1(p)=∑i=1n∣yi−f(x)∣E_1(p) = \sum\limits_{i=1}^{n} |y_i - f(x)|

困难在于绝对值函数在零点不可微,可能无法求解多元函数的最小值。

Least squares

E2(p)=∑i=1n(yi−f(x))2E_2(p) = \sum\limits_{i=1}^{n} (y_i - f(x))^2

此即为最小二乘的误差表达,也是最常用的逼近方法。

我们的目标是找到一个 p(x)p(x),使得 E2(p)E_2(p) 最小。

离散最小二乘逼近

定义: Pn(x)P_n(x) 是 mm 个数据点的离散最小二乘逼近,如果 Pn(x)P_n(x) 是 nn 次多项式,且满足

p=arg⁡min⁡p∈Pn∑i=1m(yi−p(xi))2p=\arg \min _{p \in \mathbb{P}_{n}} \sum\limits_{i=1}^{m}\left(y_{i}-p\left(x_{i}\right)\right)^{2}

其中 Pn\mathbb{P}_{n} 是 nn 次多项式的集合,nn 应远远小于 mm,如果 n=m−1n=m-1,其即为 lagrange 插值。

离散最小二乘逼近的解

设 Pn(x)=a0+a1x+⋯+anxn=∑i=0naixiP_n(x) = a_0 + a_1 x + \cdots + a_n x^n= \sum\limits_{i=0}^{n} a_i x^i。

E2=∑i=1m(yi−Pn(xi))2\begin{aligned} E_2&=\sum\limits_{i=1}^{m}\left(y_{i}-P_n\left(x_{i}\right)\right)^{2} \\ \end{aligned}

为了使 E2E_2 最小,则其必要条件是

∂E2∂ak=0,k=0,1,⋯ ,n\frac{\partial E_{2}}{\partial a_{k}}=0, \quad k=0,1, \cdots, n

即

∂E2∂ak=2∑i=1m(Pn(xi)−yi)∂Pn(xi)∂ak=2∑i=1m(∑j=0najxij−yi)xik=2(∑j=0n(aj∑i=1mxij+k)−∑i=1myixik)=0\begin{aligned} \frac{\partial E_{2}}{\partial a_{k}}&=2 \sum\limits_{i=1}^{m}\left(P_{n}\left(x_{i}\right)-y_{i}\right) \frac{\partial P_{n}\left(x_{i}\right)}{\partial a_{k}}\\ &=2 \sum\limits_{i=1}^{m}\left(\sum _{j=0}^{n} a_j x_i^j - y_i\right) x_i^k\\ &=2 \left(\sum\limits_{j=0}^{n} (a_j \sum\limits_{i=1}^{m} x_i^{j+k}) - \sum\limits_{i=1}^{m} y_i x_i^k \right)= 0 \end{aligned}

即

∑j=0n(aj∑i=1mxij+k)=∑i=1myixik,k=0,1,⋯ ,n\sum\limits_{j=0}^{n} (a_{j} \sum\limits_{i=1}^{m} x_{i}^{j+k})=\sum\limits_{i=1}^{m} y_{i} x_{i}^{k}, \quad k=0,1, \cdots, n

也就是

[∑i=1mxi0∑i=1mxi1⋯∑i=1mxin∑i=1mxi1∑i=1mxi2⋯∑i=1mxin+1⋮⋮⋱⋮∑i=1mxin∑i=1mxin+1⋯∑i=1mxi2n][a0a1⋮an]=[∑i=1myixi0∑i=1myixi1⋮∑i=1myixin]\begin{bmatrix} \sum\limits_{i=1}^{m} x_{i}^{0} & \sum\limits_{i=1}^{m} x_{i}^{1} & \cdots & \sum\limits_{i=1}^{m} x_{i}^{n} \\ \sum\limits_{i=1}^{m} x_{i}^{1} & \sum\limits_{i=1}^{m} x_{i}^{2} & \cdots & \sum\limits_{i=1}^{m} x_{i}^{n+1} \\ \vdots & \vdots & \ddots & \vdots \\ \sum\limits_{i=1}^{m} x_{i}^{n} & \sum\limits_{i=1}^{m} x_{i}^{n+1} & \cdots & \sum\limits_{i=1}^{m} x_{i}^{2 n} \end{bmatrix} \begin{bmatrix} a_0\\ a_1\\ \vdots\\ a_n \end{bmatrix}= \begin{bmatrix} \sum\limits_{i=1}^{m} y_{i} x_{i}^{0}\\ \sum\limits_{i=1}^{m} y_{i} x_{i}^{1}\\ \vdots\\ \sum\limits_{i=1}^{m} y_{i} x_{i}^{n} \end{bmatrix}

P(x)P(x) 线性

即 n=1n=1 。此时,P1(x)=a0+a1xP_1(x) = a_0 + a_1 x,有

[m∑i=1mxi∑i=1mxi∑i=1mxi2][a0a1]=[∑i=1myi∑i=1myixi]\begin{bmatrix} m & \sum\limits_{i=1}^{m} x_{i} \\ \sum\limits_{i=1}^{m} x_{i} & \sum\limits_{i=1}^{m} x_{i}^{2} \end{bmatrix} \begin{bmatrix} a_0\\ a_1 \end{bmatrix}= \begin{bmatrix} \sum\limits_{i=1}^{m} y_{i}\\ \sum\limits_{i=1}^{m} y_{i} x_{i} \end{bmatrix}

所以

{a0=∑i=1mxi2∑i=1myi−∑i=1mxi∑i=1mxiyim∑i=1mxi2−(∑i=1mxi)2a1=m∑i=1mxiyi−∑i=1mxi∑i=1myim∑i=1mxi2−(∑i=1mxi)2\begin{cases} a_0 = \frac{\sum\limits_{i=1}^{m} x_{i}^{2} \sum\limits_{i=1}^{m} y_{i}-\sum\limits_{i=1}^{m} x_{i} \sum\limits_{i=1}^{m} x_{i} y_{i}}{m \sum\limits_{i=1}^{m} x_{i}^{2}-\left(\sum\limits_{i=1}^{m} x_{i}\right)^{2}}\\ a_1 = \frac{m \sum\limits_{i=1}^{m} x_{i} y_{i}-\sum\limits_{i=1}^{m} x_{i} \sum\limits_{i=1}^{m} y_{i}}{m \sum\limits_{i=1}^{m} x_{i}^{2}-\left(\sum\limits_{i=1}^{m} x_{i}\right)^{2}} \end{cases}

P(x)=xax+bP(x)=\frac{x}{ax+b}

令 Yi=1yiY_i = \frac{1}{y_i},Xi=1xiX_i = \frac{1}{x_i},则可化为

Yi=a+bXiY_i = a + bX_i

线性最小二乘即可

P(x)=ae−b/xP(x)=a e^{-b/x}

令 Yi=ln⁡yiY_i = \ln y_i,Xi=1xiX_i = \frac{1}{x_i},则可化为

Yi=ln⁡a−bXiY_i = \ln a - bX_i

线性最小二乘即可。

8.2 Orthogonal Polynomials and Least Squares Approximation | 正交多项式与最小二乘逼近

刚刚是离散化的最小二乘逼近,现在是连续的最小二乘逼近。

给定定义在 [a,b][a,b] 上的函数 f(x)f(x),我们希望找到一个 简单的函数 p(x)p(x) 来逼近 f(x)f(x),使得

E=∫ab∣f(x)−p(x)∣2dxE = \int_{a}^{b}\left|f(x)-p(x)\right|^{2} d x

最小。

广义多项式(Generalized Polynomial):用线性无关的函数 ϕ0(x),ϕ1(x),⋯ ,ϕn(x)\phi_0(x), \phi_1(x), \cdots, \phi_n(x) 的线性组合 P(x)=∑i=0naiϕi(x)P(x)=\sum\limits_{i=0}^{n} a_{i} \phi_{i}(x) 来逼近 f(x)f(x),这里的 P(x)P(x) 称为广义多项式。

  • Trigonometric polynomial: ϕi(x)=cos⁡(ix)\phi_{i}(x)=\cos (i x) or sin⁡(ix)\sin (i x)
  • Exponential polynomial: ϕi(x)=ekix,ki≠kj\phi_{i}(x)=e^{k_i x}, k_i \neq k_j
  • 记 Πn(x)\Pi_n(x) 为 阶数最多为 nn 的多项式的集合,Πn(x)\Pi_n(x) 是一个线性空间,Πn(x)\Pi_n(x) 的基为 {1,x,x2,⋯ ,xn}\{1, x, x^2, \cdots, x^n\},可以拿来做广义多项式的基。
Weight Function | 权函数

离散的情况下,为了在某些点上分配不同程度的重要性,我们在计算离散最小二乘逼近的误差表达式时附上权重:

E=∑i=1mwi(yi−p(xi))2E = \sum\limits_{i=1}^{m} w_i (y_i - p(x_i))^2

连续的情况下,我们也可以引入权重函数 w(x)w(x),使得

E=∫abw(x)∣f(x)−p(x)∣2dxE = \int_{a}^{b} w(x) \left|f(x)-p(x)\right|^{2} d x

Inner Product and Norm | 内积与范数

我们定义内积为

⟨f,g⟩={∑i=1mwif(xi)g(xi)离散∫abw(x)f(x)g(x)dx连续\langle f, g\rangle= \begin{cases} \sum\limits_{i=1}^{m} w_i f(x_i) g(x_i) & \text{离散}\\ \int_{a}^{b} w(x) f(x) g(x) d x & \text{连续} \end{cases}

如果 ⟨f,g⟩=0\langle f, g\rangle = 0,则称 ff 和 gg 正交。

我们定义范数为

∥f∥=⟨f,f⟩\|f\|=\sqrt{\langle f, f\rangle}

所以我们可以把误差表达式写成

E=⟨f−p,f−p⟩=∥f−p∥2E = \langle f-p, f-p\rangle=\|f-p\|^2

寻找多项式的系数

设 P(x)=a0ϕ0(x)+a1ϕ1(x)+⋯+anϕn(x)P(x)=a_{0} \phi_{0}(x)+a_{1} \phi_{1}(x)+\cdots+a_{n} \phi_{n}(x),与离散的情况类似,我们要使得 EE 最小,即

∂E∂ak=0∂(∫abw(x)∣∑i=0naiϕi(x)−f(x)∣2)dx∂ak=0∂(∫abw(x)((∑i=0naiϕi(x))2−2f(x)∑i=0naiϕi(x)+f(x)2))dx∂ak=0∫abw(x)(2ϕk(x)∑i=0naiϕi(x)−2f(x)ϕk(x))dx=0∫abw(x)ϕk(x)∑i=0naiϕi(x)dx=∫abw(x)ϕk(x)f(x)dx∑i=0nai∫abw(x)ϕk(x)ϕi(x)dx=∫abw(x)ϕk(x)f(x)dx∑i=0nai⟨ϕk,ϕi⟩=⟨ϕk,f⟩\begin{aligned} \frac{\partial E}{\partial a_{k}}&=0\\ \frac{\partial (\int_{a}^{b} w(x) \left|\sum\limits_{i=0}^{n} a_{i} \phi_{i}(x)-f(x)\right|^{2} ) d x}{\partial a_{k}}&=0\\ \frac{\partial (\int_{a}^{b} w(x) ((\sum\limits_{i=0}^{n} a_{i} \phi_{i}(x))^2-2f(x)\sum\limits_{i=0}^{n} a_{i} \phi_{i}(x)+f(x)^2) )d x}{\partial a_{k}}&=0\\ \int_{a}^{b} w(x) (2\phi_{k}(x)\sum\limits_{i=0}^{n} a_{i} \phi_{i}(x)-2f(x)\phi_{k}(x)) d x&=0\\ \int_{a}^{b} w(x) \phi_{k}(x)\sum\limits_{i=0}^{n} a_{i} \phi_{i}(x) d x&=\int_{a}^{b} w(x)\phi_{k}(x)f(x) d x\\ \sum\limits_{i=0}^{n} a_{i} \int_{a}^{b} w(x) \phi_{k}(x)\phi_{i}(x) d x&=\int_{a}^{b} w(x) \phi_{k}(x)f(x) d x\\ \sum\limits_{i=0}^{n} a_{i} \langle \phi_{k}, \phi_{i}\rangle&=\langle \phi_{k},f\rangle\\ \end{aligned}

写成矩阵形式即为

[⟨ϕ0,ϕ0⟩⟨ϕ0,ϕ1⟩⋯⟨ϕ0,ϕn⟩⟨ϕ1,ϕ0⟩⟨ϕ1,ϕ1⟩⋯⟨ϕ1,ϕn⟩⋮⋮⋱⋮⟨ϕn,ϕ0⟩⟨ϕn,ϕ1⟩⋯⟨ϕn,ϕn⟩][a0a1⋮an]=[⟨ϕ0,f⟩⟨ϕ1,f⟩⋮⟨ϕn,f⟩]\begin{bmatrix} \langle \phi_{0}, \phi_{0}\rangle & \langle \phi_{0}, \phi_{1}\rangle & \cdots & \langle \phi_{0}, \phi_{n}\rangle \\ \langle \phi_{1}, \phi_{0}\rangle & \langle \phi_{1}, \phi_{1}\rangle & \cdots & \langle \phi_{1}, \phi_{n}\rangle \\ \vdots & \vdots & \ddots & \vdots \\ \langle \phi_{n}, \phi_{0}\rangle & \langle \phi_{n}, \phi_{1}\rangle & \cdots & \langle \phi_{n}, \phi_{n}\rangle \end{bmatrix} \begin{bmatrix} a_0\\ a_1\\ \vdots\\ a_n \end{bmatrix}= \begin{bmatrix} \langle \phi_{0},f\rangle\\ \langle \phi_{1},f\rangle\\ \vdots\\ \langle \phi_{n},f\rangle \end{bmatrix}

左边的矩阵为对称矩阵。

"离散例子"

可以证明,离散时的式子也是这样的。

Alt text

构造正交多项式

由 Hij(n)=1i+j−1H_{ij}^{(n)}=\frac{1}{i+j-1} 定义的 n×nn\times n 的 Hilbert 矩阵是一个病态矩阵。在求解中往往因为舍入误差而导致结果不准确。

为了解决这个问题,我们可以通过正交化的方法来构造正交多项式,也就是让前文中提到的矩阵变成对角矩阵。这样就不需要进行求逆了。

此时的系数可以直接通过

ak=⟨ϕk,f⟩⟨ϕk,ϕk⟩a_k = \frac{\langle \phi_{k},f\rangle}{\langle \phi_{k}, \phi_{k}\rangle}

来计算。

我们可以构造出一系列的正交多项式。用下面定义的多项式函数集 {ϕ0(x),ϕ1(x),⋯ ,ϕn(x)}\{\phi_{0}(x), \phi_{1}(x), \cdots, \phi_{n}(x)\} 关于权函数 w(x)w(x) 是正交的:

ϕ0(x)=1,ϕ1(x)=x−B1,ϕk(x)=(x−Bk)ϕk−1(x)−Ckϕk−2(x),k=2,3,⋯\phi_{0}(x)=1, \quad \phi_{1}(x)=x-B_{1}, \quad \phi_{k}(x)=(x-B_{k}) \phi_{k-1}(x)-C_{k} \phi_{k-2}(x), \quad k=2,3, \cdots

其中 BkB_k 和 CkC_k 是常数,可以通过

Bk=⟨xϕk−1,ϕk−1⟩⟨ϕk−1,ϕk−1⟩,Ck=⟨xϕk−1,ϕk−2⟩⟨ϕk−2,ϕk−2⟩B_{k}=\frac{\langle x \phi_{k-1}, \phi_{k-1}\rangle}{\langle \phi_{k-1}, \phi_{k-1}\rangle}, \quad C_{k}=\frac{\langle x\phi_{k-1}, \phi_{k-2}\rangle}{\langle \phi_{k-2}, \phi_{k-2}\rangle}

来计算。

"题目例子"

Alt text

里面各项已经在之前的图片中计算过了。

伪代码

Alt text

其中误差的计算推导如下:

Alt text

8.3 Chebyshev Polynomials and Economization of Power Series | 切比雪夫多项式与幂级数的缩减

Chebyshev Polynomials | 切比雪夫多项式
Target 1

上文我们知道了误差的计算方式,现在我们试图找到一个 nn 阶多项式 PnP_n 来逼近函数,使得误差 ∥Pn−f∥\|P_n-f\| 最小。

若 P(x0)−f(x0)=±∥Pn−f∥P(x_0)-f(x_0)=\pm \|P_n-f\| ,则定义点 x0x_0 为 Deviation point

我们的多项式 PnP_n 有如下性质:

Alt text

Target 2.0

决定插值点 {x0,⋯ ,xn}\{x_0, \cdots, x_n\} 使得 Pn(x)P_n(x) 最小化余项。余项为:

∣Pn(x)−f(x)∣=∣Rn(x)∣=∣f(n+1)(ξ)(n+1)!∏i=0n(x−xi)∣|P_n(x)-f(x)|=|R_n(x)|=\left|\frac{f^{(n+1)}(\xi)}{(n+1)!}\prod_{i=0}^n(x-x_i)\right|

Target 2.1

找到插值点 {x1,⋯ ,xn}\{x_1, \cdots, x_n\} 使得 ∣∣wn∣∣∞||w_n||_\infty 在 [−1,1][-1,1]上最小化,其中 wn(x)=∏i=1n(x−xi)w_n(x)=\prod\limits_{i=1}^n(x-x_i)

注意到

wn(x)=xn−Pn−1(x)w_n(x)=x^n-P_{n-1}(x)

这里的 Pn−1(x)P_{n-1}(x) 是 n−1n-1 阶多项式,和上文的 Pn(x)P_n(x) 不是一个东西,此语境下没有关联。

Target 3.0

问题转化为找到 x1,⋯ ,xnx_1, \cdots, x_n 使得 ∣∣xn−Pn−1(x)∣∣∞||x^n-P_{n-1}(x)||_\infty 在 [−1,1][-1,1]上最小化。

从切比雪夫定理我们知道,Pn−1(x)P_{n-1}(x) 相对于 xnx^n 有 n+1n+1 个偏差点,也就是说,wn(x)w_n(x) 在 n+1n+1 个点上交替取得最大值和最小值。

引入Chebyshev Polynomials

为了实现上面的目标,我们先想到三角函数。cos(nθ)cos(n\theta) 在 [−1,1][-1,1] 上有 n+1n+1 个交替的最大值和最小值,但是 cos(nθ)cos(n\theta) 不是多项式。
又由于 cos(nθ)cos(n\theta) 可以表示为 ∑k=0nak(cos⁡θ)k\sum\limits_{k=0}^{n} a_k (\cos\theta)^k,这就是我们想要的多项式形式。

令 x=cos⁡θx=\cos\theta,则 x∈[−1,1]x \in [-1,1],所以我们可以把 cos(nθ)cos(n\theta) 写成 Tn(x)T_n(x) 的形式,Tn(x)T_n(x) 称为切比雪夫多项式(Chebyshev polynomial)。

Tn(x)=cos⁡(n⋅arccos⁡x)T_{n}(x)=\cos (n \cdot \arccos x)

切比雪夫多项式的性质:

我们也可以用递推公式来定义切比雪夫多项式:

T0(x)=1T1(x)=xTn(x)=2xTn−1(x)−Tn−2(x),n=2,3,⋯\begin{aligned} T_{0}(x)&=1\\ T_{1}(x)&=x\\ T_{n}(x)&=2 x T_{n-1}(x)-T_{n-2}(x), \quad n=2,3, \cdots \end{aligned}

可以得出性质:

通过计算得出

⟨Tn,Tm⟩=∫−11Tn(x)Tm(x)1−x2dx={πn=m=0π2n=m≠00n≠m\langle T_{n}, T_{m}\rangle= \int _{-1}^{1} \frac{T_{n}(x) T_{m}(x)}{\sqrt{1-x^{2}}} d x=\left\{\begin{array}{ll}{\pi} & {n=m=0} \\ {\frac{\pi}{2}} & {n=m \neq 0} \\ {0} & {n \neq m}\end{array}\right.

回到 Target 3.0

我们可以把 wnw_n 写成 Tn(x)T_n(x) 的形式:

wn(x)=xn−Pn−1(x)=Tn(x)2n−1w_{n}(x)=x^{n}-P_{n-1}(x)=\frac{T_{n}(x)}{2^{n-1}}

称之为首一切比雪夫多项式(The monic Chebyshev polynomial)。

可以证明,首一切比雪夫多项式是所有首一多项式中,最小化 ∣∣wn∣∣∞||w_n||_\infty 的多项式。

回到 Target 2.1

我们将 wnw_n 写成 Tn(x)T_n(x) 的形式:

min⁡wn∈Π~n∥wn∥∞=∥Tn(x)2n−1∥∞=12n−1\min_{w_n\in \tilde\Pi_n} \|w_{n}\|_{\infty}=\big\|\frac{T_{n}(x)}{2^{n-1}}\big\|_{\infty}=\frac{1}{2^{n-1}}

这里的 Π~n\tilde\Pi_n 是所有首一多项式的集合。

所以,我们取的插值点即为 Tn(x)T_n(x) 的 nn 个零点

回到 Target 2.0

在 [−1,1]上选取的插值点为[-1,1] 上选取的插值点为T_n(x)的的n$ 个零点,能够使得余项最小,其上确界为

max⁡x∈[−1,1]∣f(x)−Pn(x)∣≤12n(n+1)!max⁡x∈[−1,1]∣f(n+1)(x)∣\max _{x \in[-1,1]}\left|f(x)-P_{n}(x)\right| \leq \frac{1}{2^{n}(n+1) !} \max _{x \in[-1,1]}\left|f^{(n+1)}(x)\right|

使用线性变换 x=b−a2t+b+a2x=\frac{b-a}{2} t+\frac{b+a}{2},我们可以将其推广到闭区间 [a,b][a,b] 上。

例题

Alt text

Economization of Power Series | 幂级数的缩减

考虑到,用一个 nn 阶多项式 Pn(x)=anxn+an−1xn−1+⋯+a1x+a0P_n(x) = a_n x^n + a_{n-1} x^{n-1} + \cdots + a_1 x + a_0 来逼近一个任意的 nn 阶多项式 Pn(x)P_n(x),我们可以通过去掉 Pn(x)P_n(x) 中的 含 anxna_n x^n 项的 nn 阶多项式 Qn(x)Q_n(x) 来逼近 Pn(x)P_n(x),那么

max⁡x∈[−1,1]∣f(x)−Pn−1(x)∣≤max⁡x∈[−1,1]∣f(x)−Pn(x)∣+max⁡x∈[−1,1]∣Qn(x)∣+max⁡x∈[−1,1]∣Pn(x)−Pn−1(x)−Qn(x)∣≤max⁡x∈[−1,1]∣f(x)−Pn(x)∣+max⁡x∈[−1,1]∣Qn(x)∣\begin{aligned} \max _{x \in[-1,1]}\left|f(x)-P_{n-1}(x)\right| &\leq \max _{x \in[-1,1]}\left|f(x)-P_{n}(x)\right|+\max _{x \in[-1,1]}\left|Q_{n}(x)\right|+\max _{x \in[-1,1]}\left|P_{n}(x)-P_{n-1}(x)-Q_{n}(x)\right|\\ &\leq \max _{x \in[-1,1]}\left|f(x)-P_{n}(x)\right|+\max _{x \in[-1,1]}\left|Q_{n}(x)\right| \end{aligned}

为了使得精确度的损失最小, Qn(x)Q_n(x) 必须为

an⋅Tn(x)2n−1a_n \cdot \frac{T_n(x)}{2^{n-1}}

例题

Alt text

降两阶就都要做两次。

Chapter 9 逼近特征值 | Approximating Eigenvalues

9.2 幂法 | Power Method

幂法是用来确定矩阵的主特征值(即,绝对值最大的特征值)和对应的特征向量的一种方法。

基本思想

设A\mathbf{A}是一个n×nn\times n的矩阵,且恰有一个特征值λ1\lambda_1的绝对值最大
有nn个特征值λ1,λ2,⋯ ,λn\lambda_1,\lambda_2,\cdots,\lambda_n(∣λ1∣>∣λ2∣≥⋯≥∣λn∣|\lambda_1|>|\lambda_2|\geq\cdots\geq|\lambda_n|),对应的特征向量为v1,v2,⋯ ,vn\mathbf{v}_1,\mathbf{v}_2,\cdots,\mathbf{v}_n,则任意一个非零向量x(0)\mathbf{x}^{(0)}都可以表示为这nn个特征向量的线性组合,记βj\beta_j为常数,则

x(0)=∑j=1nβjvj\mathbf{x}^{(0)}=\sum\limits_{j=1}\limits^n\beta_j\mathbf{v}_j

x(0)≠0\mathbf{x}^{(0)} \neq 0,且(x(0),v1)≠0(\mathbf{x}^{(0)},\mathbf{v}_1)\neq 0,否则:因为我们无法确保对于任意的初始向量x(0)\mathbf{x}^{(0)}都有β1≠0\beta_1\neq 0,所以迭代的结果可能不是v1\mathbf{v}_1,而是满足 (x(0),vm)≠0(\mathbf{x}^{(0)},\mathbf{v}_m)\neq 0 的第一个向量vm\mathbf{v}_m,相应地,得到的特征值为 λm\lambda_m 。

等式两边同时左乘A,A2,⋯ ,Ak\mathbf{A},\mathbf{A}^2,\cdots,\mathbf{A}^k,得到

x(1)=Ax=∑j=1nβjAvj=∑j=1nβjλjvjx(2)=A2x=∑j=1nβjA2vj=∑j=1nβjλj2vj⋮x(k)=Akx=∑j=1nβjAkvj=∑j=1nβjλjkvj=λ1k∑j=1nβj(λjλ1)kvj\begin{aligned} \mathbf{x}^{(1)}=\mathbf{A}\mathbf{x}&=\sum\limits_{j=1}\limits^n\beta_j\mathbf{A}\mathbf{v}_j=\sum\limits_{j=1}\limits^n\beta_j\lambda_j\mathbf{v}_j\\ \mathbf{x}^{(2)}=\mathbf{A}^2\mathbf{x}&=\sum\limits_{j=1}\limits^n\beta_j\mathbf{A}^2\mathbf{v}_j=\sum\limits_{j=1}\limits^n\beta_j\lambda_j^2\mathbf{v}_j\\ &\vdots\\ \mathbf{x}^{(k)}=\mathbf{A}^k\mathbf{x}&=\sum\limits_{j=1}\limits^n\beta_j\mathbf{A}^k\mathbf{v}_j=\sum\limits_{j=1}\limits^n\beta_j\lambda_j^k\mathbf{v}_j=\lambda_1^k\sum\limits_{j=1}\limits^n\beta_j(\frac{\lambda_j}{\lambda_1})^k\mathbf{v}_j \end{aligned}

所以

lim⁡k→∞Akx=lim⁡k→∞λ1k∑j=1nβj(λjλ1)kvj=lim⁡k→∞β1λ1kv1\lim\limits_{k\to\infty}\mathbf{A}^k\mathbf{x}=\lim\limits_{k\to\infty}\lambda_1^k\sum\limits_{j=1}\limits^n\beta_j(\frac{\lambda_j}{\lambda_1})^k\mathbf{v}_j=\lim\limits_{k\to\infty}\beta_1\lambda_1^k\mathbf{v}_1

如果∣λ1∣<1|\lambda_1|<1,则lim⁡k→∞Akx=0\lim\limits_{k\to\infty}\mathbf{A}^k\mathbf{x}=0,即x\mathbf{x}收敛到0向量。如果∣λ1∣>1|\lambda_1|>1,则序列发散。

对足够大的kk,x(k),x(k−1)\mathbf{x}^{(k)},\mathbf{x}^{(k-1)}可以近似地表示为

x(k)≈β1λ1kv1,x(k−1)≈β1λ1k−1v1⇒x(k)x(k−1)≈λ1\mathbf{x}^{(k)}\approx\beta_1\lambda_1^k\mathbf{v}_1, \quad\mathbf{x}^{(k-1)}\approx\beta_1\lambda_1^{k-1}\mathbf{v}_1\quad \Rightarrow\quad\frac{\mathbf{x}^{(k)}}{\mathbf{x}^{(k-1)}}\approx\lambda_1

所以,我们可以通过迭代x(k)=Ax(k−1)\mathbf{x}^{(k)}=\mathbf{A}\mathbf{x}^{(k-1)}来逼近λ1\lambda_1。

归一化

实际计算时,为了避免计算过程中出现绝对值过大或过小的数参加运算,通常在每步迭代时,将向量“归一化”即用的按模最大的分量。

我们需要对x(k)\mathbf{x}^{(k)}进行归一化,使得∥x(k)∥∞=1\|\mathbf{x}^{(k)}\|_\infty=1,即

u(k−1)=x(k−1)∥x(k−1)∥∞,x(k)=Au(k−1)⇒u(k)=x(k)∥x(k)∥∞,λ1≈xi(k)ui(k−1)=∥x(k)∥∞\mathbf{u}^{(k-1)}=\frac{\mathbf{x}^{(k-1)}}{\|\mathbf{x}^{(k-1)}\|_\infty},\quad \mathbf{x}^{(k)}=\mathbf{A}\mathbf{u}^{(k-1)}\\ \Rightarrow \mathbf{u}^{(k)}=\frac{\mathbf{x}^{(k)}}{\|\mathbf{x}^{(k)}\|_\infty},\quad \lambda_1\approx\frac{\mathbf{x}_{i}^{(k)}}{\mathbf{u}_{i}^{(k-1)}}=\|\mathbf{x}^{(k)}\|_\infty

伪代码

Alt text

Alt text

  • 对唯一的主特征值λ1\lambda_1,如果其重数大于1,则幂法仍然有效
  • 如果λ1=−λ2\lambda_1=-\lambda_2,则幂法失效
  • 因为我们无法确保对于任意的初始向量x(0)\mathbf{x}^{(0)}都有β1≠0\beta_1\neq 0,所以迭代的结果可能不是v1\mathbf{v}_1,而是满足 (x(0),vm)≠0(\mathbf{x}^{(0)},\mathbf{v}_m)\neq 0 的第一个向量vm\mathbf{v}_m,相应地,得到的特征值为 λm\lambda_m 。
  • Aitken's Δ2\Delta^2 可以加速收敛

收敛速度

因为x(k)=λ1k∑j=1nβj(λjλ1)kvj\mathbf{x}^{(k)}=\lambda_1^k\sum\limits_{j=1}\limits^n\beta_j(\frac{\lambda_j}{\lambda_1})^k\mathbf{v}_j,假设λ1>λ2≥⋯≥λn\lambda_1>\lambda_2\geq\cdots\geq\lambda_n,且∣λ2∣≥∣λn∣|\lambda_2|\geq |\lambda_n|,则我们的目标就是让λ2λ1\frac{\lambda_2}{\lambda_1}尽可能小,这样收敛速度更快。

Alt text

记B=A−pI\mathbf{B}=\mathbf{A}-p\mathbf{I},其中p=λ2+λn2p=\frac{\lambda_2+\lambda_n}{2},则B\mathbf{B}的特征值为λ1−p,λ2−p,⋯ ,λn−p\lambda_1-p,\lambda_2-p,\cdots,\lambda_n-p,因为∣λ2−pλ1−p∣<∣λ2λ1∣|\frac{\lambda_2-p}{\lambda_1-p}|<|\frac{\lambda_2}{\lambda_1}|,所以此时B\mathbf{B}的收敛速度更快。

但是我们并不知道λ2\lambda_2和λn\lambda_n,所以这不一定是一个好的选择。

反幂法 | Inverse Power Method

反幂法一般是用来确定A\mathbf{A}中与特定数qq最接近的特征值,即λi≈q\lambda_i\approx q。
此时对任意的j≠ij\neq i,有

∣λi−q∣≪∣λj−q∣|\lambda_i-q|\ll|\lambda_j-q|

根据刚刚在收敛速度中的分析,可知:此时 (A−qI)−1(\mathbf{A}-q\mathbf{I})^{-1} 的主特征值凸显出来了,可以更快地收敛到 1λi−q\frac{1}{\lambda_i-q}。

其伪代码为:

Alt text